^^
Вспомнилось в связи с интересной статьёй на arXiv - Self Improvement via Fast Tree-search
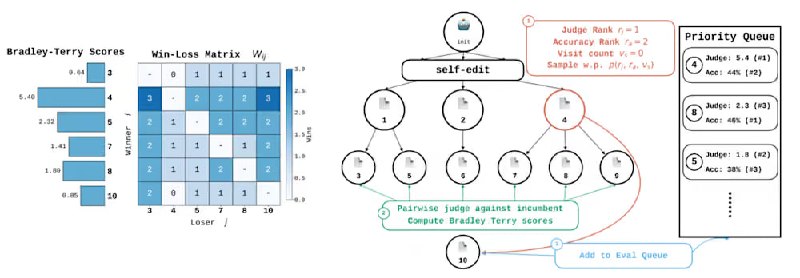
Там про SIFT (Self-Improvement via Fast Tree-search) — подход к автоматическому улучшению harness программного ИИ-агента, то есть кода и инструкций, которые организуют работу базовой языковой модели. Система создаёт новые варианты этой обвязки: меняет инструкции, добавляет инструменты, корректирует обработку ошибок и порядок запуска тестов, после чего проверяет, какие изменения действительно повышают результативность. Главная проблема такого поиска не столько в создании новых вариантов, сколько в их проверке: полноценный прогон каждого harness на большом наборе задач быстро начинает потреблять основную часть времени и вычислительных ресурсов.
В SIFT между созданием нового варианта и его полной проверкой добавляется быстрый промежуточный этап. Отдельная языковая модель попарно сравнивает реализации harness и определяет, какая из них с большей вероятностью будет работать лучше. Она не заменяет реальные тесты и не пытается точно предсказать итоговый результат, а помогает выстроить относительный порядок кандидатов. Результаты сравнений объединяются в общий рейтинг с помощью модели Bradley–Terry, после чего поиск направляется в наиболее перспективные ветви. Создание новых вариантов и их полные проверки выполняются параллельно: если версия прошла небольшую предварительную проверку и получила высокий рейтинг, от неё можно продолжать развитие, не дожидаясь завершения длительных тестов.
Модель-оценщик лучше различает кандидатов, когда видит итоговые версии изменённых файлов, а не только цепочку исправлений. При этом найденные улучшения harness не обязательно оказываются сложными: в одном из примеров полезным изменением стало простое требование запускать тесты после редактирования, получать структурированное описание ошибок и повторять исправления. Более сложный вариант с дополнительным анализатором тестов дальнейшего улучшения не дал. В результате SIFT разделяет поиск улучшений harness на два уровня: дешёвая предварительная оценка направляет поиск, а дорогая фактическая проверка подтверждает, действительно ли новый вариант работает лучше.
Разбор на английском:
https://venturebeat.com/orchestration/new-mit-and-sakana-ai-framework-uses-an-llm-judge-to-cut-evaluation-costs-for-self-improving-coding-agents
По сути это более сложный вариант того что я описал выше. Возможно более мощный, но сложность явно выше на два порядка.
Post #688
85
BOM Voyage Кстати, всё забываю поделиться лайфхаком. В своей работе (программирование) у меня есть следующий AI workflow для работы с повторяющимися проблемами: 1) В ходе работы над задачей агенты записывают какие их решения, действия были неудачными, не приблизили…