TGViewer
Channel Public Channel
Big Data AI

Big Data AI

@bigdatai

@haarrp - админ

Вопросы с собеседований по Machine Learning, Data Science, Deep Learning и Нейроннным сетям

@data_analysis_ml - анализ данных

@ai_machinelearning_big_data

@itchannels_telegram - важное для программиста

РКН: clck.ru/3Fmqxe
Subscribers
18.2K
Photos
1.2K
Videos
171
Links
1.2K

Showing posts older than #801 · Back to latest

Older Posts 14 shown
Post #799 2.8K
Мечта каждого мужчины

@bigdatai
  • ❤ 18
  • 🔥 5
  • 👍 3
  • 💩 2
  • 👎 1
Post #798 2.78K
🔥 Яндекс анонсировал Practical ML Conf — конференцию о практическом применении ML

Событие пройдет 14 сентября в Москве в пространстве «Суперметалл», для участия нужно зарегистрироваться и получить приглашение. Также будет доступна онлайн-трансляция докладов.

🟡 Узнать подробности и зарегистрироваться можно здесь.

@bigdatai
  • 👍 4
  • ❤ 1
Post #796 2.25K
🚀XR-среда: погружаемся в метавселенные вместе с Sber Metaverse Tech и СберМаркетингом

Представители крупных брендов расскажут, какие технологии используют для создания метавёрса, где его можно применять и как он помогает бизнесу.

Совсем скоро обсудим:

➡️детские тренды и взрослые бренды: как работать с молодой аудиторией метавселенных
➡️геймификацию HR: игровые механики в найме и развитии сотрудников
➡️как влюбить в хоккей с помощью Roblox: кейс «Метавселенная хоккея» от КХЛ
➡️Roblox: от разовых спецпроектов к глубокой интеграции

📆 Встречаемся 4 сентября в 11:00 по адресу Москва, Кутузовский проспект, д. 32Г

Вход бесплатный, но нужна предварительная регистрация.
  • 👍 2
  • 🔥 1
Post #795 2.28K
🖥 Text2SQL is Not Enough: Unifying AI and Databases with TAG

Генерация с расширением таблиц (TAG) - это унифицированная парадигма общего назначения для ответа на вопросы на естественном языке с использованием баз данных.

Text2SQL представляет широкий спектр взаимодействий между LM и базой данных, которые ранее не применялись в таких методах, как Text2SQL и RAG.

📚 Статья: https://arxiv.org/abs/2408.14717
🛠️ Код: https://github.com/tag-research/tag-bench

@bigdatai
arXiv.org Text2SQL is Not Enough: Unifying AI and Databases with TAG AI systems that serve natural language questions over databases promise to unlock tremendous value. Such systems would allow users to leverage the powerful reasoning and knowledge capabilities of...
  • 👍 3
  • ❤ 2
  • 🔥 2
Post #789 1.99K

Forwarded from Machinelearning

🌟LongVILA: Масштабирование VLM с длинным контекстом для обработки длинных видео.

LongVILA, полнофункциональное решение на основе LLaVA, разработанное NVLabs, для длинноконтекстных VLM, включающее программный набор, претрейн-моделей и разработку набора данных для обучения.

Программная реализация основывается на Multi-Modal Sequence Parallelism (MM-SP).
Это распределенный фреймворк для обучения и вывода, который предназначен для визуальных языковых моделей (VLM) с длинным контекстом. Он решает сложную задачу обработки огромных объемов данных и вычислений, необходимых для обучения и развертывания VLM на длинных видео.

Ядром MM-SP является двухэтапная стратегия шардинга и механизм 2D-внимания.
На первом этапе изображения равномерно распределяются по устройствам, обеспечивая сбалансированное кодирование изображений.
Второй этап включает в себя шардинг токенов уровня глобального зрения и текстовых входных данных с добавлением фиктивных токенов для совместимости с кольцевым вниманием.
Механизм 2D-внимания повышает эффективность в MM-SP, объединяя кольцевой стиль и стиль Улисса (Ulysses) последовательного параллелизма, используя внутриузловое общение All-2-All и межузловое общение P2P.

MM-SP распределяет вычислительную нагрузку по нескольким устройствам позволяя проводить обучение и вывод на чрезвычайно длинных последовательностях. Кроме того гибридная стратегия параллелизма минимизирует накладные расходы на связь еще больше улучшая пропускную способность обучения и сокращая время вывода.

Полный стек решения LongVILA расширяет число возможных кадров VILA в 128 раз (с 8 до 1024 кадров) и улучшает оценку аннотирования длинных видео с 2,00 до 3,26 (в 1,6 раза), демонстрируя 99,5% точности в 1400-кадровом видео (длина контекста 274k).

Претрейн модели основаны на Llama-3-8B и предназначены для рассуждений с использованием нескольких изображений и имеют навык визуальной цепочки мышления.
Опубликованы 3 модели:

🟢Llama-3-LongVILA-8B-128Frames;
🟢Llama-3-LongVILA-8B-256Frames;
🟢Llama-3-LongVILA-8B-512Frames.

Эти модели были обучены на 53 миллионах пар "изображение-текст" и могут быть развернуты на конечных устройствах от Jetson Orin для FP16 версий до потребительских ноутбуков в квантованной 4-bit размерности через TinyChat.


📌Лицензирование кода : Apache 2.0 license.

📌Лицензирование моделей: CC-BY-NC-SA-4.0 license.


🟡Arxiv
🟡Набор моделей
🖥Github [ Stars: 1.2K | Issues: 33 | Forks: 92]


@ai_machinelearning_big_data

#AI #NVLab #VLM #ML
  • 👍 3
  • ❤ 1
  • 🔥 1
Post #784 1.93K

Forwarded from Machinelearning

🌟Zamba2-mini: компактная и производительная модель с гибридной архитектурой.

Zamba2-mini - гибридная модель c 1.2B параметров, построенная из блоков state-space Mamba (SSM) и transformer.

Модель создана на общей архитектуре Zamba, но отличается от большей модели 2.7B тремя особенностями:

🟢добавлены rotary position embeddings;

🟢чередующиеся трансформерные блоки заменены одним общим;

🟢вместо LoRA на блоке MLP добавлены проекторы LoRA в блоки внимания.

Zamba2-mini использует токенизатор Mistral v0.1 и была предварительно обучена на 3 триллионах токенов текстовых данных и коде различных языков программирования, полученных из открытых веб-наборов данных, к которым был добавлен собственный корпу данных Zyda.

Впоследствии, на втором этапе Zamba2-mini была подвергнута дополнительной фазе агрессивного снижения скорости обучения на смеси из 100B высококачественных токенов.

Zamba2-mini показала в тестах результаты, сопоставимые с моделями с параметрами <2B и может конкурировать с некоторыми LLM большего размера.

Благодаря уникальной гибридной архитектуре SSM Zamba2-mini демонстрирует низкие задержки логического вывода и быструю генерацию при значительно меньшем потреблении VRAM, чем другие модели такой же плотности параметров на основе трансформеров.
Такие характеристики делает ее идеальной универсальной моделью для приложений на устройствах.

⚠️ Примечание: Zamba2-mini еще не полностью совместима со всеми фреймворками и инструментами HuggingFace.

Реализацию Zamba2-1.2B для Pytorch можно найти здесь.

▶️Локальная установка и инференс:

# Clone repositiry
git clone https://github.com/Zyphra/transformers_zamba2.git

#Install requirments:
cd transformers_zamba2
pip install -e .
pip install accelerate

#Inference
from transformers import AutoTokenizer, AutoModelForCausalLM
import torch

tokenizer = AutoTokenizer.from_pretrained("Zyphra/Zamba2-1.2B")
model = AutoModelForCausalLM.from_pretrained("Zyphra/Zamba2-1.2B", device_map="cuda", torch_dtype=torch.bfloat16)

input_text = "A funny prompt would be "
input_ids = tokenizer(input_text, return_tensors="pt").to("cuda")

outputs = model.generate(**input_ids, max_new_tokens=100)
print(tokenizer.decode(outputs[0]))


▶️Для запуске на CPU - only, укажите use_mamba_kernels=False при загрузке модели с помощью AutoModelForCausalLM.from_pretrained.


📌Лицензирование : Apache 2.0 License.


🟡Страница проекта
🟡Arxiv
🟡Модель


@ai_machinelearning_big_data

#AI #SLM #Mamba #ML #Zamba2mini
  • 👍 5
  • ❤ 1
  • 🔥 1
Post #782 2.31K
⚡️ GitHub запускает Copilot Autofix для автоматического устранения ошибок в коде.

▪Инструмент анализирует код и предлагает решения для исправления ошибок, используя ИИ Copilot от GitHub, аналитический движок CodeQL и GPT-4.

▪Бета-тестирование показало, что инструмент сокращает время на поиск и устранение уязвимостей в три раза и более.

▪Например, вручную исправление ошибок XSS обычно занимает три часа, а с помощью Copilot Autofix это удалось сделать за 22 минуты. Время исправления дефектов SQL-инъекций сократилось с 4 часов до 18 минут.

Все это станет доступно бесплатно с сентября 2024 года для всех проектов с открытым исходным кодом, размещенных на платформе.

https://github.blog/news-insights/product-news/secure-code-more-than-three-times-faster-with-copilot-autofix/

@bigdatai
  • ❤ 11
  • 🔥 4
  • 👍 2
  • 👾 1
Post #780 2.56K
Трансформеры js py 🤗.

Используйте Transformers.js в Pyodide и основанных на Pyodide фреймворках, таких как JupyterLite, stlite (Streamlit), Shinylive (Shiny for Python), PyScript, HoloViz Panel и так далее.

Оригинальный Transformers нельзя использовать в браузерной среде. Transformers.js - это JavaScript-версия Transformers, которая может работать в браузерах.

Этот пакет представляет собой обертку Transformers.js, чтобы проксировать его API в Pyodide.

https://github.com/whitphx/transformers.js.py

@bigdatai
GitHub GitHub - whitphx/transformers.js.py Contribute to whitphx/transformers.js.py development by creating an account on GitHub.
  • ❤ 5
  • 👍 2
  • 🔥 2
Post #779 3.05K
pandas_cheatsheet.pdf2.6 MB
🖥 Полезная шпаргалка по Pandas

В этой шпаргалке вы найдёте несколько страниц полезных шпаргалок по базовым командам и конкретным задачам.

#шпаргалка #pandas

@bigdatai
  • 👍 8
  • ❤ 3
Post #778 3.24K
🌟 Виртуального ассистента Алису научили общаться более эмоционально

Помощник Яндекса получил большой спектр новых эмоций, которые может выражать голосом в общении исходя их контекста. Среди них — дружелюбие, любопытство, удивление, сочувствие, обида и грусть.

Для обучения Алисы команда использовала модель эмоционального синтеза речи, которую подробно разобрала в статье на Хабре. Обновленная Алиса доступна в Станциях Лайт 2, а чуть позже появится и в других устройствах.

▪️ Хабр

@bigdatai
  • 🔥 7
  • ❤ 4
  • 👍 4
  • 💩 3
  • 😁 1
Post #777 2.74K
🖥 Crossed - это сверхвысокопроизводительная встраиваемая и серверная СУБД.

Она разработана для высокопроизводительных сценариев, когда в основной памяти может храниться вся база данных.

Особенности
- Поддержка нескольких ОС: Linux / Windows / macOS / FreeBSD и т.д
- Поддержка ARCH с несколькими процессорами: X86 / ARM / PPC / MIPS и т.д.
- Поддержка OnDisk / In-memory / RamDisk / гибридного хранилища
- Поддержка стандартной модели СУБД
- Поддержка MySQL
- Поддержка нескольких баз данных
- Поддержка хэширования и индекса RBTREE(TBD)
- Поддержка многоколоночного индекса
- Поддержка точного совпадения,
- Поддержка WALL для хранения данных на диске (TBD)
- Поддержка многопоточного доступа и доступа к нескольким процессам
- Поддержка блокировки чтения и записи на уровне таблиц
- Поддержка MVCC для чтения и записи
- Поддержка встроенной оболочки CrossDB
- Поддержка API с несколькими статусами
- Поддержка готовых API-интерфейсов Statments
- Сверхвысокая производительность
- Zero Config: никакой сложной конфигурации, все как из коробки

make
make install


▪ Github

@bigdatai
  • 👍 4
  • ❤ 2
  • 🔥 1
Post #773 2.4K

Forwarded from Machinelearning

🌟 Clapper: Альфа-версия комбайна для визуализации генеративных сценариев.

Clapper - это инструмент визуализации историй, разрабатываемый как пет-проект сотрудником Huggingface Julian Bilcke

Созданный год назад, Clapper не предназначен для замены традиционных видеоредакторов или AI-редакторов, использующих 3D-сцены в качестве исходного материала.
Философия Clapper заключается в том, чтобы каждый мог создавать видео с помощью GenAI-инструментов посредством интерактивного, итеративного и интуитивного процесса, без необходимости использования разных интерфейсов, навыков режиссуры или AI-инженерии.

В Clapper вы не редактируете последовательность видео- и аудиофайлов напрямую, а итерируете (с помощью вашего помощника ИИ) свою историю, используя высокоуровневые абстракции, такие как персонажи, места, погода, временной период, стиль и т. д.

Конечной целью проекта заявлен полностью режиссерский режим, с которым вы можете просто перевести видео в полноэкранный режим, удобно расположиться в режиссерском кресле (или на диване) и, произнося голосом команды своему AI-ассистенту для создания вашего фильма, насладитесь созданным лично Вами шедевром.

⚠️ Это альфа-версия инструмента, который разрабатывают 3 человека. Не стоит ожидать от этого открытого проекта революционных результатов.

Clapper поддерживает интеграцию по API с локальными системами (ComfyUI) и он-лайн сервисами:
HuggingFace, Replicate, ComfuICU, FalAI, ModelsLab, OpenAI, Groq, Google, Anthropic, Cohere, MistralAI, StabilityAI, ElevenLabs, KitsAI.

Проект написан на TypeScript. Необходимые условия перед установкой:

🟠Git LFS;
🟠Bun;
🟠NVM;
🟢Версия Node - 20.15.1.

▶️Установка и запуск:
# Install the dependencies:
# --include=optional to make
# sure deps are installed
bun i

# build the app:
npm run build

# Running the web app:
bun run dev
# first time you go to localhost:3000
# Wait around 1 minute, the app will compile


▶️Второй вариант запуска, с Electron (еще в процессе разработки):
cd packages/app
bun run electron:start

# You can also build Clapper:
cd packages/app
bun run electron:make


📌Лицензирование : GPL v3 licenсe.


🟡Сообщество в Discord
🟡Demo
🖥Github [ Stars: 1.5K | Issues: 15 | Forks: 129]


@ai_machinelearning_big_data

#AI #Storytelling #Clapper #Visialtool
  • 👍 5
  • ❤ 2
  • 🔥 2
Post #772 2.45K
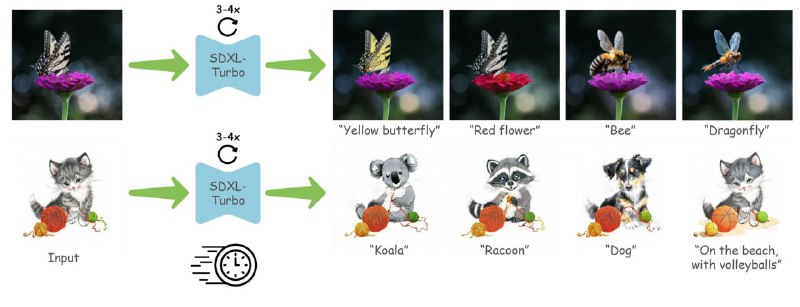
⚡️ TurboEdit обеспечивает быстрое редактирование изображений на основе текста всего за 3-4 шага!

Модель улучшает качество редактирования изображений, которое сохраняет исходное изображение за счет использования смещенного алгоритма шумов и метода псевдонаправления, устраняя такие проблемы редактирования, как визуальные артефакты и слабые места при редактировании.

https://turboedit-paper.github.io

@bigdatai
  • 👍 6
  • ❤ 3
  • 🔥 2
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →