TGViewer
Channel Public Channel
Big Data AI

Big Data AI

@bigdatai

@haarrp - админ

Вопросы с собеседований по Machine Learning, Data Science, Deep Learning и Нейроннным сетям

@data_analysis_ml - анализ данных

@ai_machinelearning_big_data

@itchannels_telegram - важное для программиста

РКН: clck.ru/3Fmqxe
Subscribers
18.2K
Photos
1.2K
Videos
171
Links
1.2K

Showing posts older than #419 · Back to latest

Older Posts 20 shown
Post #417 2.4K
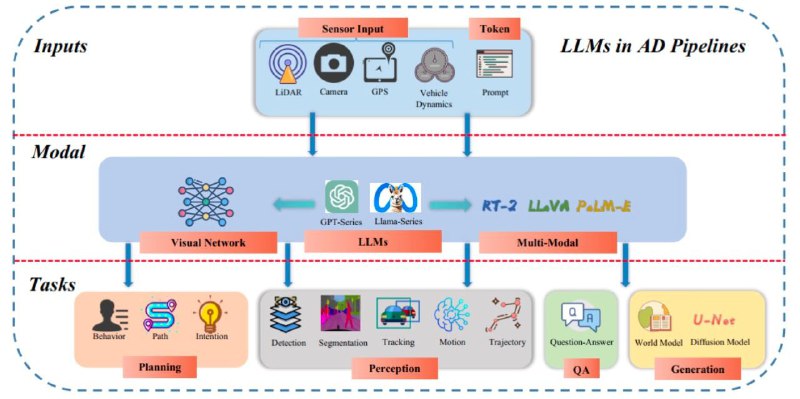
Awesome-LLM4AD

Список интересных ресурсов, посвященных LLM для автономного вождения (постоянно обновляется).

🐱 GitHub

@bigdatai
  • ❤ 7
  • 👍 1
Post #413 2.97K
🔥 Дайджест полезных материалов из мира Больших данных за неделю

Почитать:
— Как автоматизировать проверки данных в Airflow с Great Expectations
— 5 уровней зрелости MLOps
— Лучшие ресурсы чтобы выучить Git и Github
— Персонализация тарифного плана для новых абонентов: как оцифровать привлекательность
— Деревья ltree в PostgreSQL – простым языком
— Лучшие практики Golang (20 лучших)
— How to install NVIDIA drivers for machine learning on Ubuntu
— Working through the fast.ai book in Rust - Part 1
— Why ChatGPT and other LLMs are overrated and won't take your job
— Demystifying Transformer Models: Unveiling the Magic of Natural Language Processing
— A Quick Look At Natural Language Generation (NLG)
— AI Log #2: What is a Cost Function in Machine Learning?
— The Next Generation of AI Developer Tools
— AI Development Guide 2024
— What is a Conditional Generative Adversarial Network?
— The State of Serverless GPU Part -2

Посмотреть:
🌐 Пишем генератор Shorts видео на Python для заработка на YouTube. (⏱ 11:50)
🌐 Озвучка и генерации контента с помощью #Python и AI (⏱ 00:44)
🌐 Замена лица на любой фотографии с помощью #python БЕСПЛАТНО! (⏱ 00:59)
🌐 Lightning Interview “Large Language Models: Past, Present and Future” (⏱ 01:00:00)
🌐 Thomas Scialom, PhD - Large Language Models: Past, Present and Future (⏱ 34:45)
🌐 Leveraging Generative AI in Education - A M Aditya (⏱ 31:24)
🌐 AI Art: How is This Quality Even Possible? (⏱ 05:29)

Хорошего дня!

#digest #bigdata

@bigdatai
  • 👍 4
  • ❤ 2
  • 🔥 2
Post #412 3.21K
⚡️ Глубокое обучение для отслеживания и обнаружения объектов

Коллекция статей, наборов данных, кода и других ресурсов, посвященных отслеживанию и обнаружению объектов с помощью глубокого обучения.

🔗 https://github.com/abhineet123/Deep-Learning-for-Tracking-and-Detection

@bigdatai
  • 👍 6
  • 🔥 3
  • ❤ 2
Post #411 3.11K
🔥Список открытых датасетов

Список открытых датасетов высокого качества для машинного обучения, временных рядов, НЛП, обработки изображений и т.д., ориентированный на конкретные темы.

🔗 https://github.com/awesomedata/awesome-public-datasets

@bigdatai
  • 👍 9
  • 🔥 4
  • ❤ 2
Post #410 3.28K
🔥 Дайджест полезных материалов из мира Больших данных за неделю

Почитать:
— Дежурный data-инженер: рабочие хроники
— RecTools – OpenSource библиотека для рекомендательных систем
— Проблема множественного тестирования на практике
— Введение в Apache Flink: осваиваем фреймворк на реальных примерах
— Data Mesh – ячеистые топологии для работы с данными
— Подбираем параметры сессии в Apache Spark, чтобы не стоять в очереди
— Как расширить компетенции аналитиков при работе с Big Data
— Жук, нумерология, хеш или ничо? Оптимизация работы с путями
— Выбор платформы и подрядчика для замены иностранного BI. На что нужно обратить внимание
— Руководство для начинающих по Spark UI: Как отслеживать и анализировать задания Spark
— Let's talk bout Linear-Algebra and ML
— Navigating AWS HIPAA Compliance: A Comprehensive Analysis
— Monitoring Your Time Series Model in Comet
— Join us: Unleashing the Future of AI Development with ViewML. AI Open Source Invention.
— The Hunger Games: Harnessing the Power of Emerging Technologies in Food Delivery App Development
— Building LangChain applications with Amazon Bedrock and Go - An introduction
— Standardizing the Data Using StandardScaler in ML
— Is Dictador's AI Robot CEO A Threat To Leadership Roles In The Business Landscape?
— Go for beginners
— Essential Features of Artificial Intelligence: A Thorough Synopsis

Посмотреть:
🌐 Задача с реального Python собеседования middle разработчика. Рекурсивная сумма. (⏱ 13:00)
🌐 Определение диабета при помощи машинного обучения в 60 строк кода! (⏱ 12:54)
🌐 Что такое vector в c++ (⏱ 00:51)
🌐 STL C++ стандартная библиотека (⏱ 00:57)
🌐 deque разбор в С++ (⏱ 00:58)
🌐 Последовательные контейнеры c++ List (⏱ 00:47)
🌐 Совет Python разработчикам - реши задачу Chain sum с реального собеседования. (⏱ 14:23)
🌐 Нейросеть для превращения #YouTube видео в презентацию (⏱ 00:28)
🌐 🔥 NVIDIA только что сделала Pandas в 150 раз быстрее без изменений кода. #python (⏱ 00:20)
🌐 Applied Reinforcement Learning for Online Ads/Recommender - Kevin Noel (⏱ 42:37)
🌐 Sarah Bird, PhD - Building and Using Generative AI Responsibly: Microsoft’s Journey (⏱ 30:11)
🌐 The Ethics Of Digital Minds with Professor Nick Bostrom (⏱ 57:03)
🌐 Nick Bostrom, PhD - The Ethics of Digital Minds: A baffling new frontier (⏱ 36:28)
🌐 ML on-device: Building Efficient Models - Danni Li (⏱ 34:00)
🌐 Creating Virtual Worlds 20x Faster! (⏱ 06:08)
🌐 NVIDIA’s New AI: Wow, 8x Better Text To 3D! (⏱ 04:27)
🌐 OpenAI's ChatGPT: 7 Unexpected Results! (⏱ 08:57)

Хорошего дня!
  • ❤ 6
  • 👍 2
  • 🔥 1
Post #407 3.15K
⚡️ GPT-4V теперь может говорить и объяснять, что он видит.

SoM накладывает на изображения несколько пространственных и "говорящих" знаков (например, маски и идентификаторы ссылок), чтобы раскрыть возможности и получить обоснования от больших мультимодальных моделей (БММ).

https://github.com/roboflow/awesome-openai-vision-api-experiments

@bigdatai
  • 🥰 7
  • ❤ 3
  • 👍 1
Post #405 3.02K
🏎 Awesome Autonomous Vehicles

Основы, курсы, доклады, исследовательские лаборатории, наборы данных, программное обеспечение с открытым исходным кодом, аппаратное обеспечение, игрушки, компании, СМИ и законы, связанные с автономными транспортными средствами.

🐱 GitHub
  • ❤ 6
  • 👍 3
  • 🔥 1
Post #403 2.74K
👀 Интересный подкаст о создании высокодетализированных Яндекс Карт

Технический директор и продакт-менеджер сервиса пришли в новый выпуск Yet Another Podcast и рассказали, какие данные использовались для создания карт нового поколения, чем новые карты отличаются от прежних и какие пользовательские проблемы решает обновление. А еще обсудили, что теперь общего у Карт и игр Need For Speed и GTA.

Смотреть

@bigdatai
  • 👍 7
  • 🤮 2
  • ❤ 1
  • 🔥 1
Post #402 3.57K
Бесплатные онлайн-курсы от Массачусетского технологического института:

1. Computational Thinking and Data Science
https://edx.org/course/introduction-to-computational-thinking-and-data-4?index=product_value_experiment_a&queryID=b2c2e9283643f3c30529b34d69556b9c&position=9

2. Computer Science and Programming Using Python
https://edx.org/course/introduction-to-computer-science-and-programming-7?index=product_value_experiment_a&queryID=85d79cec1ab147c466872f2cf1d26fd0&position=12

3. Cybersecurity for Critical Urban Infrastructure
https://edx.org/course/cybersecurity-clinic

4. Machine Learning with Python
https://edx.org/course/machine-learning-with-python-from-linear-models-to

5. Becoming an Entrepreneur
https://edx.org/course/becoming-an-entrepreneur

@bigdatai
  • 🔥 10
  • ❤ 2
  • 👍 1
Post #401 2.77K
🚀 Набор данных Grounding-anything Dataset (GranD)

Grounding Large Multimodal Model (GLaMM) - это сквозная обучаемая LMM, которая обеспечивает возможности визуального обоснования с функциями обработки как изображений, так и текста.

Grounding Large Multimodal Model позволяет решать новую унифицированную задачу генерации обоснованных разговоров, которая объединяет в себе обоснование фраз, сегментацию референтных выражений и разговоры на языке зрения. Обладая

проект: https://mbzuai-oryx.github.io/groundingLMM/
abs: https://arxiv.org/abs/2311.03356


@bigdatai
  • 👍 4
  • ❤ 2
  • 🔥 1
Post #400 3.44K
"Я боюсь не того Data Scientist'а, который один раз поработал с 10 000ми простых датасетов.

Я боюсь того Data Scientist'а, который 10 000 раз поработал с одним ужасным датасетом".

-- Брюс Ли

@bigdatai
  • ❤ 30
  • 😁 12
  • 👍 3
  • 💯 1
Post #398 3.2K
Математика для глубокого обучения 🧑‍🎓

Лучший ресурс для изучения математических концепций для лучшего понимания концепций машинного обучения и глубокого обучения:

http://d2l.ai/chapter_appendix-mathematics-for-deep-learning/index.html

@bigdatai
  • 👍 10
  • 🔥 4
  • ❤ 1
Post #396 3.05K
Как устроены языки Java, C++ и Python?

▪️Java сначала компилирует исходный код в байткод, который не зависит от платформы и выполняется виртуальной машиной Java (JVM). JVM может дополнительно повысить производительность, используя компиляцию Just-In-Time (JIT) для преобразования байткода в машинный код во время выполнения.

▪️Компилируемые языки, такие как C++ и Go, перед выполнением преобразуют исходный код в машинный код с помощью компилятора. Скомпилированный машинный код затем может непосредственно выполняться процессором.

▪️Интерпретируемые языки, такие как Javascript и Ruby, не подвергаются компиляции. Вместо этого их код построчно обрабатывается интерпретатором во время выполнения. Однако современные движки JavaScript, такие как V8, также используют JIT-компиляцию для повышения производительности.

▪️Python представляет собой смесь двух миров. Сначала исходный код компилируется в платформонезависимый байткод, который затем построчно выполняется платформонезависимым интерпретатором. Кроме того, такие реализации, как PyPy, используют JIT-компиляцию для повышения скорости работы.

В целом компилируемые языки обладают преимуществами в скорости, однако благодаря современным методам оптимизации грань между компилируемыми и интерпретируемыми языками становится все более размытой.

@bigdatai
  • 👍 14
  • 🔥 3
  • ❤ 2
  • 👎 1
Post #394 2.95K
Возможно, Microsoft только что раскрыла "секретное" количество параметров GPT 3.5 в своем документе CodeFusion.

Достижение такого качества чата с параметром 20B очень впечатляет.

https://arxiv.org/abs/2310.17680

@bigdatai
  • 👍 8
  • ❤ 2
  • 🔥 1
Post #393 3.29K
🚀 TF Quant Finance: TensorFlow based Quant Finance Library

Библиотека TensorFlow Quant Finance от Google.

Функциональные возможности включают:

- Блэка-Шоулза: Цена и предполагаемый объем
- Монте-Карло по схеме Эйлера
- Подгонка своп-кривой

git clone https://github.com/google/tf-quant-finance.git

▪Github

@bigdatai
  • ❤ 7
  • 👍 2
  • 🔥 1
Post #392 3.26K
🔥 Дайджест полезных материалов из мира Больших данных за неделю

Почитать:
— MLOps-инструменты, обзоры рынка и тренды потоковой обработки данных
— Рынок данных в даркнете: как купить чужие данные и не потерять свои
— 12 лучших инструментов аннотирования изображений на 2023 год
— Без работы не останемся: к 2030 году ИИ добавит семь новых профессий
— Почему важна разметка данных: в основе ChatGPT лежит труд людей
— «Большие вызовы» в «Сириусе», или как мы обычно проводим лето
— why learn web (javascript) ML(machine learning) 2024
— Getting Started with Machine Learning: A Beginner's Guide
— La IA
— The Hydra of Machine Learning: Understanding Multi-headed Attention
— Interpreting Loan Predictions with TrustyAI: Part 1
— BakaLLM, part 7: XL struggles are done, for now
— The Complete Guide to Time Series Models
— How to Land a Job as an AI Engineer 🤖
— How to train an Iris dataset classifier with Tinygrad
— Take your career to the next level: GitHub Universe create your own agenda

Посмотреть:
🌐 How to Get Ahead of 99% of Data Scientists (Tips from Tyler Richards) (⏱ 53:20)
🌐 Прогнозирование цены биткоина при помощи VAR, XGBoost, FB Prophet (⏱ 20:29)
🌐 Django настройка админки (⏱ 06:55)
🌐 Задача на палиндром строки на C++ (⏱ 00:59)
🌐 Django расширяем функционал! (⏱ 07:03)
🌐 Making Private Data Open and Enhancing Decision-Making through Digital Atlases (⏱ 28:27)
🌐 NVIDIA’s New AI: 20% Faster Game Graphics! (⏱ 04:58)
🌐 DALL-E 3 Is Now Free For Everyone! (⏱ 05:10)

Хорошего дня!
  • ❤ 6
  • 🔥 3
  • 👍 1
Post #390 3.43K
📱 Промпт-инжиниринг: как использовать LLM для создания приложений

Общие уроки
Промпт-инжиниринг — это в такой же степени экспериментирование, как и проектирование. Существует бесконечное количество способов написать промпт, начиная от формулировки конкретного вопроса и заканчивая введением информационного материала и уточнением контекста. Это может показаться невероятным, но я обнаружил, что проще всего начать с элементарного и довериться интуиции, а затем проверять гипотезы.

В компьютерном зрении каждый набор данных отличается своей схемой, типами меток и названием классов.
Хотя VoxelGPT предназначен для обработки любого набора данных путем компьютерного зрения, мы для начала взяли один датасет — MS COCO.
Сохранение всех дополнительных степеней свободы позволило в первую очередь закрепить способность LLM писать синтаксически корректные запросы.

Найдя решение, гарантирующее успех в ограниченном контексте, переходим к его обобщению и развитию.

Какую модель (модели) использовать?
Одной из самых важных характеристик больших языковых моделей считается их относительная взаимозаменяемость. Теоретически вы должны быть готовы заменить одну LLM на другую без существенных структурно-функциональных изменений.

Хотя это верно, что заменить LLM обычно так же просто, как изменить порядок API-вызовов, на практике возникают трудности.

▪️Некоторые модели обладают гораздо меньшей длиной контекста, чем другие. Переход на модель с меньшим контекстом может потребовать серьезного рефакторинга.
▪️Открытый исходный код — это здорово, но LLM с открытым исходным кодом (пока) не так производительны, как GPT-модели. Кроме того, при развертывании приложения с LLM с открытым исходным кодом нужно убедиться, что контейнер, в котором работает модель, имеет достаточно памяти и хранилища. Это может оказаться более хлопотным (и более дорогим), чем использование конечных API-точек.
▪️Переход с GPT-4 на GPT-3.5, осуществленный для снижения стоимости использования модели, может шокировать падением производительности. Для выполнения сложных задач с генерацией кода и получения выводов больше подойдет GPT-4.

Где использовать LLM?

Читать

@bigdatai
  • 👍 6
  • ❤ 2
  • 🔥 2
Post #389 3.15K
🔥 Дайджест полезных материалов из мира Больших данных за неделю

Почитать:
— Каталог данных — почему без него непросто и как всё организовать с максимальной пользой
— Эконометрическое моделирование трафика: зачем мы изучали влияние дождя и времени года на посещаемость магазинов
— Сравнение методов веб-скрепинга для данных Википедии: Beautiful Soup против WikipediaAPI
— Главное из книги Fundamentals of Data engineering — фундаментального труда о дата-инжиниринге
— Введение в библиотеку Diffusers и диффузионные модели
— Проблематика Open Source: профиль риска, лицензирование, как выбирать продукт и подход к разработке решений
— Применение нейросетевых подходов для формирования признаков в моделях
— О точности вычислений: как не потерять данные в цифровом шуме
— Рынок BI (Business intelligence) систем в России. Как рисуют рейтинги платформам?
— Milvus Adventures | October 13, 2023
— Exploratory Data Analysis with Data Visualization Techniques
— BakaLLM, p5: one stomp forward
— 👋 Devlog 12.10.23
— Machine learning use cases: making the world a better place 🦾
— Why kNN doesn't scale...
— AI Augmented Intelligence: The Fusion Of Human And Machine Artistry
— 🎉 My daily Devlog
— What Technologies are used to Build an AI Image generator? What is GAN Architecture?
— Benefits and Challenges of AIoT

Посмотреть:
🌐 Chatgpt, Bard , Claude, Theb - используй API лучших нейросетей бесплатно и без ВПН на Python. (⏱ 05:23)
🌐 NLP практика. Определяем тональность текста при помощи NLTK и DL (⏱ 19:37)
🌐 Django шаблонизация и маршрутизация (⏱ 09:11)
🌐 Задача, которая очень часто встречается на собеседованиях #python (⏱ 00:59)
🌐 Решение непростой задачи с Leetcode, часто всплывает на собеседования #pythontutorial (⏱ 00:59)
🌐 Хитрая задача с собеседования #Python (⏱ 00:59)
🌐 Lightning Interview "The Storied History of Video Games and AI" (⏱ 46:35)
🌐 Accelerate your AI/ML Initiatives and Deliver Business Value Quickly (⏱ 33:08)
🌐 Leveraging Generative AI in Education - A M Aditya (⏱ 31:24)
🌐 Unreal Engine 5.3 - Next Level Tech Is Coming! (⏱ 06:17)
🌐 Google’s New AI Watched 2,500 Videos! But Why? (⏱ 05:52)

Хорошего дня!

@bigdatai
  • 👍 8
  • ❤ 3
  • 🔥 2
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →