🚀Прорыв от Google: активное обучение с экономией данных на
10 000× при дообучении LLM
Google разработала масштабируемый процесс *active learning*, который позволяет в десятки тысяч раз сократить объём размеченных данных, необходимых для тонкой настройки больших языковых моделей на сложных задачах — например, при модерации рекламного контента.
🟢 Как работает метод:1.
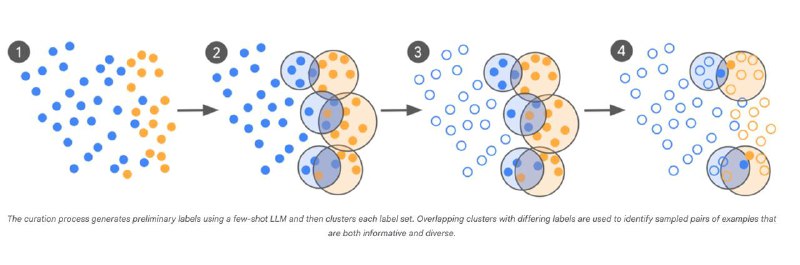
Стартовая модель (LLM-0) получает промпт и автоматически размечает огромный массив данных.
2.
Кластеризация выявляет примеры, где модель путается (наиболее спорные и ценные для обучения).
3.
Отбор данных: из этих кластеров выбирают информативные и разнообразные примеры.
4.
Экспертная разметка — только для выбранных примеров.
5.
Итерации: дообучение модели → новый отбор спорных примеров → разметка → снова обучение.
🟢Результаты:
- Сокращение с
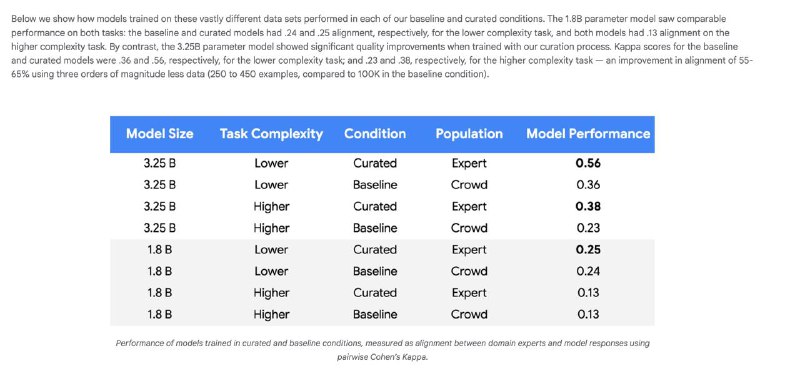
100 000 размеченных примеров до
менее 500 при сохранении или улучшении качества.
- Улучшение метрики *Cohen’s Kappa* на
55–65 %.
- В больших продакшн-моделях — до
3–4 порядков меньше данных при сопоставимом или лучшем качестве.
🟢
Что такое Cohen’s Kappa? Это метрика, которая показывает, насколько два "судьи" (например, эксперт и модель) согласны между собой
с поправкой на случайные совпадения.
- 0.0 — нет согласия (или хуже случайного)
- 0.41–0.60 — умеренное согласие
- 0.61–0.80 — значительное
- 0.81–1.00 — почти полное согласие
В задачах с дисбалансом классов Kappa даёт более честную оценку, чем обычная точность (accuracy).
Чем лучше предыдущих методов:
-
Точечная разметка: размечаются только самые информативные примеры.
-
Масштабируемость: метод применим к наборам данных с сотнями миллиардов примеров.
-
Экономия ресурсов: меньше времени и затрат на разметку.
-
Быстрая адаптация: подходит для доменов с быстро меняющимися правилами (реклама, модерация, безопасность).
🟢Вывод:
При умном отборе данных LLM можно адаптировать в тысячи раз быстрее и дешевле, чем при традиционном обучении на больших размеченных наборах.
#GoogleResearch #ActiveLearning #AI #LLM #MachineLearning #DataEfficiency
🟠
Почитать подробно @ai_machinelearning_big_data#GoogleResearch #ActiveLearning #AI #LLM #MachineLearning #DataEfficiency