



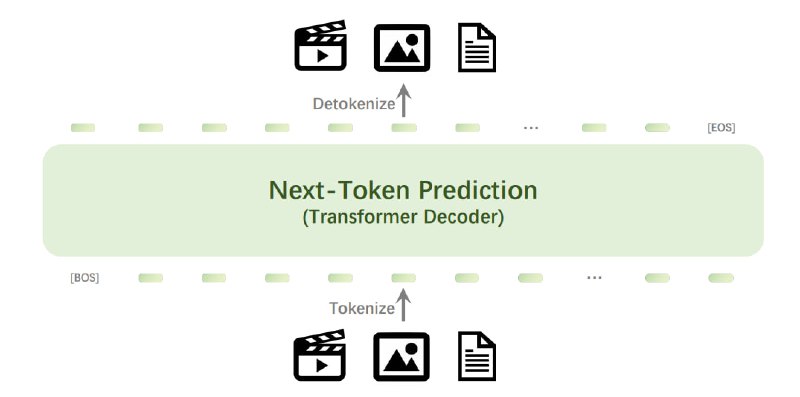
Модели Emu3 разработаны для задач мультимодальной генерации и восприятия: генерации изображений и видео по текстовому описанию, понимание визуальных представлений и прогнозирования кадров в видео.
Модель использует токенизатор изображений SBER-MoVQGAN для преобразования видео и изображений в дискретные токены, RMSNorm для нормализации, GQA для механизмов внимания, SwiGLU для активации и RoPE для позиционного кодирования.
Процесс генерации в Emu3 начинается с обработки моделью начальной последовательности токенов (например, текстовое описание для генерации изображения).
Затем Emu3 авторегрессивно предсказывает наиболее вероятный следующий токен в последовательности. Этот процесс продолжается до тех пор, пока не будет сгенерирована вся последовательность, представляющая собой конечный результат (изображение или видео).
▶️ Представлены 3 модели:
🟢Emu3-Chat – модель-чат, анализирует входные изображения и генерирует текстовые ответы;
🟢Emu3-Gen – модель для генерации изображений по текстовому описанию;
🟢Emu3-VisionTokenizer – токенизатор изображений для преобразования изображений и видео в дискретные токены.
Для обучения использовались наборы данных Aquila, LAION-High-Resolution, InternVid, MSCOCO-30K, GenEval, T2I-CompBench, DPG-Bench, SEED-Bench, RealWorldQA, OCRBench и VBench.
Результаты тестирования показывают превосходство Emu3 над SDXL в генерации и сопоставимость с LLaVA-1.6 в задачах интерпретаций изображений.
Инференс моделей пока доступен только в СLI на Transformers, примеры для генерации или описания входного изображения можно найти в репозитории проекта.
⚠️ Информации о технических требованиях по GPU разработчиками Emu3 не предоставлено.
▶️Локальная установка:
# Clone the repository
git clone https://github.com/baaivision/Emu3
cd Emu3

# Install requirements
pip install -r requirements.txt
📌Лицензирование : Apache 2.0 License.
🟡Страница проекта
🟡Коллекция моделей на HF
🟡Arxiv
🖥GitHub
@ai_machinelearning_big_data
#AI #ML #MMLM #Text2Video #Text2Image