

DiffusionGemma - экспериментальная языковая модель с открытыми весами, которая заимствовала подход из генерации изображений, где диффузионные модели превращают шум в картинку.
Модель построена на семействе Gemma 4, а сам механизм диффузии восходит к более ранней разработке Gemini Diffusion.
Под капотом MoE на 26 млрд общих и 3,8 млрд активных параметров. После квантования модель умещается в 18 ГБ VRAM.
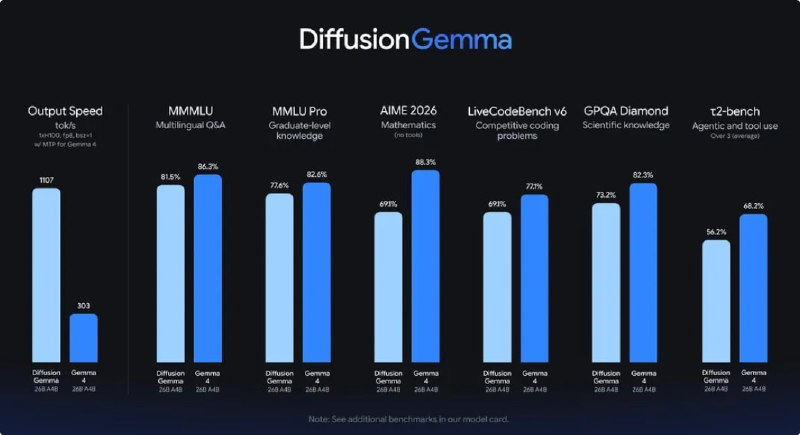
По словам Google, на одном GPU модель работает до 4 раз быстрее сопоставимой авторегрессионной модели.
Nvidia приводит около 1000 токенов в секунду на H100, 150 - на DGX Spark и до 800 - на DGX Station.
Google заявляет более 700 токенов в секунду на GeForce RTX 5090.
На устройствах с общей памятью (например на Apple Silicon) разница с обычными моделями, вероятно, окажется меньше, а в облаке с параллельными запросами преимущество вовсе исчезает - в этом сценарии диффузия может повышать издержки.
🟡За скорость приходится платить качеством
Для задач, где оно критично, Google по-прежнему рекомендует обычные модели Gemma 4, а DiffusionGemma позиционирует как инструмент для исследователей и разработчиков.
Сильной стороной компания называет задачи, не предполагающие строго последовательного порядка: вставку текста в готовый абзац, заполнение пропусков в коде, работу со структурированными данными.
🟡Доступность
Веса опубликованы на Hugging Face под Apache 2.0. Модель работает с Transformers, vLLM и MLX.
Запустить её можно также через Model Garden и Nvidia NIM, а бесплатно потестить на build.nvidia.com.
Для дообучения предлагаются собственный JAX-тулбокс Hackable Diffusion, Unsloth и NeMo от Nvidia.
Google собрала руководство для разработчиков, а Маартен Гроотендорст - визуальное объяснение работы модели.
@ai_machinelearning_big_data
#news #ai #ml