🛠️ Интересное исследование от IBM Research
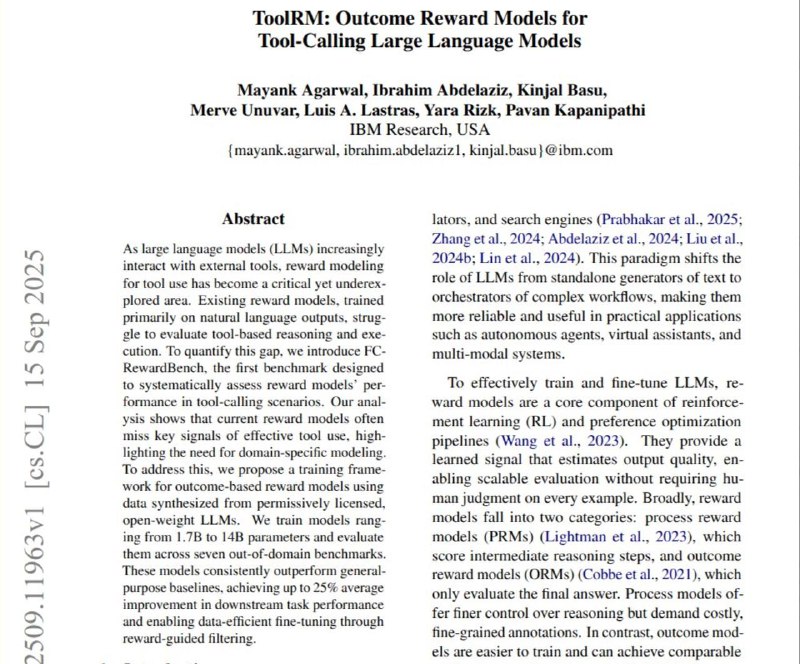
Учёные предложили способ сделать использование инструментов LLM точнее с помощью специального «судьи» для вызовов функций.
✨ Что не так сейчас
Обычные модели-судьи оценивают только текст, а не сами вызовы. Поэтому они не замечают ошибки:
- неправильное имя инструмента,
- неверные или пропущенные параметры,
- лишние вызовы.
⚡️ Что сделали
- Создали датасет из 1,500 запросов, где для каждого есть один правильный и один ошибочный вызов.
- Обучили ToolRM — reward-модель, которая смотрит на список инструментов, диалог и вызов, и выдаёт оценку качества.
- ToolRM превзошёл обычные reward-модели и даже крупные LLM-судьи, оставаясь при этом эффективным.
🧩 Как это работает
- Генератор делает несколько кандидатов-вызовов.
- ToolRM оценивает их и выбирает лучший.
- Этот подход помогает и маленьким, и большим моделям делать точные вызовы.
📊 Бонус: ToolRM может фильтровать тренировочные данные, оставляя качественные примеры. Благодаря этому даже модели, обученные на меньших выборках, показывают уровень, сопоставимый с полными данными.
🔗 Подробнее: arxiv.org/abs/2509.11963v1
Post #1521
1.89K
- ❤ 3
- 🔥 3
- 👍 1