💥Комбо Python и SQL в FugueSQL: единый SQL-интерфейс для датафреймов Pandas, Spark и Dask
FugueSQL - это открытая Python-библиотека, которая позволяет комбинировать Python-код с SQL-командами, переключаясь между ними в Jupyter Notebook или Python-скрипте. FugueSQL поддерживает распределенные вычисления и предоставляет унифицированный API для запуска одного и того же кода SQL в Pandas, Dask и Apache Spark.
В отличие от PandaSQL, который имеет единственный сервер SQLite, что приводит к большим накладным расходам при передаче данных между Pandas и базой данных, FugueSQL поддерживает несколько локальных бэкендов: pandas, DuckDB и SQLite.
При использовании pandas-бэкэнда Fugue напрямую переводит SQL в операции pandas, исключая передачу данных. DuckDB имеет превосходную поддержку pandas, поэтому накладные расходы на передачу данных незначительны. И Pandas, и DuckDB являются предпочтительными серверными модулями FugueSQL для локальной обработки данных. Fugue также поддерживает Spark, Dask и cuDF (через blazingSQL) в качестве бэкэндов.
В Fugue код SQL анализируется с помощью ANTLR и сопоставляется с эквивалентными функциями в API Fugue. FugueSQL имеет множество встроенных возможностей и расширяется с помощью Python-кода. По умолчанию он поддерживает наиболее распространенные на практике функции: заполнение значений NULL, удаление значений NULL, переименование столбцов, изменение схемы и пр. Fugue также добавляет некоторые улучшения в стандартный SQL, чтобы изящно обрабатывать сквозные рабочие процессы данных. Например, создание промежуточных таблиц через присвоение переменных.
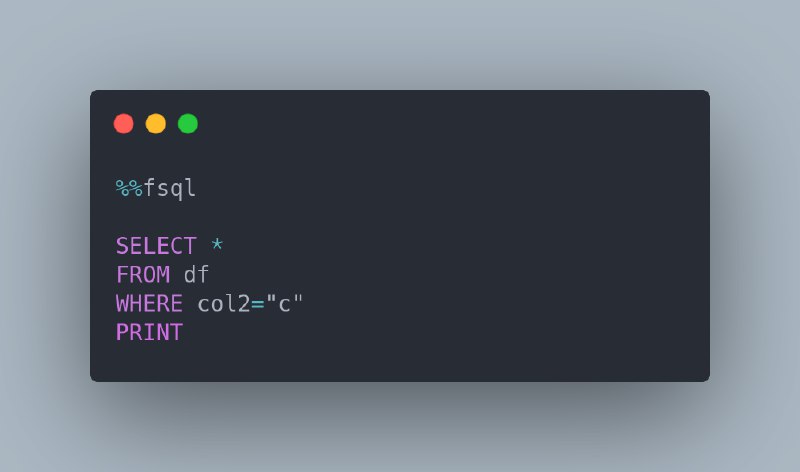
В Pandas %% fsql принимает NativeExecutionEngine в качестве параметра по умолчанию. В Dask работа FugueSQL чуть медленнее нативного движка, но более полна с точки зрения реализованных ключевых слов SQL. FugueSQL также работает на Spark, сопоставляя операции %%fsql с операциями Spark и Spark SQL. Это позволяет быстро разрабатывать распределенные приложения. Достаточно создать локальный прототип с помощью NativeExecutionEngine, протестировать его и развернуть в кластере Spark, просто изменив механизм выполнения.
https://towardsdatascience.com/introducing-fuguesql-sql-for-pandas-spark-and-dask-dataframes-63d461a16b27
https://fugue-tutorials.readthedocs.io/tutorials/fugue_sql/index.html
Post #168
438