👻SimVLM от Google AI: предварительное обучение визуальной языковой модели со слабым контролем
Визуальное моделирование языка включает понимание языка на визуальных входах, которые могут быть полезны для разработки продуктов и инструментов. Например, модель подписи к изображениям генерирует описания на естественном языке на основе понимания сути изображения. За последние несколько лет был достигнут значительный прогресс в визуальном моделировании языка благодаря внедрению технологии VLP (Vision-Language Pre-training).
Этот подход направлен на изучение единого функционального пространства сразу из визуальных и языковых входов. Для этой цели VLP часто использует детектор объектов, например, Faster R-CNN, обученный на наборах данных маркированных объектов для выделения областей интереса, полагаясь на подходы, специфичные для конкретной задач и совместного изучения представления изображений и текстов. Такие подходы требуют аннотированных датасетов или времени для их маркировки, а поэтому менее масштабируемы.
Для решения этой проблемы исследователи Google AI предлагают минималистичный и эффективный VLP под названием SimVLM (Simple Visual Language Model). SimVLM обучается от начала до конца с единой целью, аналогичной языковому моделированию, на огромном количестве слабо выровненных пар изображение-текст, т.е. текст в паре с изображением не обязательно является точным описанием картинки.
Простота SimVLM обеспечивает эффективное обучение на таком масштабируемом наборе данных, помогая модели достичь высочайшего уровня производительности по шести тестам на языке визуализации. Кроме того, SimVLM включает унифицированное мультимодальное представление, которое обеспечивает надежную кросс-модальную передачу без точной настройки или с тонкой настройкой только для текстовых данных, в т.ч. визуализацию ответов на вопросы, подписи к изображениям и мультимодальный перевод.
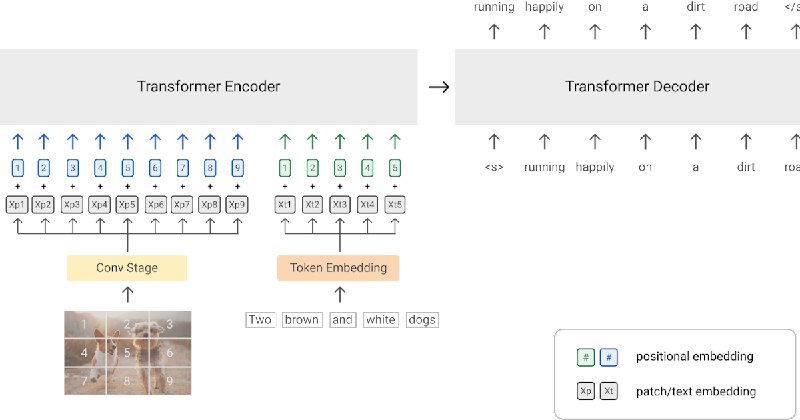
В отличие от BERT и других методов VLP, которые применяют процедуры предварительного обучения, SimVLM принимает структуру от последовательности к последовательности и обучается с помощью целевой модели языка с одним префиксом (PrefixLM), которая получает ведущую часть последовательность (префикс) в качестве входных данных, затем предсказывает ее продолжение. Например, для последовательности «Собака гонится за желтым мячом» последовательность случайным образом усекается до префикса «Собака гонится», и модель предсказывает ее продолжение. Концепция префикса аналогичным образом применяется к изображениям, где изображение делится на ряд «фрагментов», подмножество которых последовательно подается в модель в качестве входных данных. В SimVLM для мультимодальных входных данных (изображений и их подписей) префикс представляет собой конкатенацию последовательности фрагментов изображения и последовательности текста префикса, полученных кодером. Затем декодер предсказывает продолжение текстовой последовательности.
Благодаря этой идее, SimVLM максимизирует гибкость и универсальность в приспособлении ML-модели к различным настройкам задач. А успешно проверенные в BERT и ViT, архитектура трансформеров позволяет модели напрямую принимать на вход необработанные изображения. Также здесь применяется этап свертки из первых трех блоков ResNet, чтобы извлечь контекстуализированные патчи, что более выгодно, чем наивная линейная проекция исходной модели ViT.
Модель предварительно обучена на крупномасштабных наборах данных с изображениями и текстами. В качестве обучающего датасета использовался ALIGN, содержащий около 1,8 млрд зашумленных пар изображение-текст. Для текстовых данных использовался набор данных Colossal Clean Crawled Corpus (C4) из 800G веб-документов. Тестирование SimVLM показало успешность этой ML-модели даже без контролируемой точной настройки. SimVLM смогла качества субтитров, близкого результатам контролируемых методов.
https://ai.googleblog.com/2021/10/simvlm-simple-visual-language-model-pre.html
Post #132
413