TGViewer
Channel Public Channel
ML-легушька

ML-легушька

@bdatasciencem

Гений, стартапер, плейбой, филантроп
Для связи: @MLfroge
Subscribers
3.74K
Photos
1.5K
Videos
174
Links
99

Showing posts older than #3138 · Back to latest

Older Posts 15 shown
Post #3137 5.34K
  • ❤ 52
  • 🍾 3
Post #3136 4.23K
  • 🤣 48
  • ❤‍🔥 11
  • 🤔 8
  • ❤ 3
  • 👍 3
Post #3135 4.37K
  • 😁 63
  • 🔥 8
  • ❤ 5
  • 🍾 3
  • 👨‍💻 1
Post #3134 6.67K
  • 😁 51
  • ❤ 8
  • 🍾 6
  • ❤‍🔥 2
Post #3133 3.71K
  • ❤ 20
  • 😁 11
Post #3132 4.68K
Открылась регистрация на летнюю школу «Нейробиология внимания и памяти».
Школу проводит лаборатория системной организации нейронов ИТЭБ РАН, это отличная возможность ознакомиться погрузиться в нейробиологию как с биологической, так и с биофизической стороны, а если вы обладаете навыками программирования - то научиться прогать мат.модели нейронного взаимодействия.
Я в этом году снова буду членом орг.комитета, мы все постараемся сделать школу продуктивной, интересной и веселой.
Подача заявок до 18 мая, успейте :) Всем удачи.
Сайт школы с доп информацией
Пост про отбор на школу
  • ❤ 11
  • 🤮 4
  • 🤡 1
Post #3131 3.8K
  • 🙏 57
  • 🤣 12
  • 🤡 10
  • ❤ 6
  • 🔥 3
Post #3130 4.41K
  • 🌭 42
  • ❤ 8
  • 😱 4
  • 😭 3
  • 💩 2
Post #3129 4.19K
Лайк если ездишь на конференции по ИИ потому что там у крутых чуваков нет выбора и им приходится делать фотки с таким низкохиршевым ученым как ты
  • 😁 87
  • 👍 9
  • 💅 5
  • ❤‍🔥 1
  • 🤡 1
Post #3128 4.49K
Думайте + мы живем в обществе + шад + сколтех + нму + техносфера + фкн вшэ + визионер + СТО эт шараганейм
  • 💅 63
  • 🔥 11
  • 🤡 9
  • 💩 2
  • 🤮 1
Post #3127 5.6K
Мне с этого абсурда ОЧЕНЬ СМЕШНО
  • 🙏 28
  • 🤣 15
  • 🔥 8
  • 🌚 6
  • ❤ 3
Post #3126 4.42K
Мама мне картинку нарисовала…
  • ❤ 116
  • 🔥 22
  • 👏 12
  • 🥰 4
  • 👍 1
Post #3125 4.44K
  • 🔥 65
  • ❤ 20
  • 👍 6
  • 🤡 2
  • 🤮 1
Post #3120 4.27K
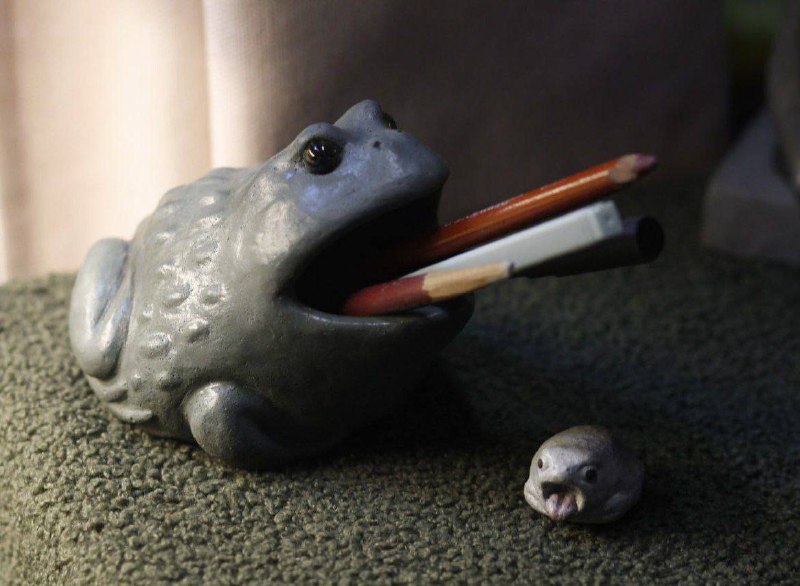
В моей жабьей семье пополнение.🐸🐸🐸

Теперь у меня появилась крутая легушька-водонос для хранения мелочевки, например духов как в моем случае, либо канцелярки.
Вместе с ней ко мне доехали две микро-легушьки которые будут ее (и меня) морально поддерживать.

А еще они будут дружить семьями с легушькой-горшочком, которая уже годик живет со мной.

Хотите себе таких же? Тогда заходите к postanimalistica - там таких делают, показывают и продают. Они идеально подойдут как оригинальный подарок на 8 марта - очень полезные и красивые. Либо можете собрать личную семью лягушек

У всех лягушек авторский дизайн, они качественные, тяжеленькие - из брутального архитектурного бетона, и милые. И там не только лягушки! Много разных питомцев-компаньонов - они смотрят как живые, но не требуют ухода.

Давайте поддержим молодой лягушачий бизнес. Это единственная реклама за последний наверное год, и я считаю что она действительно полезная.

https://t.me/postanimalistica
  • ❤ 30
  • 👍 5
  • 🔥 3
  • 🤩 3
  • 😍 1
Post #3117 4.08K
Очень странная статья от Google.
Основная идея: давайте случайно не применять обновления к параметрам, а если и применять - уменьшать их на величину, пропорциональную отклонению угла стохастического градиента от накопленного за последние итерации.
Они также привели некие доказательства сходимости своего метода.
В частности, очень интересен assumption 3 (см на картинке) - он говорит, что стохастический градиент по норме не слишком сильно отклоняется от истинного.
В чем проблема данной статьи, на мой взгляд?
Мне кажется, что авторы зашли не с того угла.
Во-первых, в их случае (а явно этого не прописано) константа ограничивающая разброс из предположения явно никак не оценивается, по крайней мере я не нашел в статье этого.
Во-вторых, и что более проблемно, существует E-SG (см.картинку 3). E-SG является более сильным условием, чем они предлагают в своем предположении. Более того, они неявно приближают обусловленность своей задачи к E-SG сценарию, так как несонаправленные градиенты начинают зануляться с большей вероятностью - очевидно, что разброс становится меньше.
В-третьих, уже есть методы для достижения E-SG, в частности адаптивный батчинг, в частности для случаев когда мы близки к решению - AdLoCo, который я предложил в своей последней статье.
Безусловно, научный вклад у статьи есть - с вычислительной точки зрения (если не смотреть другие аспекты по типу распределенного обучения, где AdLoCo побьет их) это более простой метод, и он очень хорошо рассмотрен с точки зрения взаимодействия со спецификой трансформеров.
Не знаю, может написать им, спросить?
Если вы со мной не согласны, то пишите в комментариях - подискутируем. Может быть я тупой и что-то не понял :)
Ссылка на статью
  • ❤ 23
  • 👍 4
  • 🤔 1
  • 🤡 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →