TGViewer
Channel Public Channel
Badass SEO 🌭

Badass SEO 🌭

@badseo

Тут корисні штуки для SEO
та рефлективний SEO-щоденник тривожного інтроверта

автор каналу нічого не продає та не претендує на звання найрозумнішої
людини

всі пости написані по фану, з великою ноткою скепсису, саморіронії, сарказму.
Subscribers
1.86K
Photos
81
Videos
9
Links
106
Recent Posts 19 shown
Post #222 2.27K
Post #221 756
Як не спалити квоту Ahrefs API на дроп-доменах

це я більше для себе, щоб не забути, а може і вам стане у нагоді

1. Пакетний ендпоінт замість одиночних запитів

/v3/site-explorer/metrics на один домен — 50 юнітів.
/v3/batch-analysis/batch-analysis — до 100 доменів за раз, 9 юнітів за домен.

Різниця в 5.5 раза на рівно тих самих даних.

2. Вартість залежить від кількості полів

Заміри на пачці зі 100:

• тільки DR → 2 юніти/домен
• DR + UR + dofollow backlinks + referring domains → 9 юнітів/домен

Тобто кожне зайве поле в select ви оплачуєте на кожному домені.

3. Головне: спершу питайте найдешевшу метрику

Якщо у вас є відсічка по DR — беріть спочатку тільки DR за 2 юніти, а повний набір лише тим, хто пройшов.

На дропах більшість доменів мають DR 0–4. Тобто ви платите повну ціну за домени, які відсіються на першому ж правилі.

Підсумок на 4153 доменах:
одразу все — 37 400 юнітів
спершу DR — 14 200 юнітів

здається може, що це не важливо, але коли ви парсите десятками тисяч, то кожен запит на вагу золота

продуктивного вам тижня 🌟
  • ❤ 13
  • 👨‍💻 4
  • 👍 3
  • 🔥 1
  • 🤓 1
  • 🤝 1
Post #220 1.11K
SEO BAZA Завтра середа! А це означає новий лайв! Поговоримо про RAG для SEO. ⏰ 26 серпня о 18:30 ⠀ 🟢 Що RAG реально дає SEO, а що йому просто приписують? 🟢 Чи потрібна векторна база конкретно вашому сайту? 🟢 Як RAG покращує контент, перелінковку й programmatic SEO?…
таблички то круто, але бази даних то вже справжній рок-н-ролл ✌

https://seobaza.com.ua/articles/vlasnyi-rag-dlia-seo-z-nulia

(обережно, пост викликає залежність від SQL з перших рядків)
  • ❤ 16
  • 🍾 3
  • 🔥 1
  • 🥱 1
  • 🤝 1
Post #218 838

Forwarded from SEO BAZA (Olesia Korobka)

Завтра середа! А це означає новий лайв!  Поговоримо про RAG для SEO.
⏰ 26 серпня о 18:30

🟢 Що RAG реально дає SEO, а що йому просто приписують?
🟢 Чи потрібна векторна база конкретно вашому сайту?
🟢 Як RAG покращує контент, перелінковку й programmatic SEO?
🟢 Чи допомагає це потрапляти у відповіді LLM?
🟢 Як зібрати перший MVP без складної та дорогої архітектури?

В ефірі Саша ХіловаВіра Сєчкіна і Олеся Коробка.

На стрімі розіграємо квиток на SERP Conf від нашого спонсора Collaborator. Переможець сам обирає: Рим 16 жовтня або Відень 3 листопада.

Дивитися наживо на YouTube-каналі SEO BAZA.
YouTube RAG для SEO. Що працює насправді? Живий стрім 26 серпня о 18:30. RAG: модель перед відповіддю дістає факти з вашої бази, а не вигадує з голови. ➖➖➖➖➖➖➖➖➖➖ 🤝 Спонсор стріму — Collaborator Collaborator — маркетплейс для PR та лінкбілдингу, де можна знайти перевірені сайти й Telegram-канали…
  • 🔥 18
  • ❤ 2
  • 👍 2
  • 🤝 1
Post #217 1.17K

Forwarded from Я тестую: SEO та ШІ 🇺🇦

Чим витягувати дані з будь-якого сайту та як парсити за допомогою агентів
Насправді парсинг потрібен частіше, ніж здається: зібрати ціни конкурентів, додати статті у власну базу знань, передати щось агенту тощо.
Ось список інструментів, який варто зберегти.
Готові сервіси, які працюють із коробки
Firecrawl — https://firecrawl.dev/
Перетворює будь-яку сторінку, включно із JS-сайтами та PDF, на чистий markdown для моделі.

Jina AI Reader — https://jina.ai/reader/
Додаєте r.jina.ai перед посиланням і отримуєте чистий текст сторінки. Безкоштовний тариф досить щедрий.

Apify — https://apify.com/
Маркетплейс із 28 тисячами готових скраперів майже для будь-якого популярного сайту.

Thunderbit — https://thunderbit.com/
Розширення для Chrome, яке витягує дані зі сторінки у два кліки та відправляє їх у Sheets або Notion.

RSS.apphttps://rss.app/
Перетворює сайти та соцмережі на RSS-стрічку з фільтрами й автопостингом у Telegram.

Відкриті бібліотеки, які можна встановити через агента
Crawl4AI — https://github.com/unclecode/crawl4ai
Популярний open source-скрапер, який одразу віддає сайт у markdown для моделі.

Browser Use — https://github.com/browser-use/browser-use
Агент керує браузером як людина: авторизується, клікає та збирає дані.

Crawlee — https://github.com/apify/crawlee
Фреймворк із ротацією проксі, повторними спробами та чергами, коли сторінок справді багато.

Scrapy — https://github.com/scrapy/scrapy
Промислова класика на Python для обходу мільйонів сторінок.

Scrapling — https://github.com/D4Vinci/Scrapling
Сам адаптується до змін верстки, тому ламається помітно рідше.

AutoScraper — https://github.com/alirezamika/autoscraper
Показуєте приклад потрібних даних — він сам знаходить шаблон і витягує решту.

Defuddle — https://github.com/kepano/defuddle
Очищає сторінку від реклами, меню та сайдбарів. Це рушій Obsidian Web Clipper.

Коли сайт чинить опір
curl_cffi — https://github.com/lexiforest/curl_cffi
Запити з відбитком справжнього браузера — простий спосіб зменшити ймовірність того, що запит буде розпізнаний як бот.

curl-impersonate — https://github.com/lwthiker/curl-impersonate
Схожий підхід на рівні curl, який використовується як рушій для curl_cffi.

CloakBrowser — https://github.com/CloakHQ/CloakBrowser
Заміна Playwright на модифікованому Chromium для роботи із сайтами з антибот-захистом.

invisible_playwright — https://github.com/feder-cr/invisible_playwright
Схожий підхід, але на базі Firefox.
Firecrawl - The web data API to search, scrape, and interact with the web at scale. 🔥 Firecrawl is the web data API to search, scrape, and interact with the web at scale. Turn any source into clean Markdown or structured data your agents can ship with.
  • 👍 36
  • 🤝 4
  • 🦄 3
  • 👎 2
  • 👀 1
  • 😇 1
Post #216 2.13K

Forwarded from Alex

Здоров колеги, це Саша Белевець
Шукаю собі в команду майбутнього Head of PBN - прямий репортинг мені, нуль бюрократії та мікроменеджменту.
Компанія 10+ років на ринку, портфель 3000+ доменів, готова інфраструктура - база активів накопичена, купа автоматизацій, лінк-прогони вміємо робити автоматично і масовано.
Працюємо з норм бюджетами і топовими аукціонами, тут обмежувати не буду.
Знаєш кого порекомендувати - пиши і отримай $1500 💸 за успішний найм!
дякую за шейр
  • ❤ 4
  • 🔥 3
  • 🤝 2
Post #214 1.86K
Тест був вдалий
Грошей нема 😅

Ідемо далі

Витрачено на сайт в сумі 4 години
На інфру 20 баксів

Зроблено з ентузіазмом та любо вʼю до процесів автоматизації

Користь : навчилась будувати бази даних, парсити те що не можна парсити, ламати аішку та генерувати те , що вона вважає неетичною

Не кожен проєкт зароблятиме.
Іноді задача прокачати себе та скіли настільки, щоб наступний вистрілив.

Стек: SQL, AI, PHP.
  • ❤ 26
  • 🌭 7
  • 🤝 7
  • 😁 3
  • 👍 2
  • 🥴 1
  • 🍾 1
Post #213 2.1K
Пан Джон видав базу - робіть більше власних сайтів для тестів!

Якщо ви технічний SEO-фахівець і хочете краще зрозуміти системи рендерингу Google, ніж це зазвичай потрібно, рекомендую ознайомитися зі статтями Dave Smart і Tony McCreath. Посилання — нижче.

Також, якщо ви технічний SEO-фахівець і хочете практикувати свої навички, створюйте власні тестові сайти, щоб досліджувати, як усе працює. Робота з тестовими сайтами та спостереження за тим, що відбувається, є надзвичайно цінними: ви можете зазирнути «за лаштунки» й побачити, як насправді працюють ті чи інші механізми.

Іноді — не завжди — ви знайдете щось, що допоможе вам приймати більш обґрунтовані рішення. В інших випадках ви просто набудете практичного досвіду, що дозволить упевненіше говорити про технічні теми, коли вони виникатимуть.

Створювати тестові сайти також стало значно простіше завдяки сучасним AI-інструментам. Але, якщо хочете, можна робити це й вручну — як справжній «вебмайстер старої школи».

Links to the posts:
* https://tamethebots.com/blog-n-bits/the-5-second-google-render-limit-myth
* https://bigcommerce.websiteadvantage.com.au/tonys-theory-of-googlebot-relativity/
  • 😁 11
  • ❤ 10
  • 👍 6
  • 🤡 1
Post #212 2.3K
не бачила щоб хтось казав про це

паразитарка

3
2
1

пігнали 🕺
  • 🌚 19
  • 🔥 3
  • 👎 2
  • 🤝 2
  • 🤔 1
Post #211 2.65K
тут могла би бути ваша реклама


автор: Alexander Buriakow
  • 😁 46
  • 🤝 1
Post #209 2.72K
Domains Available . Now DA.N (Domains Available . Now) — сервіс моніторингу expired-доменів. Можливості: — живий фід доменів, доступних для реєстрації прямо зараз — пошук за нішею, темою, ключовими словами, мовою, TLD — AI-аналіз архівного контенту: про що був сайт, категорія, ключові…
класний приклад коли людині самій дуже треба
сів і зробив

хай це вас надихне на продуктивний тижень
  • ❤ 17
  • 🔥 1
Post #208 2.28K

Forwarded from Domains Available . Now

DA.N (Domains Available . Now) — сервіс моніторингу expired-доменів.

Можливості:
— живий фід доменів, доступних для реєстрації прямо зараз
— пошук за нішею, темою, ключовими словами, мовою, TLD
— AI-аналіз архівного контенту: про що був сайт, категорія, ключові слова, мова
— історія Wayback, вік, дата дропу, RDAP lookup у реальному часі
— моніторинг списків доменів з алертами
— авто-реєстрація через API реєстратора
— збережені пошуки, списки, улюблене
— Cloudflare DNS, редиректи, відновлення старого сайту (в процесі реалізації)
— експорт у CSV

domainsavailable.now

Відкриті сторінки без реєстрації:

Available Domains — живий фід доменів, які зараз доступні до реєстрації, оновлюється щохвилини.
domainsavailable.now/available

Re-Registered — які дропнуті домени перереєстрували нові власники, щоденна статистика за останні 28 днів.
domainsavailable.now/re-registered

Statistics — коли домени дропаються: графіки по днях і годинах, топ попередніх реєстраторів, розподіл TLD і за віком.
domainsavailable.now/statistics

Backorder — прозорі метрики auto-registration: скільки заявок прийнято, успішних реєстрацій, швидкість реакції від дропу до виклику реєстратора.
domainsavailable.now/backorder-stats

RDAP Lookup — перевірка будь-якого домена: статус, реєстратор, дата завершення, NS, доступність через live RDAP-запит.
domainsavailable.now/rdap-lookup

Будь-який репост, відгук чи пропозиція багато значать і підтримують мотивацію рухатись далі. Дякую, що ви тут.
DA.N Domains Available . Now Find expired domains by niche, not just by name. Large domain database with new domains added daily. Search by topic, track lifecycle, register domains via API at cost price.
  • ❤ 6
  • 👍 2
  • 🤝 2
  • 🔥 1
Post #207 1.98K
прикольний апдейт від плагіну коллаборатор - можна в ахревсі одразу побачити, які з сайтів є у каталозі

прикольна фіча

https://chromewebstore.google.com/detail/collaborator-link-assista/menngjohfmmcpcljplgioeoejblcfegc

покидайте будь ласка в коментарі прикольних плагінів, кришезносних

або похвастейтесь своїми , що цікавого навайбкодили?)
  • 👍 30
  • ❤ 3
  • 🤝 2
Post #206 2.31K
Як підключити Google Search Console до Claude через MCP

Крок 1 — Google Cloud проєкт
console.cloud.google.com → New Project
— Пошук: "Search Console API" → Enable

Крок 2 — Сервісний акаунт
— IAM & Admin → Service Accounts → + Create Service Account
— Назва (напр. gsc-mcp-bot) → Create and Continue

Крок 3 — JSON-ключ
— Keys → Add Key → Create new key → JSON
— Збережи файл у надійному місці (напр. Documents/gsc-key.json)
— ⚠️ Стався до нього як до пароля

Крок 4 — Доступ у GSC
— Відкрий JSON → знайди "client\_email" → скопіюй адресу
— GSC → Settings → Users and permissions → Add user → встав email → Full access

Крок 4А — Формат URL ресурсу
⚠️ Найчастіша помилка: якщо в GSC показується просто example.com (без https://) — це Domain property
→ використовуй sc-domain:example.com, не https://yourdomain.com

Крок 5 — Встанови MCP-пакет

git clone [repo]
cd GSC-MCP
npm install
npm run build


Крок 6 — Claude Desktop
— Settings → Developer → Edit Config
— Додай:

{
"mcpServers": {
"gsc": {
"command": "node",
"args": ["/path/to/GSC-MCP/dist/index.js"],
"env": {
"GSC_KEY_FILE": "/path/to/gsc-key.json",
"GSC_SITE_URL": "sc-domain:yourdomain.com"
}
}
}
}

— Збережи → перезапусти Claude Desktop

Готово. Запитай Claude: _"What are my quick win keywords?"_

Оригінальний пост: https://www.linkedin.com/posts/natalia-golenkova_i-just-connected-google-search-console-with-share-7442599893887520769-b4KF
LinkedIn Connect Google Search Console to Claude via MCP: A Step-by-Step Guide | Natalia V Golenkova posted on the topic | LinkedIn I just connected Google Search Console with Claude via MCP 🤯- and it took me a little while to set up, but it is worth it. ⚡3/26/2026 Updated & simplified guide for marketers based on the feed back for the last 24 hours.⚡ https://lnkd.in/erZuQvWS I marked…
  • 👍 26
  • ❤ 4
  • 🤝 2
  • 🆒 2
  • 👾 1
Post #205 1.93K
онлайн-конференціі створені для того, аби вас надихати вчитись та копати в потрібному напрямку

спікер не може за 30 хвилин вам дати всі секрети та знання

але спікер вас може надихнути копати в потрібному напрямку з потрібними інструментами

вчора була онлайн конференція AI SEO Day і вона мене надихнула на дещо цікаве

а сьогодні вранці я вже бачу перші результати

що було зроблено за 2.5 години (я тягну свій прикол із часом, мені важливо розуміти, що можна створити за дуже короткий проміжок часу)

• EMD домен
• 69 programatic pages + службові сторінки
• ssr
• cloudflare
• паралелельно готувала млинці , бо Масляна )))
• перші тестові юзери похвалили вибір ніші та дизайн
• витрачено на генерацію $4.1693
• перші сторінки потрапили в індекс вже через кілька год з моменту публікації сайту, зараз 20 сторінок в індексі
• 46 юнік юзера

сподіваюсь вас конфа також надихнула, і ви творите вже свою магію ⭐️

побажайте мені пройти фільтри 🤞
  • ❤ 25
  • 🔥 7
  • 🤝 2
  • 🥰 1
  • 👌 1
  • 🍾 1
Post #203 6.63K
БЕЗКОШТОВНІ курси з AI, ML, Deep Learning та LLM від університетів

Core AI / ML / Deep Learning

📍MIT – 6.S191 → Deep Learning + LLMs
https://introtodeeplearning.com

📍Stanford – CS229 → Machine Learning (Andrew Ng)
https://cs229.stanford.edu

📍Stanford – CS231N → Computer Vision
https://cs231n.stanford.edu

📍 Stanford – CS224N → NLP & Transformers
https://cs224n.stanford.edu

📍CMU – 11-785 → Practical Deep Learning (PyTorch)
https://deeplearning.cs.cmu.edu

📍Harvard – CS50 AI → AI з Python для початківців
https://cs50.harvard.edu/ai/

LLM / Foundation Models / Generative AI
📍Stanford – CS336 → Build GPT from scratch
https://stanford-cs336.github.io

📍Stanford – CS324 → Foundation Models
https://stanford-cs324.github.io/winter2023/

📍Berkeley – LLM Agents → RAG, tools, agents
http://rdi.berkeley.edu/llm-agents/f24

📍MIT – Generative AI resources
https://openlearning.mit.edu/

Якщо є тільки 5 хвилин:
📍Google ML Crash Course
https://developers.google.com/machine-learning/crash-course

📍 Fast.ai — починаєш кодити одразу
https://course.fast.ai

📍Stanford CS336 — зрозуміти, як працює GPT
https://stanford-cs336.github.io

💡 Важливо:
Усі курси — офіційні, безкоштовні, з лекціями, слайдами та часто з домашками.
Платними можуть бути лише сертифікати — сам контент відкритий.

деякі я сама проходжу
буду вдячна, якщо ви доповните цей список своїми знахідками теж, я впевнена, що там є що додати

цікавий факт - якщо порахувати всі ці курси зі списку + проєкти вийде 3000-5000 годин

Найефективніша послідовність для новачків (6-12 місяців):

Google ML Crash Course (2 тижні, 15 год)
Harvard CS50 AI (1-2 місяці, 100 год)
Stanford CS229 (2-3 місяці, 200 год)
Fast.ai Practical DL (2 місяці, 120 год)
Stanford CS224N або CS231N (2-3 місяці, 150 год)

тому хоча б 30 відсотків пройти - це вже буде ого-го ⭐️
гарних вихідних!
MIT Deep Learning 6.S191 MIT's introductory course on deep learning methods and applications
  • ❤ 34
  • 🤝 7
  • 🔥 4
  • 👍 2
Post #199 2.02K
Балувалась зі звʼязкою quiz + Reddit.

Дано:
• 1 лапка 🐾
• нетерплячка перед виходом другого тому 5 сезону Stranger Things
• дата — 24 грудня (реліз 25 грудня)

Щоб не закопуватись у процес, я вирішила провести експеримент:
дати собі рівно 4 години. Не більше.

Часу обмаль — поїхали.

Спарсила Reddit.
Додатково зробила deep research через Perplexity.

Тут важливо зупинитись і пояснити задумку.
Мета була зібрати квіз на основі реальних даних користувачів Reddit, щоб їм це справді відгукувалось.
Тому головне джерело — саме Reddit.

Далі я зібрала міні-базу знань за архетипами — 16 основних персонажів.

Окремо зробила deep research по айдентиці: кольори, настрій, анімації, дрібні деталі.
Все, що могла швидко врахувати, врахувала — щоб хоча б трохи зануритись в атмосферу.

Чи можна було красивіше?
Звісно, можна.

Але ціль була мінімально, швидко і до кінця.

Ітого: від ідеї до заливки сторінки — 2 години.

Далі — дистрибуція.

Згенерувала два прес-релізи.
Один безкоштовно засабмітила — його моментально опублікували.
На всякий випадок додала в індексатор.

Другий пішов на модерацію — ну і фіг з ним, в нас же таймінг 🙂

На strangerthings.fandom.com зробила пост + картинку.
Також додала на індексацію.

Пробіглась по соцмережах — де могла, там напостила.

І, звісно, Reddit — основне поле гри.
Тут головне було правильно позиціонувати пост.
Я намагалась подати його максимально органічно — як фан-проєкт для таких самих людей, як я, хто чекає другий том 5 сезону.
Типу: «ось, зробила, може і вам зайде».

Про всяк випадок увімкнула under attack mode 😅

Чесно — готувалась до гіршого.
Але була реально вражена: всі коментарі — позитивні.

Через ~12 годин усі посилання «по хвостах» почали підтягуватись в AI Overviews.
Reddit сміливо став у топ.
Сайт витримав наплив людей.
Кілька нормальних посилань отримано безкоштовно і швидко.

Мінус — обмеження часу + Різдво.
Можна було б ще кілька приколів докрутити.

Підсумки:
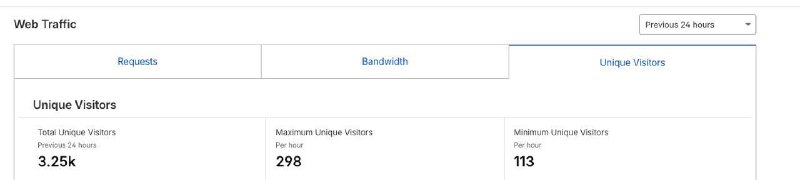
• ~3500 унікальних відвідувачів за 24 години на квіз
• на Reddit — 3000+ переглядів, пост у топ-10 Stranger Things сабредіту
• 2 безкоштовні посилання з DR 80+
• витрачено 4 години з кайфом і користю

Окрема ачівка — тепер у мене є нормальний шаблон квізів, який можна масштабувати.

Отакі справи.

Буду продовжувати робити щось подібне — поділюсь.
І дуже сподіваюсь, що це надихне вас не боятись Reddit 💜


P.S.: в особистих питають в чому суть, я забула додати , що там в кінці афф посилання на книжки на Амазон 🤌
  • 👍 39
  • 🔥 10
  • 💘 6
  • 🍾 1
  • 🤝 1
Older posts →

About this channel

How can I read @badseo without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Badass SEO 🌭: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Badass SEO 🌭 have?
Badass SEO 🌭 (@badseo) has 1.86K subscribers on Telegram, refreshed roughly every 30 minutes.
Does Badass SEO 🌭 know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →