TGViewer
Channel Public Channel
Асимптотически нормальный канал

Асимптотически нормальный канал

@asymptotically_normal

Меня зовут Максим Николаев, я делаю топовое образование на факультете МКН СПбГУ, преподаю в ШАД, а также занимаюсь наукой в ПОМИ РАН и лаборатории Маркова на МКН. Здесь делюсь разным.
Subscribers
702
Photos
46
Videos
0
Links
20

Showing posts older than #51 · Back to latest

Older Posts 7 shown
Post #50 1.46K
Стреляем себе в ногу с помощью критерия Манна—Уитни!

Критерий Манна—Уитни это замечательный двухвыборочный критерий для нулевой гипотезы P(X < Y) = 0.5 против альтернативы, что эта вероятность не равна/больше/меньше 0.5. Проверяет он ее непосредственно: по выборкам иксов и игреков считаем долю пар вида x_i < y_j. Если эта доля близка к 0.5, то не отклоняем гипотезу, а если нет, то отклоняем.

Критерий имеет массу достоинств:
+ он непараметрический, то есть не делает никаких предположений о распределениях X и Y;
+ он точный, то есть его ошибка первого рода равна выбранному уровню значимости;
+ он устойчив к выбросам: если большие значения заменить на очень большие, то на результате это не скажется;
+ его можно применять к порядковым данным, то есть данным, для которых мы можем определить отношения больше/меньше, но не можем численно выразить разницу (скажем, сравнение вкуса двух видов вина);

...и один неприятный недостаток:
– нас не интересует гипотеза P(X < Y) = 0.5.

По жизни нам интересно, совпадают ли распределения X и Y? Или еще чаще, совпадают ли матожидания X и Y? С обеими этими гипотезами критерий работает так себе:
‣ Если распределения равны (и непрерывны), то конечно P(X < Y) = 0.5, но обратное неверно: рассмотрим, например, X ~ N(0, 1), Y ~ N(0, 4). Это означает, что с ошибкой первого рода все будет ок, но мощность в неудачных случаях может быть очень плохой вне зависимости от объема выборок.
‣ Равенство матожиданий, в свою очередь, вообще никак не связано с P(X < Y) = 0.5. При проверке равенства матожиданий критерий может подвести как угодно: ошибки обоих родов могут непредсказуемо отъехать в любую сторону.

Хозяйке на заметку:
Во втором случае проблема с отъехавшей ошибкой первого рода не ловится даже A/A-тестами, так как когда мы делим контроль случайным образом на две группы, мы получаем группы не просто с равными матожиданиями, но и с равными распределениями, для которых критерий точен.


Почему критерий Манна—Уитни тем не менее используют в A/B-тестах? Скажем, всеми любимые 🤩бакетные тесты🤩 это часто именно Манн—Уитни поверх бакетного преобразования метрики. Жмите 👀, если хотите постик про бакетные тесты.

Ну потому что всем пофиг, что там проверяет критерий на самом деле. Наверное можно поверить, что в типичных A/B-тестах результаты в контрольной и тестовой группах не отличаются, то есть нулевая гипотеза это не просто равенство матожиданий, а равенство распределений, а если и отличаются, то это приводит к небольшому сдвигу всего распределения в какую-то из сторон, который и ловит критерий. В случае бакетных тестов на больших объемах выборки это в целом звучит правдоподобно, но все равно кажется, что в ситуациях с большими и странными эффектами (скажем, среднее немного уменьшилось, но ощутимо увеличилась дисперсия) даже разумный объем выборки может не спасти.
  • 👀 32
  • 🔥 5
  • ❤ 1
Post #49 1.29K
intervals.gif6.5 MB
Выбросы часто воспринимаются как исключения, которых по идее не должно быть, но они почему-то есть. Их часто выкидывают в процессе анализа, потому что они слишком сильно влияют на оценки.

Тем не менее наличие выбросов следует интерпретировать скорее не как неудачу, а как указание на то, что могло быть и хуже!
  • 🔥 6
  • 🤩 4
  • ❤ 1
Post #46 1.29K
Почему бутстраповские интервалы работают?

Есть такой замечательный способ строить по выборке доверительный интервал для матожидания:
1️⃣ Генерируем из исходной выборки N выборок с возвращением такого же размера, что и она. Эти N выборок называются повторными или бутстраповскими.
2️⃣ Для каждой повторной выборки считаем выборочное среднее. Получаем тем самым выборку из N средних.
3️⃣ Считаем 0.025 и 0.975 выборочные квантили у выборки средних — это и есть края нашего 95% интервала.

Вместо выборочного среднего можно брать оценку чего-нибудь другого и на выходе получится доверительный интервал для этого чего-нибудь. Скажем, если в шаге 2 считать выборочную дисперсию, то получится интервал для дисперсии.

Бутстрап это пока не самый популярный топик в курсах по статистике, но зато в индустрии про него знают прекрасно. Правда почему эта штука работает, все равно обычно не обсуждается, потому что, во-первых, это чот сложновато, а во-вторых, конкретно про интервал выше это еще и не совсем понятно: известно, что на практике работает отлично, и на том спасибо.

В этом посте мы тем не менее постараемся почувствовать, почему эта штука работает, и почему она лучше чем обычный доверительный интервал для матожидания.
Благодаря прошлому посту, обошлись тремя карточьками 😎
  • 🔥 10
  • 👀 7
  • 😁 1
Post #37 1.25K
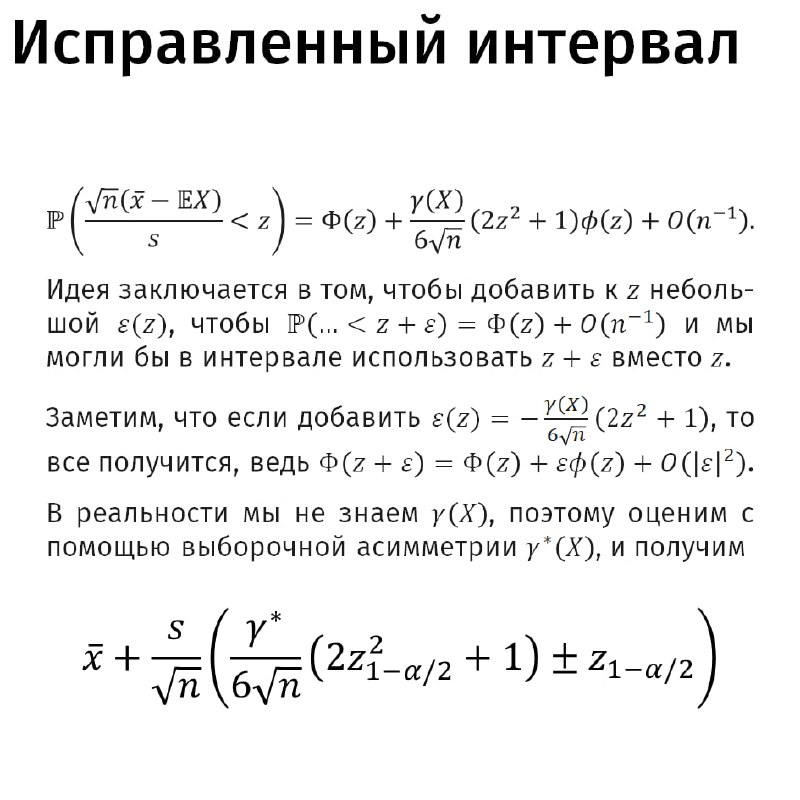
Простой дедовский способ прокачать интервал для среднего

Хотел рассказать, почему работает бутстраповский интервал для среднего, но пока пилил карточки, понял, что получается дофига, и решил сначала рассказать, как можно оценивать среднее еще лучше (и быстрее!) чем с помощью бутстрапа 💅
  • 🔥 17
  • 💅 6
Post #27 1.09K
Есть такой раздел аналитики — перформанс аналитика. Это про то, чтобы знать, сколько времени работают те или иные компоненты продукта, и что с этими временами происходит с течением времени.

Казалось бы, звучит супер стандартно: навали дашбордов и сиди мониторь. Проблемы тут вот в чем:
1️⃣ В больших проектах могут быть миллионы временных рядов с большой историей, которые надо быстро обрабатывать, поэтому используемые методы должны быть эффективными.
2️⃣ Все распределения обычно невероятно мерзкие: много мод, которые надо детектировать и трекать; тяжелые хвосты, которые могут порождать очень большие выбросы (которые будут нормой); асимметрия, смесь дискретных и непрерывных частей и т.п. Все это требует специфических методов анализа.
3️⃣ Если методы будут иметь большую вероятность ложноположительного срабатывания, то аналитик потонет в попытке разобраться, где именно среди очередной тысячи алертов произошла деградация, а где просто шум.

С перформанс аналитикой я познакомился, когда отбирался на стажировку в аналитику JetBrains. Оказалось, что в интернете есть примерно один источник качественного контента на эту тему: творчество Андрея Акиньшина, который в то время руководил перформанс аналитикой в Rider.

В работе Андрея меня поразил очень системный подход к проблемам конвенциональной статистики: он глубоко рефлексирует над тем, почему же ничего не работает, и как сделать так, чтобы статистика была не набором рецептиков хозяйке на заметку, а стройной дисциплиной с понятными принципами. Вот, скажем, Pragmatic Statistics Manifesto 🌚

Если вам такое близко, то дико рекомендую заценить вот что:
👉 Доклад Андрея «Анализируем перформанс с пользой для себя и окружающих»
👉 Блог Андрея, в котором есть тонна всяких мыслей и прикольных методов
👉 Книга «Профессиональный бенчмарк. Искусство измерения производительности» (оригинальная версия на английском)

На картинке: определение количества мод у распределения из статьи Lowland multimodality detection.
  • ❤ 6
  • 👍 6
Post #23 1.01K
Недавно и совершенно случайно узнал, что линейную регрессию можно красиво обобщить на произвольные ядра! Сам факт обобщения удивления не вызывает — линейная регрессия это ведь такой гауссовский процесс, а гауссовские процессы бывают разные. Удивляют простота и элегантность перехода от одного к другому, а также тот факт, что я об этом узнал только сейчас.

Решил посмотреть, пишут ли про это в The Elements of Statistical Learning, и вроде бы прям про такой вывод не пишут, но в целом про ядерные штуки можно почитать в главе 5.8 Regularization and Reproducing Kernel Hilbert Spaces!
  • 🔥 17
Post #22 1.31K
Две недели назад закончился студкемп Яндекса и МКН СПбГУ а на этой неделе мы наконец залили лекции с него в группу факультета в ВК.

Я прочитал на кемпе 4 лекции, но мне кажется, наиболее интересной и полезной для широкого круга была последняя лекция про распределения в реальной жизни. Слайды в комментах.

Идея лекции достаточно простая: давайте посмотрим, как разные предположения о «физике» исследуемого явления могут подсказать, каким распределением можно приближать данные. Тем не менее, я не встречал такой постановки и такого разнообразия очень естественных распределений ни в курсах по теорверу, ни в курсах по статистике.

Я разбираю:
‣ равномерное распределение — время активности пользователя в небольшом интервале времени
‣ экспоненциальное распределение — время между соседними активностями
‣ гамма-распределение — время между k активностями: за сколько времени купят k единиц товара
‣ распределение Пуассона — количество активностей в фиксированном интервале времени
‣ распределение Бернулли — лайкнул ли пользователь случайный пост
‣ биномиальное распределение — сколько из n постов лайкнул пользователь
‣ геометрическое распределение — какой по счету пост пользователь лайкнул первым
‣ нормальное распределение — время, за которое купят много единиц товара; количество активностей в большом интервале времени; количество лайнутых постов из большого их количества
‣ смесь бернуллиевских величин — если данный пост увидело n случайных пользователей и каждый из них лайкает посты с разной вероятностью, то инфорацию о пользователях вида «лайкнул/не лайкнул» можно рассматривать как выборку из распределения Бернулли с вероятностью, равной средней вероятности лайка
‣ бета-биномиальная смесь — собрали с кучи пользователей количество лайков за последние 100 постов, которые они просмотрели
‣ бета-геометрическая смесь — собрали с кучи пользователей длину их случайной сессии просмотров шортсов
‣ отрицательное биномиальное распределение — собрали с кучи пользователей количество просмотров за последние сутки
‣ бета-геометрическое/отрицательное биномиальное распределение (BG/NBD) — решаем такую задачу: пользователь проявил активность какое-то время t назад; какова вероятность, что он не перестал пользоваться нашим сервисом и в обозримом будущем снова проявит активность?

На аналогичную тему я прочитал лекцию в ИТМО на Дне математики. Слайды также в комментах.
VK Видео Распределения в реальной жизни. М.С. Николаев, Студкемп Яндекс Образования х МКН СПбГУ Смотрите онлайн Распределения в реальной жизни. М.С. Николаев,.. 1 ч 12 мин 58 с. Видео от 7 декабря 2025 в хорошем качестве, без регистрации в бесплатном видеокаталоге ВКонтакте! 216 — просмотрели. 8 — оценили.
  • 👍 12
  • 🔥 11
  • ❤ 3
  • ✍ 1
  • 🤯 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →