TGViewer
Channel Public Channel
Мир аналитика данных

Мир аналитика данных

@analysts_world

Пишу о рабочих буднях аналитика. Тут много рабочего кода, прохождение собеседований и еще много всего полезного.
https://www.linkedin.com/in/valeriashuvaeva
Автор канала: @Valeria_Shuvaeva
Subscribers
4.56K
Photos
143
Videos
3
Links
114

Showing posts older than #298 · Back to latest

Older Posts 20 shown
Post #297 1.68K
😄 Когда продукт не совпал с реальностью

Ребят, вы же не против немного лайфстайла в выходной?
Обычно здесь строго про Python, SQL и аналитику.. но вчерашняя ситуация так хорошо легла на продуктовое мышление, что не удержалась 😄

Вчера была на стендапе.
Афиша: чёрно-белые портреты комиков, стильная типографика, обещанные «4 комика с лучшими проверенными шутками».
Реальность: на сцене — совсем другие комики, не с афиши. И я такая: «Ого, так можно было?»

И тут сработала профессиональная деформация аналитика.
📊 Когда мы видим продукт, мы покупаем именно тот, который нам показывают.
Не тот, что “должен был быть”,
не тот, что “заменили в последний момент”,
а конкретное обещание, вынесенное на афишу/баннер/экран.

В продуктовой аналитике это видно особенно четко:

✖️неверный скриншот в сторе — минус конверсии;
✖️обещали одну фичу — дали другую — минус доверие;
✖️несостыковка маркетинга и реального UX — минус удержание.

✅ Ожидание должно совпадать с опытом.
Если пользователь приходит за «вот этими четырьмя комиками с афиши, хоть кого-то из шести заявленных», не стоит удивляться, что он слегка в шоке, когда выходит совсем другой состав.
Да, внизу афиши мелким шрифтом указано, что состав комиков может меняться. Но я и не думала, что меняться не из предложенного списка.

К слову, мне стендап понравился. Было смешно, я хорошо провела вечер. Но, но, но...
Эта ситуация напомнила мне простое правило продуктового мышления:
👉 сначала честная коммуникация, потом — хороший продукт. Тогда и шутки смешнее, и метрики растут 😉
  • 🔥 14
  • 👍 9
  • ❤‍🔥 2
  • 👌 2
  • ☃ 1
Post #296 2.07K
⚡️Как устроиться аналитиком в 2025 году — не запутаться и не выгореть

Если вы хотите попасть в аналитику, но не понимаете, с чего начать?
SQL, Python, BI, курсы, хард- и софт-скиллы, стажировки - информации море, а структуры ноль 🤯

Разобраться, что реально важно, поможет бесплатный вебинар от Simulative - они уже стали родными в этом канале.

Ведущий - Андрон Алексанян, CEO школы аналитики Simulative. Он не просто расскажет “как стать аналитиком”, а покажет, что сейчас действительно работает на рынке и как получить оффер быстрее других.

Что будет на вебинаре:
〰️полный роадмап аналитика 2025 — что учить и в каком порядке
〰️портфолио и резюме, которые реально замечают наниматели
〰️инсайты от рекрутеров: какие требования сейчас в приоритете
〰️техники для новичков, чтобы компенсировать отсутствие опыта


Кстати, миф “в аналитику берут только с опытом” давно не работает, а если вам 30, 40 или даже 50+ - этот не минус, про все это раскроют подробно на вебинаре.

Главное — понимать, что и зачем делать.

Бонус: в конце вебинара ребята из Simulative дадуи вам инструмент, который поможет ускорить рост в аналитике.
А сразу после регистрации пришлют чек-лист, чтобы понять, подходит ли вам аналитика вообще.

😶Зарегистрироваться на бесплатный вебинар
  • 👍 4
  • 🔥 2
  • ❤‍🔥 1
  • ❤ 1
Post #295 2.34K
🧩 Когда хочется угодить заказчику или лайфхак в Python для.. Excel

Неожиданно, правда? Недавно столкнулась с такой потребностью по работе: нужно было собрать всё про клиента в одной строке - заказы, статусы, комментарии - чтобы не плодить дубли.

Классика разговора:
- А такое можете?
- Могём!

Короче можно сделать аккуратно и компактно, всё в одной строке! 👇

Создадим датафреймчик
import pandas as pd
from openpyxl import load_workbook
from openpyxl.styles import Alignment

df = pd.DataFrame({
'client_id': [1, 1, 1, 2, 2],
'order_id': [101, 102, 103, 201, 202],
'comment': ['срочная доставка', 'оплата картой', 'повторный заказ', 'новый клиент', 'скидка 10%']
})


Теперь объединим данные по клиенту. И вот тут используем переносы строк внутри ячейки \n. Но в юпитере их видно не будет. Смотрите на фото как выглядит в Юпитере. Строка будет типа такой: срочная доставка\nоплата картой\nповторный заказ
df_grouped = df.groupby('client_id', as_index=False).agg({
'order_id': lambda x: '\n'.join(map(str, x)),
'comment': lambda x: '\n'.join(x)
})


💡Теперь само волшебство:
file = 'clients_info.xlsx'

#Сохраняем в Excel
df_grouped.to_excel(file, index=False, engine='openpyxl')

# ✨ Делаем переносы видимыми в Excel
wb = load_workbook(file) # открываем созданный файл Excel
ws = wb.active # выбираем активный лист

# пропускаем заголовок,проходит по всем ячейкам.
for row in ws.iter_rows(min_row=2, max_row=ws.max_row):
for cell in row:
# Если в ячейке есть текст с переносами — включаем wrapText
if isinstance(cell.value, str) and '\n' in cell.value:
cell.alignment = Alignment(wrapText=True)

wb.save(file) # сохраняем файл счастья


😀 Excel покажет всё в столбик прямо внутри ячейки, аккуратно и читаемо!

Лайк за пост в рабочий субботний день! 🤪 Кто осилил - тот молодец!
  • 👍 24
  • ❤ 19
  • ❤‍🔥 3
  • 🔥 3
Post #293 2.01K
🔍 Если ты в поиске работы, то та самая вакансия наверняка ждет тебя на канале No Data No Jobs

Чтобы помочь соединять крутых кандидатов и позиции, Павел Бухтик из No Data No Growth создал канал с позициями для продуктовых аналитиков No Data No Jobs. Особенность канала в том, что в большинстве вакансий есть прямые контакты рекрутеров, а значит, ответ можно получить в разы быстрее 🚀

В силу рынка, вакансии в основном для ребят с опытом, но джуновские позиции там тоже есть. Каждый день Паша публикуются 2-3 интересные вакансии из своего личного нетворка.

Также иногда удается раскрыть вилку для некоторых позиций. Поэтому даже если ты не ищешь работу, то можно ради любопытства сканировать рынок и составлять картину найма в целом.

Подпишись, чтобы не упустить возможности:

🔗 https://t.me/nodatanojobs

P. S. а если ты ищешь сотрудника к себе в команду – Паша бесплатно размещает вакансии на канале.
  • 🔥 10
  • ❤ 2
  • ⚡ 1
  • ❤‍🔥 1
Post #292 2.21K
📊📊📊📊 — ваша дата-аналитическая точка роста!
🗓 30 октября, 13:00 | 📍 Москва
🔗 Регистрация

Что вас ждёт:
— 10+ докладов про аналитику, автоматизацию и low-code.
— Кейсы от компаний: Газпром проектирование, ПМСОФТ, Газпромнефть-Снабжение, АвтоВАЗ, Hoff.
— Выступление директора по развитию исследовательского проекта «Круги Громова».
— Демозона, партнёрские стенды, живые демонстрации и обсуждения с практиками.
— Нетворкинг, живая музыка, фуршет и розыгрыши.

Темы докладов:
✅ Loginom 7.3 — что нового и зачем это бизнесу.
✅ Data Science на базе Loginom: от данных к решениям.
✅ Искусственный интеллект и его применение в аналитике.
✅ Self-Service аналитика — как ускорить работу с данными.
✅ Автоматизация, развертывание и интеграция.
✅ Переход с CRM на СПР: реальные результаты.
✅ ETL и Low-code платформы в бизнес-процессах.

Кому будет полезно:
аналитикам, BI-специалистам, IT-разработчикам и всем, кто хочет упростить работу с данными без лишнего кода.

🔗 Бесплатное участие по регистрации
  • ✍ 4
  • ⚡ 4
  • ❤ 2
  • ☃ 2
  • ❤‍🔥 1
Post #291 1.92K
🌿 Отдых как секрет продуктивности.

Врываемся в выходные! 🚀
Мы часто гоняемся за результатом, забывая про паузы. А великие люди знают: чтобы творить и достигать - нужно отдыхать.

Но вот SORA считает иначе и никак не хотела генерировать картинку с людьми, бегущими к выходным. 😅 Может, у неё своё личное мнение на этот счёт? Кто знает…

А пока почитайте мудрость великих:
💭 Бенджамин Франклин:
«Тот, кто умеет отдыхать, сильнее того, кто может взять города.»

🎨 Леонардо да Винчи:
«Отдых — это не праздность, а подпитка для ума, чтобы создавать великие вещи».

⚡️ Стив Джобс:
«Иногда нужно остановиться, чтобы увидеть картину целиком. Перерывы дают новые идеи».

💭 Альберт Эйнштейн:
«Воображение важнее знания. Знание ограничено, воображение охватывает весь мир.»
  • ❤‍🔥 15
  • ❤ 1
Post #290 2.04K
💸 Поговорим о деньгах?

В последнее время я часто ловлю себя на мысли, что деньги стали ощущаться по-другому.
Не как «цель» или «ресурс», а как что-то живое, что постоянно меняется. Я иду в магазин - и вроде покупаю почти то же самое, а чек будто стал в два раза наглее.💸
И все мы понимаем, что это бешеная инфляция, но всё равно где-то внутри проскакивает: «а с фига ли настолько?»😅

📊 Деньги перестали быть просто цифрами. Они стали показателем стабильности, спокойствия — или наоборот, тревоги.
Это отражение наших решений, привычек, ожиданий.
Слова из отчётов превращаются, блин, в личные чувства.

И ведь это не про теорию. Инфляция 📈 - это твоя чашка кофе ☕️, бутер с колбасой 🥪, доп. занятия для дочки или дорогущие очки с нормальными стёклами 👓, которые я всё равно купила, потому что надо по медицинским показаниям.

Я правда рада, что пока могу себе это позволить. Да, не всё, что хочу — но хотя бы то, что действительно важно.

Вопрос не в том, как тратить меньше (и так уж все ужиматься стали), а в том, как не потерять ощущение контроля, когда всё вокруг так сильно меняется.
Я действую по старинке - вот у меня блог как доп.доход приносит иногда денежку, и на том большое спасибо вам всем как читателям! 🆒
Менторить я давно перестала: не хватает времени.
Ну и не перестаю радоваться, что сменила в свое время профессию. 👨‍💻

❓ Хочу спросить - появились ли у вас дополнительные источники дохода или пока просто урезаем траты? Или и то и другое?
Хочу напомнить, что лучшая инвестиция - это в свои знания и умения. Умение отодвигать дедлайны не в счёт.

p.s. Этот мэм мем я сгенерировала сама.
  • 🔥 11
  • ❤ 7
  • ❤‍🔥 2
  • ✍ 2
Post #289 2.35K
🦆 DuckDB — идеальный SQL для аналитиков прямо в ноутбуке

Я всегда показываю примеры SQL-скриптов с помощью pandasql (на SQLite), но оказывается, есть библиотека круче! Это DuckDB.

Она как PostgreSQL 💪, только без сервера — поддерживает почти весь синтаксис SQL: оконные функции, CTE, JOIN-ы, агрегаты, подзапросы и многое другое.
📅 База появилась в 2019 году — вот реально, всё знать невозможно!

🔹 Почему это круто

🔸Не нужно поднимать PostgreSQL или MySQL — всё работает локально, прямо в ноутбуке.
🔸Поддерживает функции работы с датами и временем, как в PostgreSQL:
можно использовать DATE_TRUNC, EXTRACT, DATE_DIFF, CURRENT_DATE, INTERVAL и другие привычные вещи, которых нет в pandasql.
df = pd.DataFrame({
"date": ['2025-08-01',
'2025-08-10',
'2025-09-02',
'2025-10-03',
'2025-10-05',
'2025-10-08'
],
"id": [111, 222, 333,111,333,444]
})
df['date']=pd.to_datetime(df['date'])
import duckdb
query = """
SELECT
DATE_TRUNC('month', date) AS month_start,
count(*)
FROM df
group by 1
order by 2 desc
"""

result = duckdb.query(query).to_df()
result

🔸Идеально подходит, чтобы репетировать SQL-вопросы к собеседованию прямо в Jupyter.

Если раньше pandasql был удобным костылём, то теперь у нас есть полноценный инструмент!
⚙️ Но это не только для подготовки к собеседованиям — DuckDB отлично подходит и для реальной аналитической работы.

Она умеет работать с огромными файлами CSV, Parquet, Arrow. Можно делать сложные джойны, оконные функции, агрегации, работать с временными рядами. Изучать и изучать!

🦆Кря-кря короче.
  • 🔥 27
  • 👍 5
  • ❤ 3
  • 😱 2
  • ❤‍🔥 1
Post #287 1.92K
👀 Что происходит на рынке аналитиков?

🎉Во-первых, всех с пятницей!

Друзья, есть отличная возможность поучаствовать в новом исследовании от NEWHR. Ну как им отказать — нужным делом занимаются!
Они готовят обзор по рынку аналитиков за 2025 год — самое время разобраться, куда движется отрасль и какие тенденции нас ждут. Ну и видос этот просто залипательный! Поднимает настроение! 😂

📊 В NEWHR исследуют рынок аналитиков с 2018 года!

Выясняем, как меняется профессия, чего хочет бизнес от аналитиков, чего хотят сами аналитики, сколько стоят аналитики и какими технологиями пользуются.

Вот несколько инсайтов из исследования 2024 года:

➖ Зарплаты в 2024 году продолжали расти (и не зря — значимость хорошей зарплаты резко выросла по сравнению с 2023 годом)

Больше половины респондентов признались нам, что деньги для них — на первом месте. В 2023 году так считали всего 25%.

➖ Аналитики стали реже менять работодателей

При этом снижение активности по смене работы не повлияло на интерес к собеседованиям — мониторить рынок остаётся стабильной потребностью.

➖ Зарубежные компании уже не так привлекательны для аналитиков из России

Это слом тренда 2022−2023 годов. Наши респонденты стали больше ориентироваться на рынок, который ближе к ним: в России — на российский, за рубежом — на зарубежный.

➖ 🤍 Авито — самая привлекательная компания-работодатель для аналитиков

На втором месте — ❤️ Яндекс, на третьем — ✈️ Авиасейлс.


Что поменялось за год? Помоги нам узнать, поучаствовав в новом исследовании!

Опрос займёт около 20 минут. Участники получат ранний доступ к результатам и приглашение на закрытый эфир с инсайтами исследования.

🔤Пройти опрос🔤

Если ты хочешь «копнуть глубже» — вот результаты наших прошлых исследований: 2019, 2020, 2022, 2023, 2024.

*️⃣ В первых исследованиях мы больше фокусировались на продуктовых и дата-аналитиках, но теперь, по многочисленным просьбам, мы адаптировали вопросы также для руководителей аналитики, системных и бизнес-аналитиков.

P. S. Пожалуйста, поделись ссылкой на опрос с коллегами-аналитиками! Чем больше участников, тем точнее и интереснее результаты 💙
  • ❤ 8
  • ❤‍🔥 6
  • 🔥 5
  • 🤣 1
Post #286 1.86K
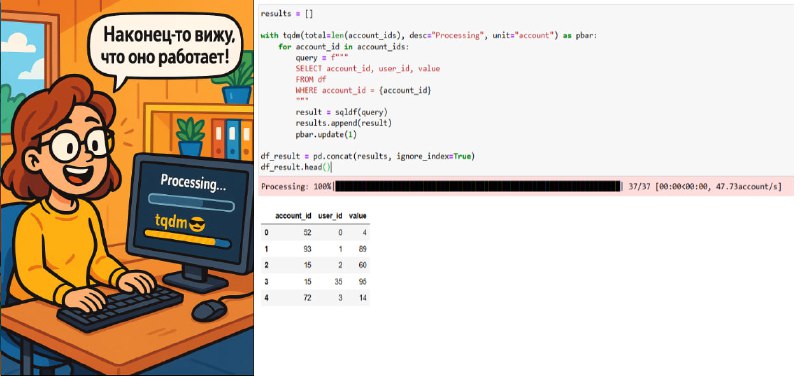
⚙️Когда хочется видеть, что твой код реально что-то делает - tqdm

Наверняка вам знакомо ощущение, когда запускаешь тяжёлый запрос в Jupyter — ноутбук будто завис, а ты не понимаешь, идёт ли процесс вообще 🤯 Хочется хотя бы примерно видеть, сколько уже обработалось данных и сколько ещё ждать. И ждать ли вообще!

💡 Тут на помощь приходит библиотека tqdm — она показывает прогресс выполнения прямо в Jupyter или консоли.
Удобно, наглядно - все как мы любим!

Приведу простой примерчик с кодом. Сам sql запрос просто тащит данные из датафрейма df. Но нам тут и не надо мудрить. Нам просто запихнуть какой-то запрос в библиотеку tqdm и видеть процесс в реальном времени 👇

import pandas as pd
import numpy as np
from tqdm import tqdm
from pandasql import sqldf

np.random.seed(42)
df = pd.DataFrame({
"account_id": np.random.randint(1, 100, 50),
"user_id": np.arange(50),
"value": np.random.randint(1, 100, 50)
})

account_ids = df["account_id"].unique()
results = []

with tqdm(total=len(account_ids), desc="Processing", unit="account") as pbar:
for account_id in account_ids:
query = f"""
SELECT account_id, user_id, value
FROM df
WHERE account_id = {account_id}
"""
result = sqldf(query)
results.append(result)
pbar.update(1)

df_result = pd.concat(results, ignore_index=True)
df_result.head()


🧩 Что здесь происходит

🔸 tqdm cоздаёт прогресс-бар. В скобках указываем:
total=len(account_ids) — сколько всего итераций будет;
desc="Processing" — подпись слева («Processing»);
unit="account" — подпись единицы измерения в строке прогресса

🔸 pbar.update(1)
Каждый раз после обработки аккаунта добавляем «+1» к прогрессу.

🔸 sqldf(query)
Ну это база - позволяет писать sql прямо по датафрейму. На работе у каждого свои коннекторы конечно.

🔸 pd.concat(results)
Собирает все маленькие датафреймы обратно в один большой.

✔️ В следующий раз не гадай, «повис ли Юпитер» — пусть tqdm честно покажет, что код жив, пашет и уже почти дошёл до конца!
  • 🔥 14
  • ✍ 9
  • ❤ 3
  • ❤‍🔥 1
Post #285 2.44K
🍀 Понедельник — это не повод для грусти!

Берём кофе или чай, включаем любимую музыку, и работаем так, будто сидим где-то в красивой локации среди гор и водопадов.
Пусть сегодня будет день с настроением, а неделя - продуктивной и лёгкой! 🌿

Эту картинку я собрала в Sora. А чтобы и вы могли поиграться с картинками (а не только с кодом 😉), вот подборка полезных ИИ-сервисов:

🟢Fotor AI Portrait Generator
- аватары, новые фоны
🟢Remaker AI - замена фона, headshots
🟢FaceSwapper.ai - быстрый face swap
🟢AI Face Swap - замена лица онлайн
🟢Magic Hour - face swap фото/видео
🟢Canva AI Photo Editor - редактор фото, замена фона
🟢PhotoRoom - реалистичная смена фона
🟢Hotpot.ai — аватары, стилизация фото

✨ Генерируем красоту! Делитесь в комментариях своими работами для вдохновения 💚
  • 👍 16
  • ❤ 4
  • 🦄 4
  • 🔥 2
  • ❤‍🔥 1
Post #284 2.69K
🎲 Верный А/В, но неверное решение

На первый взгляд А/В-тесты кажутся простым инструментом: запускаешь два варианта, смотришь значимость изменений и принимаешь решение.

На практике – всё гораздо сложнее. Любой хорошо спланированный эксперимент требует учесть десятки нюансов, без которых будет принято неверное решение.

18 сентября в 19:00 по мск пройдет бесплатный вебинар на тему «Почему А/В тесты не работают».

Вебинар проводит Павел Бухтик — ex-Head of Product Analytics и автор канала No Data No Growth. За время работы в Yandex'е и стартапах, он провел 200+ А/В тестов, набил на них множество шишек и теперь делится своим прикладным опытом.

На вебинаре вы узнаете:

🔸 Почему результаты А/В-тестов могут вводить в заблуждение, даже если тест на первый взгляд проведён «по методичке»;

🔸 Конкретные примеры распространенных ловушек в методологии проведения А/В и интерпретации результатов;

🔸 Практические приёмы, которые повысят надёжность ваших тестов.

Если вы хотите увереннее чувствовать себя в А/В тестах на практике – регистрируйтесь на бесплатный вебинар по ссылке.

Полезно будет как тем, кто только начинает разбираться в А/В, так и тем, кто считает себя в них экспертом.
  • ❤‍🔥 13
  • ✍ 6
  • ❤ 3
Post #282 2.69K
Чтобы быть просто аналитиком, математика не всегда нужна. Но чтобы быть крутым аналитиком — без неё никуда!

Когда работаешь с данными, рано или поздно приходишь к простому выводу: никакие дашборды и SQL-запросы не спасут, если не понимаешь математику.

Понимание вероятности, регрессий, метрик — всё это напрямую влияет на работу.

Недавно нашла для себя канал «Зачем мне эта математика» от Яндекс Образования — и прям рекомендую!

Вот несколько постов, которые хочется выделить:
- доступный разбор линейной регрессии в контексте ML
- прогнозирование спроса с учетом цен и сезонностей
- объяснение метрик в разных контекстах
- устройство A/B тестов

Еще там часто публикуют неожиданные исторические факты и, конечно, задачи — куда без них в математике. Вот эта очень понравилась!

Переходите по ссылке и читайте! Математика — это база для крутых аналитиков 💪🤪
  • ❤‍🔥 8
  • ❤ 3
  • ✍ 2
  • ☃ 1
Post #281 2.41K
Задача с собеседования: Анализ заказов по годам и категориям

🍁 Признаюсь, начало сентября выдалось непростым. Двое детей-школьников, возвращение с летней дачи, бесконечный список дел... Кажется, я только сейчас начала приходить в себя и наконец-то выдыхаю!

Так как вам нравятся задачки с собесов, то нашла вам еще одну очень интересную задачку на SQL с собеседования. Давайте разберем ее по шагам!

❗️Задача: Вывести количество заказов за 2021 год в категории «Одежда» и за 2022 год в категории «Обувь» (итоговый вид: 2 строки. Поля: yr, order_num)

Есть две таблицы:

➖ orders — информация о заказах (дата, id пользователя, id заказа, id товара)
➖ products — информация о товарах (id товара, категория)

Сначала сгенерируем датафремы, для отработки кода в Юпитере:
import pandas as pd
data = {
'order_date': [
'2021-01-01 00:00:01',
'2021-01-01 00:00:01',
'2022-01-01 00:00:01',
'2024-01-01 00:00:01',
'2024-02-05 17:14:22',
'2024-04-10 04:20:59',
'2021-06-21 10:30:26'],
'user_id': [1, 1, 1, 1, 1, 2, 2],
'order_id': [1, 1, 1, 1, 2, 3, 4],
'product_id': [1, 2, 3, 4, 7, 4, 2],
}
orders = pd.DataFrame(data)

data2 = {
'product_id': [1, 2, 3, 4, 5, 6, 7],
'cat_1': [
'Одежда',
'Одежда',
'Обувь',
'Товары для дома',
'Обувь',
'Аксессуары',
'Товары для красоты']
}
products = pd.DataFrame(data2)


💻 Шаг 1: Анализ данных
Сначала смотрим, что у нас в данных:

🟢В заказах есть повторяющиеся order_id (например, order_id=1 встречается 4 раза) — это значит, что в одном заказе может быть несколько товаров
🟢Нам нужно считать уникальные заказы (DISTINCT order_id), а не просто строки
🟢Даты нужно преобразовать в год для фильтрации

🛠 Шаг 2: План решения
🟢Соединить таблицы orders и products по product_id
🟢Извлечь год из даты заказа
🟢Отфильтровать данные:
Для 2021 года: только категория «Одежда»
Для 2022 года: только категория «Обувь»
🟢Посчитать уникальные заказы для каждого случая
🟢Объединить результаты в одну таблицу

WITH t1 AS (
SELECT
SUBSTRING(o.order_date, 1, 4) AS year, -- Извлекаем год из даты
o.order_id,
p.cat_1
FROM orders o
JOIN products p ON p.product_id = o.product_id -- Соединяем таблицы
)

-- Запрос для одежды за 2021 год
SELECT
year AS yr,
COUNT(DISTINCT order_id) AS order_num
FROM t1
WHERE cat_1 = 'Одежда' AND year = '2021'
GROUP BY year

UNION ALL

-- Запрос для обуви за 2022 год
SELECT
year AS yr,
COUNT(DISTINCT order_id) AS order_num
FROM t1
WHERE cat_1 = 'Обувь' AND year = '2022'
GROUP BY year

Простыми словами как считать:
2021, Одежда: order_id 1 (2 товара одежды) + order_id 4 (1 товар одежды) = 2 уникальных заказа
2022, Обувь: order_id 1 (1 товар обуви) = 1 заказ

💡 Хитрость задачи:
Ключевая особенность этой задачи — специфичный формат вывода. Обратите внимание, что в результате нужны именно две отдельные строки (не группировка по годам и категориям), причем:

⭐️Первая строка: только 2021 год и только категория "Одежда"
⭐️Вторая строка: только 2022 год и только категория "Обувь"

Хотя так и хочется забить на формат и вывести просто нужную инфу:
select 
count(distinct o.order_id) filter (where p.cat_1 ='Одежда' and substring(o.order_date,1,4)='2021' ) as order_num1,
count(distinct o.order_id) filter (where p.cat_1 ='Обувь' and substring(o.order_date,1,4)='2024') as order_num2
from orders o
join products p on p.product_id =o.product_id

🈁⏪Задача проверяет не только знание SQL, но и внимательность к формату результата! ⏩👌
  • 🔥 10
  • ❤‍🔥 6
  • ❤ 3
  • 👌 2
  • 🤝 1
Post #279 2.62K
📊 Рабочий лайфхак: собираем данные по частям или как я победила ошибку ClickHouse с помощью chunk-загрузки

На днях пришлось доставать статистику по списку страниц из ClickHouse. Встретилась с проблемой — из-за длинного условия в WHERE по большому списку база выдавала ошибку лимита запроса.🙅

Что придумала:
🍀 Разбила список страниц на части
🍀 Для каждой части сделала отдельный запрос с OR-условиями
🍀 Всё соединила через pd.concat — получилась единая таблица

Я уже показывала как искать по множеству URL в SQL. Теперь автоматизируем и это.
У нас есть большой список URL-адресов (например, из Excel-файла), и нам нужно найти все посещения этих страниц в нашей базе данных.
Берем тестовые данные и список интересующих нас блогов (как будто вы это выгрузили из excel файлика, который вам прислали коллеги)
В этот раз возьмем для наглядности 4 url, чтобы "красиво" разбить их на две части (по два url в каждой)
blogs_df = pd.DataFrame({'blog_path': ['blog/101', 'blog/102', 'blog/201','blog/103']


И запихнем все в цирккл конечно!
chunk_size = 2
loc_list = blogs_df['blog_path'].tolist()
results = []

for i in range(0, len(loc_list), chunk_size):
chunk = loc_list[i:i + chunk_size]
print()
print('chunk - это вот что:', chunk) # посмотрим на эти части

chunk_condition = " OR ".join([f"page_url LIKE '%{path}%'" for path in chunk])

print('запихнули части в like:', chunk_condition)

query = f"""
select page_url,
visitor_id,
visit_date
FROM visits_df
where {chunk_condition}
"""
chunk_result = sqldf(query)
results.append(chunk_result)
# Объединяем результаты из всех частей
final_result = pd.concat(results, ignore_index=True)


print выведет нам при первой итерации:
chunk - это вот что: ['blog/101', 'blog/102']
запихнули части в like: page_url LIKE '%blog/101%' OR page_url LIKE '%blog/102%'

при второй итерации:
chunk - это вот что: ['blog/201', 'blog/103']
запихнули части в like: page_url LIKE '%blog/201%' OR page_url LIKE '%blog/103%'

Ну и выведет финально то, что искали. Смотрим на сгенерированного человечка, пытливо ищущего ответы (радуемся картинке - мозг отдыхает), а потом пеереводим взгляд на вывод кода справа и немного напрягаем мозг 🤪.
  • ❤ 10
  • 👍 3
  • 😁 1
  • 🤪 1
  • 🆒 1
Post #276 2.53K
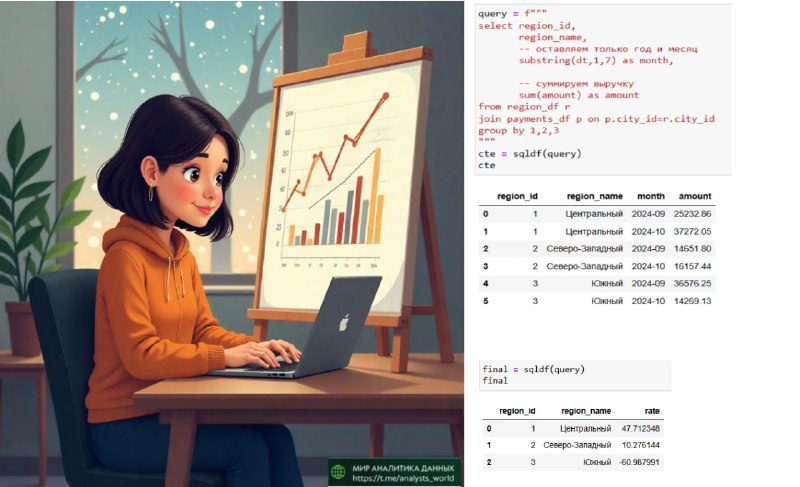
📊 Разбор задачи с собеседования: сравнение выручки по регионам

Ну что, так как все любят разборы задачек с собесов, то вот вам еще одна!
Нужно вывести разницу в выручке в процентах по каждому региону, сравнивая октябрь 2024 с сентябрем 2024.

📌 Структура таблиц:

region – данные о регионах и городах
- id - первичный ключ
- region_id - id региона
- region_name - название региона
- city_id - id города
- city_name - название города

payments – информация о платежах
- id - первичный ключ
- payment_id - id платежа
- dt - дата и время платежа
- amount - сумма платежа
- city_id - id города

1️⃣ Предварительный запрос. Соединяем таблицы и группируем данные.
Для начала нужно связать таблицы region и payments по полю city_id, чтобы понять, к какому региону относится каждый платёж.
Затем:
Извлекаем год и месяц из даты платежа (dt) с помощью substring(dt, 1, 7) (формат 'YYYY-MM'). Я всегда делаю это с годом на всякий случай, а то вдруг в данных разные года представлены.
Суммируем выручку (amount) по каждому региону и месяцу.
Делаем это все в CTE. По сути, просто предварительный расчет чего-либо.
🔹 CTE (Common Table Expression) — это временный результат запроса, который можно использовать в последующих частях SQL-запроса.

Вот так начинается наш CTE
with monthly_revenue as

. Теперь на основе этой таблички мы сможем делать уже основной запрос со сравнением:

2️⃣Основной запрос. Сравниваем выручку между сентябрём и октябрём
Теперь, когда у нас есть выручка по месяцам, можно рассчитать разницу в процентах между октябрём (2024-10) и сентябрём (2024-09).
Используем:
✅ FILTER – отбирает только нужные строки для агрегации (аналог CASE WHEN).
✅ NULLIF – защищает от деления на ноль (если в сентябре выручки не было).
Тут уже мы во FROM пишем monthly_revenue. То есть вытаскиваем из подзапроса уже данные.
query = f"""

with monthly_revenue as (
select region_id,
region_name,
substring(dt,1,7) as month, -- оставляем только год и месяц
sum(amount) as amount -- суммируем выручку
from region_df r
join payments_df p on p.city_id=r.city_id
group by 1,2,3
)

select region_id,
region_name,
((sum(amount) filter (where month='2024-10') - sum(amount) filter (where month='2024-09'))*1.0/
nullif(sum(amount) filter (where month='2024-09'), 0))*100 as rate

from monthly_revenue
group by 1,2

"""
result = sqldf(query)


💡 Итог:

Используй CTE (WITH) для сложных запросов — это как создание «временных таблиц» для удобства. А подзапросы — когда нужна быстрая вставка логики в WHERE или JOIN.
Оба подхода делают SQL мощнее, но CTE — это чище, понятнее и переиспользуемо ✨

Кто любит CTE - ставьте 🐳, кто за подзапросы - 🦄. Ну а если и то и то любите - 🔥
  • 🔥 17
  • 🐳 17
  • ❤‍🔥 3
  • 🦄 3
  • ❤ 1
Post #274 2.17K
📱 Цифровая диета? Не, не пробовали.

Количество каналов в телеге растет неимоверно! Я подписана на огромное количество. Конечно почти все на «беззвучном». Рука так и тянется к телефону заглянуть к кому-нибудь почитать что-то новенькое.

🔢 Нашла статистику, что в России пользователи проводят в Telegram в среднем 39 минут в день (Mediascope, 2023).
Сейчас, в 2025, особенно в IT-сфере, цифры наверняка зашкаливают.

🌟 Хочешь отдохнуть, но мозг требует контента? Добро пожаловать в бесконечную ленту! ‼️

🔔 Поводы залипнуть в Telegram.

💼 Рабочие моменты:
🟣Грузится sql запрос - загляни в Телегу!
🟣Ждешь ответа от коллеги - перейти с его контакта на канал!
🟣Сервер лег? Пока админы поднимают - есть время на пару мемов в ТГ!
🟣На созвоне говорят не о твоей теме? Тихий скролл в Телеграм - лучший друг.

🚀 Продуктивность (или её отсутствие):
🟣 Застрял на задаче? Мозг в тупике? Переключись на ТГ - вдруг там ответ? (спойлер: нет)
🟣 Понедельник. Настроение «не хочу работать». Кого бы почитать в Телеге для вдохновения? p.s. Сегодня не понедельник, не прокатит
🟣 Сделал полезное дело? Теперь можно и залипнуть в каналы — как награда!

📱 Быт и рутина:
🟣 Едешь в метро? Рука сама тянется к Телеге! (Не на людей же смотреть?)
🟣 Завариваешь кофе? Пока кипятится - глянь что там нового в ленте!
🟣 Лежишь перед сном? Ну ладно, ещё пять минуточек скролла… Ага, как же.

А ещё этот вечный FOMO (Fear of Missing Out) - тревожное «а вдруг я пропущу что-то важное?». Листаешь ленту, а в голове:
✔️Это полезно для карьеры
✔️Тут интересный кейс
✔️А это просто забавно

Но в итоге вместо отдыха — цифровая усталость. Информации море, а толку? Ее ведь еще применить нужно, а не просто прочитать!

💬 Как у вас?
Сколько каналов реально читаете? Есть ли те, что давно в «мьюте», но жалко отписаться? Как боретесь с FOMO и инфоперегрузом? Или сдались и погрузились с головой?

Давайте обсудим — может, вместе найдём рецепт цифровой гармонии? 👇
  • 👍 12
  • ⚡ 3
  • 🔥 2
  • ❤‍🔥 1
  • ❤ 1
  • 💯 1
Post #272 2.07K
🔍 Регулярки на практике: ищем посты про ИИ в датасете

Сегодня покажу регулярное выражения на примере задачи: как отфильтровать датасет по ключевым словам. Такое очень часто встречается в работе.

📌 Задача
Допустим, у нас есть таблица с какими-то названиями клиентов или там, новостей, или ссылок. Нужно выбрать только те, где упоминается что-то связанное с искусственным интеллектом (или его синонимами).

🔧 Решение через регулярки

🎲 Создаём мини-датасет для примера
import pandas as pd
data = {
'title': [
'Новости про ИИ',
'Котики в тренде',
'Машинное обучение и нейросети',
'Что такое Artificial intelligence?',
'Погода на завтра'],
'domain': ['tech.ru', 'cats.com', 'ai-news.org', 'science.com', 'weather.net']
}

df = pd.DataFrame(data)


🔍 Задаём паттерн для поиска
pattern = r'\b(?:ИИ|искусственный интеллект|AI|Artificial intelligence|нейросет|машинное обучение)\b' 


🎯 Фильтруем записи, где есть совпадения в title или domain

df_final = df[
df['title'].str.contains(pattern, case=False, regex=True, na=False) |
df['domain'].str.contains(pattern, case=False, regex=True, na=False)
]


💡 Ключевые параметры:
1️⃣ pattern — что ищем (текст или регулярка).

Что внутри него: raw-строки

➡️r' ' - это raw-строки, в них экранирование не происходит. Если объяснить проще, то вот например
print(r'1\t2') Выведет: 1\t2
print('1\t2') Выведет: 1 2 (табуляция или длинный пробел)
То есть r' ' — это как видишь, так и получаешь

Границы слов (\b):
➡️ Гарантирует, что ищется целое слово, а не часть слова
➡️ Например, найдет "ИИ" в "развитие ИИ", но не найдет в каком-то слове с ошибкой типа "фииалка")

Незахватывающая группа (?:...):
➡️Группирует альтернативы, но не запоминает совпадение для последующего использования
➡️Более эффективна, чем обычная группа (...), когда не нужно извлекать совпавший текст

Альтернатива
➡️| - логический оператор "ИЛИ", разделяющий слова, которые мы ищем

2️⃣case=False — игнорировать регистр (ИИ = ии = Ии).

3️⃣regex=True (по умолчанию True) — считать паттерн регулярным выражением. Если False, ищет точное совпадение строки еще и с учетом регистра.

4️⃣na=False — пропускать NaN (возвращать False вместо ошибки).

Ну и потом фильтруем базар датафрейм df если что-то отыскалось в колонках title или domain.

🚀 Так можно анализировать какие-то большие текстовые данные, для парсинга новостей можно использовать, ну или в
фильтрации сообщений в чат-ботах.
  • ❤ 12
  • ❤‍🔥 4
  • 👍 1
Post #270 2.14K
Бигтехи vs все остальные — где лучше?

На днях в одном из блогов наткнулась на вечный спор: работать в Бигтехе или в обычной компании? Речь, конечно, не про иностранные Amazon, Apple и прочие, а именно про наш российский, родной, можно сказать, Бигтехушка. Это Яндекс, Сбер, Авито, Т-Банк, WB, OZON и прочие IT-гиганты.

Мнение, как обычно, разделились.
❌ Одни кричат: «Работать в них “фу”. Одни овертаймы, высосут все соки!» (привет, выгорание 👋)
✅ Другие хвалят: «Лучше места не найти! Там и ДМС, и зарплата в рынке, и вообще имя узнаваемое, а не ООО “Ромашка“ какая-то»

Выскажу свое нафиг никому не нужное мнение.
Давным давно когда я работала в финансовом отделе и делала управленческую отчетность мы задерживались в дни отчетов до часу или даже до двух часов ночи в офисе! А кто-то из коллег и еще дольше! Мы отсылали отчетность в Лондон. И потом на корпоративном такси разъезжались по домам. Компания эта называлась ГрупЭм, она входила в WPP - это британский рекламный холдинг, очень известный в рекламном мире.
И знаете что? Это не был бигтех, про неё даже не все у нас слышали, но привет, адские переработки!
Так что не угадаешь, где будет хорошо. Коллеги, правда там были замечательные! ❤️

А сколько бардака бывает в небольших компаниях наверно все знают. Минимум онбординга, максимум погружения, но зато какой профессиональный рост!

Так что вывод простой:
Работайте везде! Тащите из каждого места плюсы, а минусы вам и так завистники в панамки накидают.
Главное — не застрять там, где вас не ценят. А всё остальное — опыт. 💥
  • ❤ 15
  • 👍 12
  • ❤‍🔥 2
  • 💯 2
Post #268 2.56K
🔥 Вернулась из отпуска, хватит отдыхать!

Ну что, отпуск пролетел быстро, как и положено отпуску. Немного грустно...
Но зато вчера я узнала про бесплатный интенсив по А/B-тестам от ШАД! И это не реклама. Я сама записалась и уже посмотрела первую лекцию.

📌 Что крутого?
✅ Программа – огонь: бутстрап, линеаризация, CUPED и другие важные темы.
✅ Можно подключиться по записи (первая лекция уже есть, но всё ещё успеваешь!).
✅ Есть ноутбуки с кодом - поковыряться, потестить циферки для практики, а это я уважаю. 💪

📅 Регистрация открыта до 25 июля. Ну грех не поделиться ХАЛЯВОЙ!

Сертификат дают только после отбора, но, честно, главное – знания, а не бумажка. 🚀
Кому совсем лень, гляньте первый ноутбук - там же красотища вообще 🎁

p.s. Если после строчки import scipy.stats у вас чешутся руки запустить симуляции — вы тот ещё симулянт! 🤪
  • 🔥 13
  • ❤ 3
  • ❤‍🔥 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →