
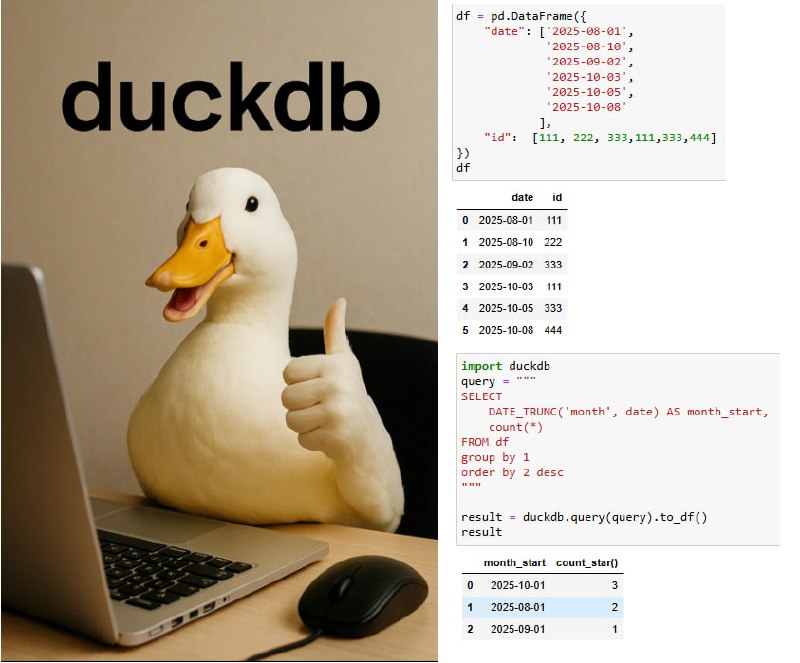
Я всегда показываю примеры SQL-скриптов с помощью pandasql (на SQLite), но оказывается, есть библиотека круче! Это DuckDB.
Она как PostgreSQL 💪, только без сервера — поддерживает почти весь синтаксис SQL: оконные функции, CTE, JOIN-ы, агрегаты, подзапросы и многое другое.
📅 База появилась в 2019 году — вот реально, всё знать невозможно!
🔹 Почему это круто
🔸Не нужно поднимать PostgreSQL или MySQL — всё работает локально, прямо в ноутбуке.
🔸Поддерживает функции работы с датами и временем, как в PostgreSQL:
можно использовать DATE_TRUNC, EXTRACT, DATE_DIFF, CURRENT_DATE, INTERVAL и другие привычные вещи, которых нет в pandasql.
df = pd.DataFrame({
    "date": ['2025-08-01',
             '2025-08-10',
             '2025-09-02',
             '2025-10-03',
             '2025-10-05',
             '2025-10-08'
            ],
    "id": [111, 222, 333,111,333,444]
})
df['date']=pd.to_datetime(df['date'])
import duckdb
query = """
SELECT
    DATE_TRUNC('month', date) AS month_start,
    count(*)
FROM df
group by 1
order by 2 desc
"""

result = duckdb.query(query).to_df()
result
🔸Идеально подходит, чтобы репетировать SQL-вопросы к собеседованию прямо в Jupyter.
Если раньше pandasql был удобным костылём, то теперь у нас есть полноценный инструмент!
⚙️ Но это не только для подготовки к собеседованиям — DuckDB отлично подходит и для реальной аналитической работы.
Она умеет работать с огромными файлами CSV, Parquet, Arrow. Можно делать сложные джойны, оконные функции, агрегации, работать с временными рядами. Изучать и изучать!
🦆Кря-кря короче.