TGViewer
Channel Public Channel
Слезы продакта

Слезы продакта

@alice_product

🤖AI-полезности для продактов
💪🏼Кейсы, практика, гайды
🚀Лайфхаки, тренды, болтовня😎

Присоединяйся!
Реклама и коллабы - @alice_only
Subscribers
845
Photos
164
Videos
12
Links
182
Recent Posts 9 shown
Post #499 116
😀Кейс: эмодзи или как 176 пикселей стали языком интернета

Представьте, что вы делаете мобильный сервис, а у вас в запасе 176 крошечных картинок размером 12×12 пикселей.
И так вы случайно создаете новый язык, без которого люди потом не смогут нормально читать рабочие чаты😎
Так в конце 1990-х и случилось с эмодзи

Как всё началось
Сразу разрушу красивый миф: один человек не изобрёл все смайлики мира.
Эмотиконы, то есть :-) из знаков препинания, существовали раньше. В 1982 году Скотт Фалман предложил использовать их в компьютерной переписке, чтобы отличать шутки от серьёзных сообщений.
А в Японии давно были каомодзи вроде `(╯°□°)╯

В 1997 году J-Phone выпустил телефон с набором из 90 пиктограмм, но он был дорогим и массовым не стал

Формат по-настоящему разогнал Шигэтака Курита, дизайнер NTT DoCoMo. В 1999 году для мобильного сервиса i-mode он создал набор из 176 эмодзи.
Погода, сердечко, лица, еда, транспорт. Всё, что помогало передать мысль и интонацию быстрее, чем ещё одно длинное сообщение
Кстати, emoji не связано со словом emotion. По-японски «e» это картинка, а «moji» это символ


Почему взлетело
Мобильная переписка тогда была короткой, медленной и без интонации. Написать «ну отлично» можно было и с радостью, и с желанием удалить рабочий чат. Понять разницу было сложно.
Курита не добавил пользователям эмоции, эмоции у них и так были.
Он дал им компактный способ передать контекст. А это уже два разных продуктовых сценария

Как эмодзи захватили мир
Японские операторы быстро поняли, что фича зашла, и начали делать собственные наборы. Но эмодзи одного оператора могли не отображаться у другого. Классическая история: у каждого свой прекрасный стандарт, а пользователю прилетает кракозябра.

Прорыв случился в 2010 году, когда эмодзи вошли в Unicode.
У символов появилась общая кодировка, и они стали нормально передаваться между устройствами и платформами. Вот тут маленькая фича превратилась в легенду

Мобильные ОС добавили полноценную поддержку, мессенджеры построили вокруг эмодзи реакции, а дизайнеры начали всерьёз обсуждать, почему один и тот же символ на разных платформах может выглядеть как флирт, угроза или пассивная агрессия😭

Оригинальные 176 эмодзи Куриты сейчас хранятся в MoMA. Не каждый набор иконок дорастает до музея современного искусства


Что в этом кейсе полезно
🙂Ограничение может стать фичей, 12×12 пикселей и короткие сообщения не мешали продукту. Они заставили команду искать самый ёмкий способ передать смысл. Пользователь покупает не функцию, а понятный ему результат
🙂Никто не просил, тем временем пиктографический интерфейс для передачи интонации был нуден людям нужно, чтобы их не поняли неправильно
🙂Без стандарта сетевой эффект не работает и пока эмодзи жили внутри отдельных операторов, это была локальная фича, с приходим Unicode он сделал их языком, который понимают везде
🙂Дизайн это часть продукта, а не последний слой после разработки. Эмодзи не меняют расчёт скидки или скорость доставки, но они меняют тон коммуникации, привычки пользователей и то, как люди считывают ваш продукт

Короче, эмодзи наше все не потому, что люди внезапно разучились писать словами.
Они стали универсальным способом добавить в цифровой разговор то, что раньше передавалось текстом, голосом или паузой.
В конце-концов, наша речь когда-то тоже выросла из наскальных рисунков)

Что почитать по теме
💬НИУ ВШЭ. История эмодзи, смайликов и каомодзи
💬Tilda Education. Революция эмодзи и путь от Японии до Unicode

Ciao! 💚

@alice_product
#кейсы
  • ❤ 5
  • ❤‍🔥 1
  • 🔥 1
Post #492 147
🤖 ФЗ о регулировании ИИ в России: саммари основных положений

Итак, подписан ФЗ № 243-ФЗ «О поддержке развития технологий искусственного интеллекта в Российской Федерации».
И тут важно, что пока не надо начинать срочно удалять чат-бота из приложения и переписывать роадмап

Закон регулирует не любой ИИ вообще, а большие фундаментальные модели.
То есть базовые модели, на которых потом строятся разные сервисы

Часть закона начнёт работать уже 1 сентября 2026, а самые прикладные статьи про статусы моделей, маркировку и права на результаты генерации вступят в силу 1 марта 2027 года.
Собрала в карточках важное, потому что еще есть время подготовиться

Но если коротко, то закон пока больше задаёт рамку, чем раздаёт готовые требования, но это не значит, что его не надо хотя бы прочитать уже сейчас)
Крайне рекомендую прочесть полный текст

Что почитать по теме
💬Российская газета. Закон № 243-ФЗ. Полный текст
💬Гарант. Кратко о ключевых положениях

Ciao! 💚

@alice_product
#ИИ
  • ❤ 2
  • 👍 1
  • 🔥 1
Post #491 157
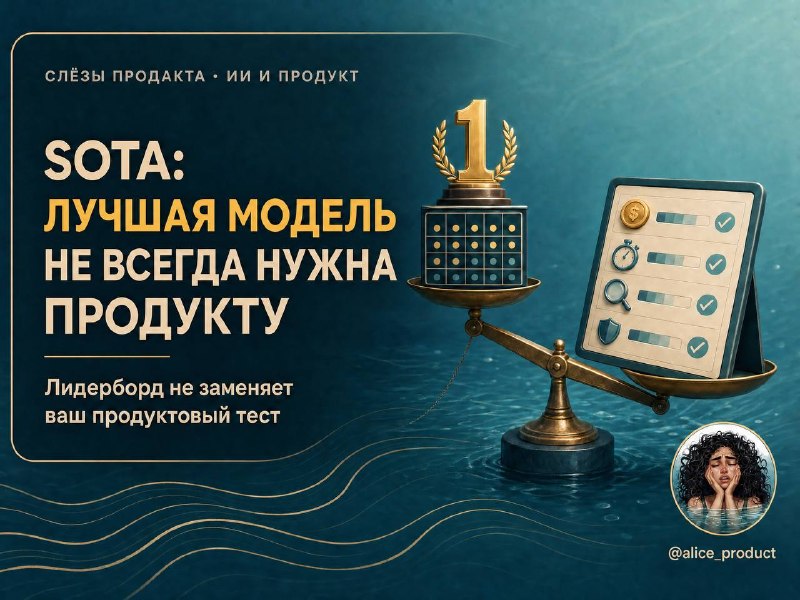
🏆 SOTA: почему лучшая модель не всегда нужна твоему продукту

На очередном викли кто-то приносит новость, что вышла новая модель и она SOTA. И вот уже хочется всё бросить, сменить провайдера и сделать презу для c-level что работаем только с самыми передовыми моделями (и сколько денег ЕЩЕ нам на это нужно) Давайте разбираться, что такое SOTA и почему продакту важно понимать это

Что это за аббревиатура
SOTA расшифровывается как State of the Art и зто лучший заявленный или опубликованный результат на конкретной задаче, по конкретной метрике и на конкретном тестовом наборе. То есть SOTA не означает, что модель топчик. Она означает, что сегодня она показала лучший результат в определённом тесте.
Те, модель может быть SOTA в математике, но это не гарантирует, что она так же хороша в решении других задач
Обученная для распознавания лиц европеоидов модель, едва ли хорошо импортируется в Китай. А обученная на английском языке фича по модерации отзывов едва ли поймёт что «ёшкин кот» это ругательство, а «фиг с ним» выражает неготовность обсуждать тему дальше


Что такое бенчмарк
Бенчмарк это стандартизированный экзамен для моделей, где есть набор заданий, правила подсчёта и итоговый балл. Он нужен, чтобы сравнивать модели в одинаковых условиях.
Проблема в том, что не надо путать экзамен и работу в реальных условиях

Где подвох
Первое, бенчмарк измеряет только то, что в него положили. Высокий балл по одной метрике не гарантирует, что модель полезна для вашей задачи.
Второе, часть публичных тестов годами доступна в инете, они могут попадать в обучающие данные, поэтому высокий балл не всегда означает, что модель научилась решать новые задачи, а не встретила похожие примеры раньше
Третье, в лидерборде обычно не видно того, что волнует продукт
🔺сколько стоит 1 успешный сценарий
🔺какая задержка ответа
🔺как часто модель глючит на ваших данных
🔺что происходит с безой и перс данными
🔺может ли пользователь вообще понять и принять её ответ

И самое важное, в ИИ-фиче пользователь общается не с моделью, а с целой системой. Там есть ваши данные, поиск по ним, промпты, инструменты, интерфейс, ограничения и человек, который потом разгребает косяки) Поэтому SOTA-модель в кривой обвязке может проиграть более скромной модели в нормальном продукте

Что проверяем перед переходом на новую SOTA
🔺на какой задаче и по какой метрике она стала лучшей
🔺похожи ли эти задачи на наши реальные сценарии
🔺какую цену, задержку и качество мы получим на своих данных
🔺что покажет наш собственный тестовый набор, а не чужой лидерборд
Вот тут и начинается продуктовая работа. Не выбрать модель с самым громким маркетингом, а понять, решает ли она конкретную проблему лучше, быстрее и за вменяемые деньги

Короче, SOTA это хороший сигнал, что модель стоит проверить, но точно не повод немедленно тащить её в прод и выбивать бюджет

Что еще почитать по теме
💬РБК Тренды. Как оценивать качество ответов нейросетей
💬Habr. Оценка мультиагентных систем

Ciao! 💚

@alice_product
#этобаза #ИИ
  • ❤ 3
  • 👍 1
  • 🔥 1
Post #490 185
🫥Теория мёртвого интернета

Открываешь канал 98 подписчиков, но 43 лайка на последнем посте, а под ним 50+ комментариев: «Наконец-то кто-то сказал правду», «Спасибо, очень полезно»

И блин, на моих набирается в лучшем случае 15, ну 25, если я прям молодец. И тут ты понимаешь, что половина аккаунтов без фото, коменты написаны одним стилем, а дискуссия выглядит, будто три одинаковых чела вежливо кивают друг другу🤠

Так вот, пятничный разгон про теорию мёртвого интернета

Что за теория
В 2021 году пользователь под ником IlluminatiPirate собрал на форуме главные тезисы идеи, которая до этого гуляла по 4chan и другим анонимным площадкам. Суть простая и слегка криповая: публичный интернет якобы уже не пространство, где люди общаются с людьми. Его заполнили боты, алгоритмы и автоматически сгенерированный контент.

По версии сторонников теории, где-то после 2016 года мы живём в большой симуляции, где алгоритмы решают, что показать, боты создают видимость реакции, а корпорации подсовывают бесконечную ленту, чтобы мы ещё чуток поскроллили.
Звучит как сценарий для «Чёрного зеркала» и да, часть оригинальной теории уходит в конспирологию про тайное управление интернетом.
Пруфов нет🕵🏻‍♀️

Почему это интересно
По данным Imperva, в 2025 году автоматический трафик составил больше 53% всего веб-трафика. То есть машины уже генерируют в сети больше запросов, чем люди.
Но тут важная оговорка, а то сейчас мы все достанем шапочки из фольги🤫
Это не значит, что 53% комментариев под постом написал ИИ. В эти цифры входят и полезные боты типа поисковые роботы, сервисы мониторинга, автоматизация, ИИ-агенты.
Они не обязательно вредные.
Просто интернет теперь живет не только для нас

При этом стоимость производства контента почти обнулилась. Можно за вечер нагенерить 300 SEO-статей, тысячу комментариев, десяток «экспертных» аккаунтов и даже небольшую переписку между ними, а потом алгоритм разгонит то, что собрало реакции

Получается такой цифровой бизнес-центр: свет везде горит, кондиционеры работают, лифты ездят. Только людей внутри нет.
Кстати, вы смотрели уже «Закулисье реальности»? Оч крипово

И вот тут у меня как у продакта начинается лёгкая тревожность.
Если в продукте растёт трафик, это ещё не всегда значит, что вырос интерес людей. Если под анонсом 500 коментов, это ещё не значит, что у нас 500 сигналов для Discovery.
Если у товара 1 000 отзывов, это ещё не значит, что мы поняли, что реально болит у пользователей.
Нам и раньше нужно было отделять шум от сигнала. Теперь этот шум научился писать связные предложения, ставить эмодзи и соглашаться с вашим мнением.
Очень удобно, конечно😭

Что с этим делать
В продуктах, где важны отзывы, комментарии, трафик и вовлечённость, нужно чаще спрашивать себя:
🔺кто именно создаёт этот сигнал
🔺можем ли мы подтвердить, что за ним был живой пользователь
🔺не оптимизируем ли мы фичу под шум
И, возможно, чуть бережнее относиться к маленьким живым сообществам. Там, где люди спорят неровно, пишут с ошибками, приносят неидеальные кейсы
Ну и тот же ИИ, что генерит шум, может также его и идентифицировать)

Получается петля, когда люди и боты генерят контент, он попадает в веб, а веб снова становится сырьём для след моделей. Но это не самостоятельный план ИИ, а следствие того, как устроены контент-фермы, SEO и платформы.

Короче, интернет не умер, но он стал очень зашумлённым, и ценность живого человеческого сигнала теперь только растёт.

Что еще почитать по теме
💬РБК Тренды. Что такое теория мёртвого интернета
💬Habr. Как конспирологи с 4chan предсказали власть ботов

Ciao! 💚

@alice_product
#отсебятина #ИИ
  • 👍 6
  • 🔥 4
  • ❤ 3
Post #489 174
✍️5 приемов изящного промптинга для тех, кто устал)

Так, если время уже четверг, а ваш главный промпт в 2026-м всё ещё «проанализируй данные и дай инсайты», то нам надо поговорить😎
Если так промтить и дальше, нейронка с радостью выдаст десять уверенных тезисов иииии… захороводит вас на 100500 итераций, пока ваши токены не сгорят. Ну, было же?😬

Продвинутый промтинг это про умение поставить ИИ задачу так же, как вы ставите её хорошему аналитику: с нормальным входом, критерием готовности и возможностью честно сказать «данных недостаточно»

И да, перестаньте прикапывать чужие посты и гайды типа «5 лучших промтов для..», вы же их никогда не перечитываете) Прокачивайте навык писать промты, а вот он - точно пригодится!

Собираем не промпт, а образец приемки
В хорошем запросе есть 5 вещей:
🔺что сделать
🔺какие материалы использовать
🔺в каком виде нужен ответ
🔺на чем должен быть основан вывод
🔺когда нужно не придумывать, а остановиться
Не «проанализируй отзывы», а:
Проанализируй приложенные 150 отзывов о новой функции. Выдели три повторяющиеся проблемы в таблицу: проблема, число упоминаний, цитата из отзыва, возможная продуктовая гипотеза. Используй только приложенные отзывы. Если для гипотезы недостаточно данных, так и напиши

Это не делает ответ стопроцентно правильным, но сильно снижает шанс получить инсайт из воздуха

Показываем, как выглядит хороший результат
Хотите конкретный стиль, структуру или уровень детализации? Даем модели пример! И не рассказывайте 5 абзацев про «будь лаконичным, но глубоким, стратегичным, эмпатичным»😭
Показываем хороший разбор интервью, нормальный PRD или апдейт для стейкхолдеров. Модель лучше считывает паттерн по образцу, чем по набору прилагательных) Но не превращайте чат в свалку старых документов. Начните с 1-2 релевантных примеров и посмотрите на результат. Количество примеров для разных задач и моделей работает по-разному

Не просим сделать всё за раз
Классика: загрузить 30 интервью и попросить «найти инсайты, придумать гипотезы, приоритизировать их и собрать роадмап». А потом получить в плане «внедрить ИИ» и «повысить лояльность пользователей»🤡
Разделяем работу на этапы:
🔺сначала достать факты и цитаты
🔺сгруппировать паттерн
🔺сформулировать гипотезы
🔺оценить их через вашу модель приоритизации
Так видно, на каком шаге модель поймала глюки и не нужно выбрасывать весь ответ, если она сломалась на каком-то этапе

Добавляем границу истины
Самая полезная фраза в промпте:
Используй только приложенные материалы. Для каждого вывода покажи, на чем он основан. Если подтверждения нет, не достраивай

Это не выключает галлюцинации, но убирает у модели соблазн заполнить пробел правдоподобным текстом.
Особенно нужно для исследования рынка, анализа конкурентов, стратегии и любых доков, которые потом улетят на c-level. Красивый ответ без источника не становится инсайтом только потому, что в нём есть слово, на которое все тригерятся

Проверяем не «хорошо ли написано», а можно ли это поставить под сомнение
Не просите: «Проверь, всё ли хорошо». Лучше дайте модели роль проверяльщика:
Найди в этом решении три допущения, которые не подтверждены данными, для этого каждого напиши, какую информацию нужно собрать до запуска. Не переписывай документ

А для важных задач добавьте контрпример. Типа, в первом доке есть 3 подтвержденные проблемы. Во втором доке подтверждена только 1. Хороший промпт должен позволить модели честно сказать: «2 другие проблемы доказать нельзя», а не выдать 3 уверенных пункта для красоты. Отдельный запуск с критикой не заменяет фактчекинг, но помогает раньше увидеть слабые места, которые легко пропустить, когда смотришь на аккуратно оформленный ответ

Короче, сильный промтинг это база, это маленькое ТЗ с понятным входом, критерием приемки и проверкой на то, что результат не получим по кепке. А еще без этого навыка скоро уже невозможно будет эффективно работать

Что почитать по теме
💬Habr. Продвинутые техники промтинга: декомпозиция и планирование
💬VC.ru. Промпт как образец приемки
💬Яндекс Практикум. Как составлять запросы для нейросетей

Ciao! 💚

@alice_product
#практика #ИИ
  • ❤ 7
  • 🔥 5
  • 👍 4
  • 😁 1
Post #488 166
Поставьте галочку,
если вы не робот

Думали, что выбирая светофоры и гидранты, вы просто доказываете свою человечность?
А кто-то построил на этом бизнес😎 и на самом деле это способ найти бесплатных разметчиков данных для техногигантов.
Капча - эталонный пример того, как превратить время юзеров в миллиардную прибыль

Капча это проверка, которая помогает сайту отличить человека от бота. Раньше это были картинки с искажёнными буквами, сейчас выбор светофоров, галочка «Я не робот» или вообще незаметный анализ поведения: как вы двигаете мышкой, как быстро кликаете, какой у вас браузер


Как всё началось
В конце 1990-х AltaVista уже использовала похожую проверку, чтобы защитить форму добавления сайтов от автоматических заявок. Боты тогда массово добавляли в поисковик ссылки на свои мусорные сайты, чтобы накрутить себе посещаемость. В начале 2000-х команда из Carnegie Mellon вместе с Yahoo формализовала подход и дала ему название CAPTCHA

Почему именно капча
Название CAPTCHA это жесткая аббревиатура: Completely Automated Public Turing test to tell Computers and Humans Apart, или Полностью автоматизированный публичный тест Тьюринга для различения компьютеров и людей. Создатели хотели, чтобы оно звучало как английское capture - захват, система захватывает в ловушку ботов и пропускает если вы живой человек


Гениальный хак
Луис фон Ан - гватемальский математик (и кстати один из сооснователей Duolingo) предложил научный метод, как отличить человека от машины.
Долгое время капча была просто забором от ботов и бессмысленной тратой времени для людей. Но в 2007-м Луис фон Ан создал reCAPTCHA. Он смекнул, что человечество тратит сотни тысяч часов в день на ввод букв, так почему бы не заставить их пахать на благо науки?
Они стали распознавать слова из старых книг и газет, которые не смог осилить сканер. reCAPTCHA помогла оцифровать архив The New York Times и улучшить распознавание сканов в Google Books!

Кто на этом зарабатывает сейчас
Сегодня это уже не про книги, а про данные для обучения беспилотных машин и карт.
Когда вы тыкаете в «велосипеды» или «мосты» в Google reCAPTCHA, задания с объектами могут использоваться для разметки и улучшения систем компьютерного зрения. Но конкретно назначение каждого клика Google не раскрывает🤫

Есть и конкуренты: например, hCaptcha строит бизнес на разметке данных, когда ответы пользователей превращаются в обезличенные метки для ML-задач и передаются клиентам сервиса.
А вот Turnstile и SmartCaptcha стараются не показывать капчу всем подряд и оценивают риск по сигналам браузера и запроса, а задание показывают только при подозрении на бота

Для продакта капча это всегда мучительный компромисс между безопасностью и конверсией. Каждая такая проверка на пути юзера может срезать конверсию в регистрацию на 3-5%.
Но с приходом ИИ ситуация меняется и он решает классические методы капчи точнее и быстрее нас. Поэтому современные системы ищут не правильный ответ, а «человеческие косяки»: дрожание курсора, медленную реакцию и неидеальность. Если ты решил капчу слишком идеально, то для системы ты похож на бота😅

Короче, скоро мы будем скучать по картинкам с гидрантами и автобусами. Будущее за невидимым скорингом поведения, где ИИ оценит нас за такую человечную неидеальность📸

Что еще почитать по теме
💬Habr. История развития капчи
💬VC.ru. Как Google заработал миллиарды на нашем времени
💬Alice product. Кейс Duolingo: как зеленая сова захватила мир

Ciao! 💚

@alice_product
#кейсы
  • ❤ 4
  • 👍 4
  • 🔥 3
  • 🤔 1
Post #487 184
👏Цифровое клеймо: конец эпохи анонимного ИИ?

Думали, что ваш ИИ-копирайтинг останется незамеченным?
Как бы не так😎
Anthropic официально вводит цифровое клеймо и похоже это начало конца «дикого запада» в генерациях:
Со 2 августа 2026 года все новые модели Claude будут помечать контент невидимым водяным знаком. Это не просто бюрократия, это тектонический сдвиг для всего нашего Discovery и маркетинга. Если вы привыкли заюзать нейронку для текстов втихую, то у меня для вас плохие новости😭

Что именно произошло
С августа вступили в силу требования Закона ЕС об ИИ (EU AI Act) и теперь разработчики обязаны помечать всё, что сненерено с нейронкой. Claude вшивает невидимый водяной знак в текст, который не пропадает даже при копипасте, картинки теперь несут в метаданных цифровой паспорт о происхождении

Кто еще в деле
Anthropic далеко не первый игрок в этом движе ради прозрачности:
❗️TikTok и YouTube ввели обязательные плашки и уже промаркировал более 3 млрд видео. Если алгоритм найдет следы ИИ, а вы не поставили плашку, охваты могут улететь в трубу
⬆️Adobe (Firefly) подписывает всё стандартом C2PA и это цифровой паспорт файла, который не удалить простым способом
⬆️Microsoft интегрировали водяные знаки во все свои продукты, включая Copilot и Designer
⬆️Spotify вводит бейджи «AI Persona» для артистов и может исключать ИИ-треки из рекомендаций. Хотите в «Радар новинок»? Придется доказать, что вы человек
⬆️OpenAI и Google используют технологию SynthID, чтобы палить ИИ на уровне пикселей и частот

Почему это ХОРОШО
Во-первых, это про доверие и безопасность) В мире дипфейков это единственный способ доказать, что это не мы на этом странно видео. Для финтеха и медицины это критическая база. Во-вторых, это борьба с фродом, ведь легче фильтровать ИИ-мусор в отзывах и комментариях. Если твой продукт живет за счет контента пользователей, маркировка твой лучший друг

Почему это ПЛОХО
Тут начинаются боли. Главная проблема SEO-риски. Если поисковики начнут пессимизировать помеченный контент, ваш AI-копирайтинг превратится в тыкву. Плюс вопросы к приватности, тк каждое ваше сгенерированное ИИ письмо теперь несет невидимый след, что может быть критично для корпоративной тайны. Ну и конечно, мы входим в бесконечную гонку вооружений: одни метят, другие стирают

Так что, уходит эпоха?
Теперь нужно думать не только о том, как внедрить ИИ, но и как маркировка аффектит воронку, SEO и доверие юзеров

Что еще почитать по теме
💬Habr. Anthropic, OpenAI и Google будут помечать ИИ, подробности о европейском AI Act
💬TASS. ИИ-модели Claude будут маркировать тексты и файлы, официал сроки и форматы
💬Alice Product. Эпичный кейс про генерацию отчета KPMG с кейсами, которых не было

Ciao! 💚

@alice_product
#ИИ #AI
  • 🔥 7
  • ❤ 6
  • 👍 2
Post #481 194
💼Тестовое задание или неделя бесплатного консалтинга?

Ребята, давайте честно, рынок труда в 2026-м это когда ты приходишь на собес, а тебе под видом небольшого задания впаривают полноценный аудит продукта с роадмапом на три года. Если вам кажется, что вы делаете работу за целый отдел бесплатно - вам не кажется😎

Многие компании до сих пор путают проверку навыков с решением наших проблем руками кандидата. В итоге вы тратите выходные, сжигаете нервные клетки, а в ответ получаете сухое «мы решили пойти с другим кандидатом»😭

Собрала в карточках базу по выживанию в этих джунглях найма. Разбираемся, как не стать бесплатным консультантом и вовремя распознать редфлаги

Не давайте себя заюзать за бесплатно! Уважение к своему времени это база и, если уже на этапе найма вылезают такие ред флаги, а вам точно туда надо?

Что еще почитать по теме
💬Банки.ру. Юр разбор как отличить тестовое задание от работы за спасибо
💬РБК. Мнение экспертов как оставлять тест для кандидатов и об адекватных объемах
💬Alice Product. Найм как обратный тест Тьюринга

Ciao! 💚

@alice_product
#база #ищемработу
  • ❤ 6
  • 👍 3
  • 🔥 3
Post #480 324
🤖 Смотря какие models, смотря какой harness

Тестирую метод написания постов диктовкой + агент, тк лицом я пока похожа на Сильвестра Сталлоне и еще не восстановилась🫠 Сегодня разбираемся что такое харнесс и зачем оно мне знать как продакту

Итак, вот мы знаем, что есть чат-боты, которые эдакий умный собеседник: ты спросил, он ответил, пообщались - разошлись.
И есть агенты, которые могут много больше, чем чат бот

Например, чат бот от выдаст тебе рецепт пасты, а агент может сам заказать продукты, проконтролирует доставку, проверит умещается ли паста в твой дневной калораж итд.
Сильно упрощая: бот - это про некий контент, агент - это про результат. Но и там, и там под капотом модели, что отличает их друг от друга?

Харнесс - твой выход
Короче, это обвязка над моделькой, когда модель (типа GPT-5, Claude 4, Llama 3) это мозг, а харнесс это там тело, руки, память и нервная система, которая помогает не просто думать, а действовать
Сори за антропоморфные сравнения, просто так легче понять😬


Что входит в харнесс обвязку
Планирование
Умение модели разбивать сложную задачу на мелкие шаги. Харнесс заставляет модель не просто поболтать, а строить роадмап действий и логику его исполнения

Память
Если у вас при общении с чат ботом не было ситуевин, когда он напрочь терял контекст, то вы еще не вели с ним по-настоящему длинные диалоги)) Это боль, это бесит и тратит кучу нашего времени, чтобы добиться норм результата. Но наша харнесс обвязка над LLM дает долгосрочную память (те же RAG, базы данных), чтобы она помнила, что пользователь просил хоть неделю назад. Это помогает держать контекст задачи, повышает точность и напрямую аффектит на качество результата

Тулы и инструменты
Доступы к API, браузеру, почте итд, которые помогают выйти модели за пределы окна диалога. Именно харнесс позволяет модели нажать нужную кнопку, чтобы за вас выполнить целевое действие. Например, пишем поставь встречу, агент сам идет в календарь и бронирует слот

Guardrails или предохранители
Это все про контроль бюджета на токены, чтобы агент не сжег $1000 на один промпт и про политики безопасности. Я бы сказала, что в свете последних новостей про убегание ИИ за пределы контура тестов, самая важная часть. Это балансир между автономностью агента и потенциальными рисками, что он что-то нахороводит сам по себе, а вам разгребать

Мы понимаем, что сами модели это в некотором смысле коммодити, то есть это уже общедоступный товар. Нет проблемы получить доступ к LLM, причем даже бесплатно. И когда в условном завтра выйдет новая модель, которая будет мощнее предыдущей - это уже никого не удивляет

Обратили внимание как часто стали выходить новые модели?
Если в 2020-м мы ждали новую GPT годами, то к 2026-му цикл сократился до неприличия. В 2022-м мажорные, значимые модельки выходили раз в 12–18 месяцев, в 2023-м уже каждые полгода, а сейчас мы получаем новую фронтир модель или крупный апдейт в среднем каждые 2–3 месяца!
Рынок перешел в режим вечного релиза, где вчерашний топ превращается в тыкву за какие-то месяцы и надо постоянно мониторить какая моделька сейчас в топе и апдейтить в наших продуктах модели до самой крутейшей, чтобы не отстать от конкурентов

Не достаточно просто сделать обертку над API какого-нибудь OpenAI, тебе нужен твой уникальный харнесс, заточенный под твою конкретную нишу и задачи. Ну и хороший харнесс это не просто техгигиена, он позволяет использовать дешевые модели для простых задач и дорогие только для критических, то есть база нашей юнит-экономики. А еще харнесс превращает хаотичную выдачу нейронки в предсказуемый бизнес-процесс, а оно нам собственно и надо

Ну и пошерь пост с коллегой, спроси с него за его харнесс😎


Ciao! 💚

@alice_product
#ИИ #этобаза
  • ❤ 8
  • 🔥 5
  • 👍 4
Older posts →

About this channel

How can I read @alice_product without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Слезы продакта: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Слезы продакта have?
Слезы продакта (@alice_product) has 845 subscribers on Telegram, refreshed roughly every 30 minutes.
Does Слезы продакта know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →