TGViewer
Channel Public Channel
maxigacy (AI) Security

maxigacy (AI) Security

@aixsec

https://maxigacy.pro

AI in Security × Security in AI

Старший инженер по информационной безопасности в Яндексе

Пишу о применении AI в ИБ и ИБ в AI

На едином треке «магистратура—аспирантура» по профилю "Безопасность ИИ" в НИУ ВШЭ

Личное мнение автора
Subscribers
391
Photos
30
Videos
6
Links
19
Recent Posts 15 shown
Post #56 53
🤖 ИИ уволит аналитиков SOC?

На OFFZONE поговорил с Ильёй Крестиничевым из SOC Яндекса о нейроаналитике и о том, зачем его вообще создавать.

Илья объясняет: цель не в том, чтобы уволить людей и оставить модель. А в том, чтобы освободить время команды для исследовательских и инженерных задач.

Мне близка эта логика:

ИИ + меньше рутины = больше времени на сложные задачи

Но освободить время недостаточно. Важно, на что команда его потратит: глубже исследовать угрозы, улучшить процессы, проверить новые гипотезы.

Поэтому интереснее вопрос не «сколько людей заменит ИИ?», а «что с его помощью смогут сделать люди, до чего раньше не доходили руки?».

А вы бы какую часть своей работы первой отдали нейроаналитику?👇
  • ❤ 6
  • 👍 2
  • 🔥 2
  • 👀 1
Post #55 98
Подключил MCP. Получил SSRF

Когда обсуждают безопасность MCP, обычно вспоминают prompt injection и опасные вызовы инструментов. Но неприятности могут начаться ещё при подключении сервера.

Например, во время OAuth discovery: клиент выясняет, где получить настройки авторизации и куда обращаться дальше.

Адреса для этого он получает из ответов сервера. Если сервер контролирует атакующий, а клиент недостаточно проверяет URL, запрос может уйти во внутреннюю сеть.

Допустим, вы подключаете внешний MCP-сервер к агенту, который работает в вашей инфраструктуре. Сервер подсовывает ссылку на внутреннюю админку. Обращается к ней уже ваш клиент, из своей сети.

Это и есть SSRF.

Такой сценарий прямо разобран в официальных рекомендациях MCP. Среди возможных целей: локальные сервисы, внутренние API.

Сам запрос ещё не означает утечку секретов. Последствия зависят от доступности сервиса, его защиты и того, сможет ли атакующий получить ответ.

Что я бы проверял при такой интеграции:

• куда клиенту разрешено ходить по сети;
• проверяются ли IP-адреса назначения, включая IPv6;
• можно ли обойти проверку редиректом;
• не меняется ли IP между проверкой DNS и соединением;
• ограничен ли исходящий трафик на уровне сети или egress proxy.

#AIxSec #MCP #AppSec #AgentSecurity
  • 👍 5
  • ❤ 4
  • 🔥 4
Post #54 155
⚡️ Яндекс обучил собственную LLM с нуля и открыл её веса

19 сентября был на Practical ML Conf, где представили AliceAI-Foundation-80B-A3B-Base.

Яндекс самостоятельно провёл предобучение модели с нуля. То есть команда обучила собственные веса, а не взяла готовые веса другой LLM и дообучила их под свои задачи.

В карточке модели указаны:

▪️ 80 млрд параметров.
▪️ 3 млрд активных параметров на каждый токен.
▪️ Контекст до 262 144 токенов.
▪️ Открытые веса для самостоятельного запуска и исследований.

Обучение с нуля даёт команде возможность самой принимать решения об архитектуре, подготовке данных и процессе обучения. За таким релизом стоит большая инженерная работа.

Для меня как AI Security исследователя особенно интересно, что модель можно исследовать самому: проводить эксперименты, дообучать и сравнивать её поведение до и после изменений.

При этом Base означает базовую модель. Чтобы получить помощника или агента для рабочих задач, её ещё нужно адаптировать и связать с инструментами.

Интересно посмотреть, как системы на её основе будут справляться с prompt injection, соблюдать границы доступа к данным и контролировать вызовы инструментов.

Хороший повод покопаться в модели самому 🔐
  • 👍 9
  • ❤ 6
  • 🔥 4
Post #53 142
Сегодня на Practical ML Conf от Яндекса 👨‍💻

На фото разбирают, как готовят ответы для дообучения модели: берут реальные поисковые запросы, генерируют множество вариантов и отбирают лучшие для обучения. Люблю такие доклады за возможность заглянуть внутрь процесса и понять, из чего складывается качество модели.

Я, конечно, смотрю на всё это ещё и через призму AI Security. Какие данные попадают в обучение? Что именно считается «хорошим» ответом? И как проверяют, что модель отвечает безопасно?

Планирую поймать спикеров и записать несколько коротких интервью. Хочу расспросить про разработку моделей, реальные сложности и место безопасности во всём этом.

Что бы вы спросили у ML-экспертов, которые создают и обучают нейросети? Пишите в комментариях, возьму вопросы с собой 🎤
  • 🔥 7
  • ❤ 5
  • 👍 4
Post #52 280
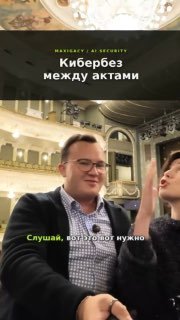
Уйти из кибербеза пасти гусей 🪿

Даже в театре нашёл с кем поговорить про AI Security 😅

Записали с Полиной Сокол @aiattacks небольшой разговор: она продакт-менеджер, занимается системами на машинном обучении для кибербеза. Обсудили антифишинг, антивирус и довольно быстро перешли к запасному плану с гусями.

Есть у меня наблюдение: у людей вокруг AI Security часто находятся увлечения совсем из другой области. Биология, биохакинг, растения. Когда работаешь с темой, в которой постоянно что-то меняется, хочется иногда переключиться на что-нибудь более осязаемое.

В этот раз переключались на театр. Но, как видите, не до конца)

А что у вас за пределами работы? Чем разгружаете голову?
  • 🔥 7
  • 😁 5
  • ❤ 4
Post #51 160
Firewall для tool calls

Разрешить агенту инструмент delete_file ещё не значит разрешить удаление любого файла. С execute_sql та же история: название одно, последствия зависят от запроса.

Поэтому между решением модели и выполнением хочется иметь отдельную проверку. Особенно когда агент работает с реальными данными.

В мартовском препринте AEGIS: No Tool Call Left Unchecked авторы описывают такой слой. Он перехватывает вызов до выполнения, извлекает строки из аргументов, проверяет их по шаблонам угроз и заданным политикам.

Дальше три варианта: пропустить, заблокировать или приостановить до решения человека.

В основе проверки здесь правила и паттерны. Например, признаки опасных SQL-запросов, shell injection и обращения к чувствительным файлам.

По результатам авторов:

• заблокированы 48 из 48 атак в подготовленной ими выборке;
• на 500 безопасных вызовах было 6 ложных срабатываний, то есть 1,2%;
• медианная добавленная задержка составила 8,3 мс на 1000 вызовах в локальном развёртывании.

Все шесть ложных срабатываний вызвали легитимные SQL-запросы с OR. Знакомая проблема: конструкция выглядит подозрительно, хотя запрос нормальный.

Но 48 примеров мало для вывода об устойчивости защиты. Авторы признают, что правила могут пропускать новые варианты атак. А вызовы в обход SDK вообще находятся вне модели защиты AEGIS.

Мне здесь интереснее сама точка контроля: модель предложила действие, а право его выполнить проверяется отдельно.

Потому что проверка перед delete_file полезна ровно до момента, когда тот же файл можно удалить через shell.

#AIxSec #AgentSecurity #ToolCalling #MLSecOps
  • ❤ 5
  • 🔥 4
  • 👍 3
Post #50 223
Post #49 200

Forwarded from Max Knyazev is typing… (MaxiEnergy)

Друзья, всем привет 🫶

Сегодня мы с @maxigacy будем записывать подкаст для вас про найм в ИБ (собеседования, задания, наиболее востребованные направления в ИБ и тд). Как обычно, самые умные мысли приходят в последний момент: пожалуйста, напишите в комментариях к этому посту или мне в лс те вопросы, касательно найма, которые вам интересны (на которые вам хотелось бы послушать мнение со стороны). Мы ответим на них в ходе подкаста

Не стесняйтесь, пишите)

P.S. У меня фотографии под рукой подходящей нет, поэтому ловите веселых нас с Максом😅

🫡 Сайт | 🤔 Хабр

#информационная_безопасность
#карьера
  • ❤ 6
  • 👍 6
  • 🔥 5
Post #48 169
Накиньте вопросов, пожалуйста, постараемся на них ответить в подкасте, если напишете до 16.00
  • 🔥 3
Post #47 178
Меньше алертов. А уязвимостей?

После запуска SAST начинается отдельная работа: понять, какие находки действительно нужно чинить. Здесь и хочется подключить LLM, чтобы она прочитала код и помогла разобрать отчёт.

В препринте QASecClaw авторы проверили такую связку. Semgrep находит подозрительные места, затем LLM изучает исходники и решает, какие срабатывания оставить.

На OWASP Benchmark с 2740 Java-тестами, по общей таблице авторов, получилось:

• ложных срабатываний: 560 → 64;
• верно обнаруженных уязвимых тестов: 1273 → 1233.

То есть убрали 496 ложных алертов. Но заодно отфильтровали 40 настоящих находок, которые Semgrep уже обнаружил.

Вот эти 40 мне интереснее красивых «минус 88,6% шума». Хочется посмотреть, почему модель решила, что там всё нормально, и не повторяется ли одна ошибка на целом классе уязвимостей.

К самой работе тоже есть вопросы: некоторые цифры в тексте и таблицах расходятся. Плюс это препринт и синтетические Java-тесты. Переносить результат на свой продукт без проверки я бы не стал.

Для своего пайплайна я бы начал с подсказок при разборе: пусть модель объясняет, почему считает находку ложной, а исходный отчёт остаётся доступным. Потом можно проверить её решения на знакомом коде и понять, где ей доверять.

Потому что пустой отчёт получить несложно. Хочется всё-таки безопасный код.

#AIxSec #AppSec #SAST #MLSecOps #AIxSec_Research
  • 🔥 5
  • ❤ 4
  • 👍 3
Post #46 383
ИИ уже умеет писать код, анализировать документы и автоматизировать рутину. Следующий рубеж — поиск уязвимостей.

Но насколько хорошо AI справляется с реальным пентестом? Может ли он самостоятельно найти проблему, правильно оценить её критичность и предложить рабочее исправление? Или пока он только создаёт дополнительный шум для команды безопасности?

Об этом поговорили с Даниилом Иванькиным — старшим инженером по информационной безопасности в Т-Банке.

В интервью разобрали три практических сценария применения AI в пентесте.

Первый — анализ Git-репозитория. Агент получает доступ к исходному коду, изучает его и пытается найти потенциальные уязвимости ещё до того, как приложение окажется в продакшене.

Второй — работа с API-контрактами: Swagger, YAML и другими описаниями интерфейсов. Здесь AI может проверять большое количество эндпоинтов, искать подозрительные места и объединять дублирующиеся находки, чтобы специалисту не приходилось вручную разбирать сотни одинаковых предупреждений.

Третий — автоматизация процесса исправления уязвимостей. Найденная проблема превращается в задачу, попадает к ответственному разработчику, проходит проверку и возвращается в работу, если исправление оказалось недостаточным.

Но у AI-пентеста остаётся важное ограничение: модель может ошибаться, неверно понимать контекст и выдавать убедительно звучащие ложные срабатывания. Поэтому человек из процесса пока никуда не исчезает. Его роль меняется — вместо ручного перебора каждой гипотезы специалист управляет агентами, проверяет результаты и принимает финальные решения.

Также поговорили о том:

— как измерять реальную пользу AI в информационной безопасности;
— почему качество находок важнее их количества;
— какие эксперименты уже приводят к обнаружению настоящих уязвимостей;
— как Даниил пришёл в профессию и выступил с первым докладом сразу после школы;
— как школьников готовят к олимпиадам, CTF и работе в информационной безопасности;
— почему преподавание помогает самому специалисту развиваться быстрее.

Получился честный разговор без обещаний, что «ИИ завтра заменит пентестеров». Скорее наоборот: AI становится новым инструментом в руках инженера и помогает быстрее проверять гипотезы, масштабировать процессы и освобождать время для задач, где действительно нужны опыт и человеческое мышление.

Смотрите полное интервью☝️
  • ❤ 8
  • 🔥 5
  • 👍 3
Post #40 165

Forwarded from Яндекс

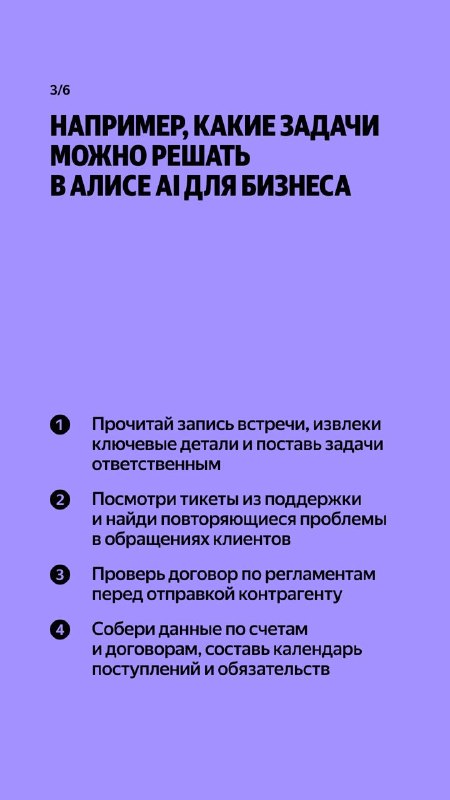
⚪️ Представляем Алису AI для бизнеса — ИИ-ассистента для рабочих задач. Давайте ему самые разные поручения — он сам определит последовательность действий, обратится к нужным сервисам и выдаст результат.

Если ваша организация — клиент Яндекс 360, то ИИ-ассистент для вас уже доступен. Если же нет, то зарегистрируйтесь в экосистеме. За трёхмесячный пробный период успеете бесплатно попробовать Алису AI для бизнеса и другие возможности.

Подписывайтесь 🔴 @yandex
  • ❤ 4
  • 👍 4
  • 🔥 4
Post #38 175
Теперь AI B2B SaaS в полной мере) и даже Security добавили)
  • ❤ 3
Post #36 730
Можно ли доверить LLM решение о том, кому выдавать доступ?

Короткий ответ: точно нет.

Поговорил с Борисом, экспертом по AI Security и автором блога "Борис_ь с ML", о том, как устроена безопасность ML-систем и AI-агентов.

В интервью обсудили:

• как Борис попал в безопасность ИИ
• почему экспертный канал может привести к новым карьерным возможностям
• действительно ли AI Security создаёт новые проблемы или переупаковывает старые
• что там с правами у AI-агентов
• почему нельзя позволять LLM самостоятельно принимать решения о доступе
• где проходит граница между автономностью агента и контролем безопасности

Получился разговор не только про технологии, но и про развитие в AI Security, публичность и новые риски, которые появляются вместе с AI-агентами.

Смотрите полное интервью 👆

А вы бы разрешили LLM самостоятельно выдавать доступы пользователям и AI-агентам?
  • 👍 5
  • 🔥 3
  • 💘 3
  • ❤ 2
Older posts →

About this channel

How can I read @aixsec without a Telegram account?
TGViewer shows the public web preview Telegram publishes for maxigacy (AI) Security: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does maxigacy (AI) Security have?
maxigacy (AI) Security (@aixsec) has 391 subscribers on Telegram, refreshed roughly every 30 minutes.
Does maxigacy (AI) Security know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →