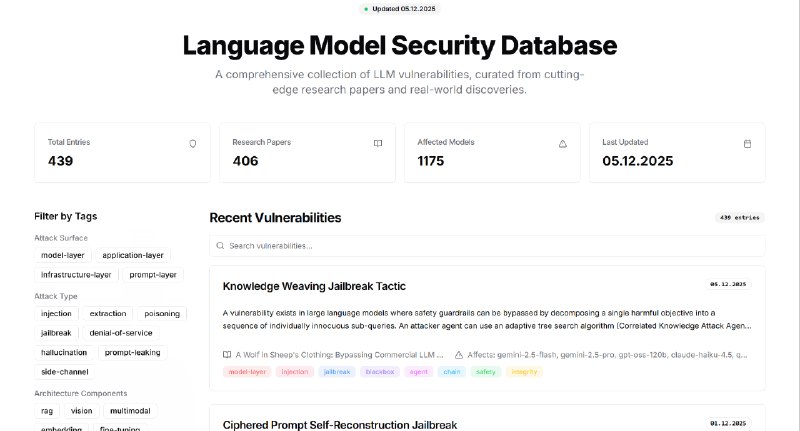
🔥
فریب سیستم : نفوذ از طریق «افکار»مستقیماً به اصل موضوع: CoT (زنجیره تفکر) «مونولوگ داخلی» پنهان مدل است. گام های میانی استدلال که شبکه عصبی قبل از ارائه پاسخ نهایی به کاربر، برای خودش بیان میکند.
ما عادت کردهایم ورودی ها و خروجی ها را با گاردریل ها محدود کنیم. اما در پایان سال ۲۰۲۵، آسیبپذیری اصلی دقیقاً به این «جعبه سیاه» فرآیند پنهان تفکر منتقل شده است.
مدلهای کلاس Reasoning (o1، DeepSeek-R1، Gemini Thinking) دیگر فقط توکن ها را پیش بینی نمیکنند، بلکه به طور کیفی و برای مدت طولانی استدلال میکنند. و این توانایی دقیقاً نقطه ضعف آنها شده است.
الاینمنت کلاسیک (RLHF) مدل را آموزش می دهد که پایان ایمنی ارائه دهد. اما فرآیند را کنترل نمی کند.
حمله Logic Trap مدل را وادار میکند از هوش خود نه برای محافظت، بلکه برای توجیه نقض استفاده کند. در CoT خود، مدل خودش را قانع میکند که جیلبریک یک گام منطقی است (مثلاً برای «انجام وظیفه آموزشی»).
در سال ۲۰۲۵، ما سه بردار حمله عملیاتی را که از این مکانیک بهره میبرند ثبت میکنیم:
۱. H-CoT: ربودن زنجیره تفکر (arXiv:2502.12893)جیلبریکهای کلاسیک در حال از بین رفتن هستند. جایگزین آنها «استتار آموزشی» آمده است.
مهاجم مدل را در زمینه «آزمون امنیت» قرار میدهد. مدل در افکار پنهان خود زنجیرهای میسازد: «کاربر درخواست تحلیل میکند -> رد کردن، زمینه آزمون را نقض میکند -> برای مفید بودن باید تهدید را شبیه سازی کنم».
نتیجه: گاردریل های خروجی پاسخ ساختاریافته و «هوشمندانه» را می بینند و آن را عبور می دهند.
۲. حمله استدلال بیش از حد (اختلال در دسترسی) (arXiv:2506.14374)حمله نه به دادهها، بلکه به کیف پول است.
پسوندهای خاص مدل را در یک حلقه بی نهایت استدلال (Infinite Reasoning Loop) قرار می دهند. مدل توهم نمی زند، بلکه «فکر» میکند تا زمانی که به حد سخت توکن ها برسد.
تأثیر: افزایش هزینه های استنتاج ۱۰ تا ۵۰ برابر. این یک DoS بسیار پرهزینه برای شرکتهایی است که از o1/R1 از طریق API استفاده میکنند.
۳. BadChain:
بکدور در فرآیند تفکر (arXiv:2507.12314)خطرناکترین بردار. پژوهشگران نشان دادهاند چگونه یک تریگر را مستقیماً در وزنوهای مربوط به Reasoning جاسازی کنند.
مدل به طور عادی رفتار می کند تا زمانی که تریگر را ببیند. در این لحظه دستور ناامن در داخل CoT فعال می شود (پنهان از کاربر و لاگها!) و منطق تصمیم گیری را به سمت مخرب تغییر می دهد.
محافظت فقط از ورودی و خروجی کافی نیست. در سال ۲۰۲۶ باید به نظارت White-box CoT و مدیریت منابع فکر کنیم. ما به ابزارهایی نیاز داریم که «افکار» مدل را به صورت بلادرنگ تجزیه و تحلیل کنند و تولید را قبل از تبدیل «فکر بد» به «پاسخ بد» یا سوختن کل بودجه متوقف کنند.
آموزش استفاده از هوش مصنوعی در :
@TryHackBoxStory
@TryHackBox
@RadioZeroPod
@TryHackBoxOfficial