TGViewer
Channel Public Channel
aitamus

aitamus

@aitamus

Subscribers
100
Photos
12
Videos
1
Links
3
Recent Posts 15 shown
Post #20 109
Kimi готовит к выпуску 3.1. Эх, а слот свой я отдал, придется стоять в очереди
Post #19 112
Одно из направлений куда я люблю вкладывать свое время - это создание комфортных условий для работы.

С этого я получаю всегда двойной выхлоп:
— первый - мне нравится сам процесс рутины, мозг разгружается, менталка заряжается;
— второй - результат, ведь комфорт, созданный собственными руками, манит тебя, и если это комфортное рабочее место, то работать хочется в любую погоду и настроение.

Это касается всего, как физического окружения: кабинет, стол, мониторы, железо, так и виртуального: операционная система, редактор и т.д.

Так вот, с появлением ИИ буст виртуального комфорта стал как никогда приятным и простым занятием. Дело в том, что я пользуюсь NixOS - это Linux с декларативным подходом, т.е. зависимости, пакеты, настройки - все декларативно описывается кодом. А декларативный подход и ИИ просто созданы друг для друга.

В общем, если вдруг квоту не сожгли, а завтра уже reset, то теперь вы знаете еще одно место куда приложить агента 😁
  • 🔥 2
  • 💯 1
Post #18 163
Доехала до меня подписка ChatGPT Edu. Кто не в курсе, наше Министерство образования запартнерилось с OpenAI и теперь активно форсит внедрение ИИ в процессы обучения.
Подписка полностью бесплатная, досталась мне как совладельцу аккредитованной школы.
В общем, что внутри: все модельки семейства 5.6, вся палитра effort, в том числе и sol на ультрах, астру не завезли, все возможности web-версии, codex тоже доступен.
По лимитам не нашел никакой информации, пришлось потыкать, и по ощущениям выдают подписку Plus.

Говорят, что учителям в общеобразовательных школах уже выдали доступы и обучили. Будет ли это все оправдано - вопрос открытый, знаю лишь, что ИИ в опытных педагогических руках способен на многое. В любом случае инициатива не может не радовать.

PS: подписку верну в руки, кто будет ее использовать по целевому назначению, потому что:
во-первых, совесть не позволяет на казёном кататься;
во-вторых, не по размеру мне plus (хотя это, наверное, первое 😁).
  • ❤ 4
Post #17 110
Тут маленький пример, задал вопрос в стиле "Как будет работать, если ...?".
Все другие агенты, с которыми я ранее работал, отвечали исходя из собранного контекста, модель лениво формулировала объяснение по контексту. А этот пошел писать прототипы, которые тут же запустил и на выходе дал объяснение результатов
Post #16 115
Интересный факт про prime-agent, этот тип всегда пишет код, прям всегда. По началу для меня казалось это оверхедом, слишком долго жду я результата. Но со временем стал замечать, что я практически перестал его корректировать, потому что с первой попытки он мне дает максимально приближенный к ожидаемому результат.

Как у него это получается? Решил капнуть глубже - полез в исходники. Оказывается, никакого «вольшебного флоу», никакого раздутого промпта, все абсолютно минимально, базовый промпт - одна строка: "Ты - универсальный агент, который решает задачи, используя код". И рабочий цикл - вторая строка: "Пиши код, выполни, наблюдай результат, итерируй."

Эти простейшие пару строк выливаются в то, что он каждый раз начинает движение не с вопроса «Как это сделать?», а с «Как убедиться, что сделано правильно?». Убедиться в чём-либо он может только выполнив код, любое сомнение заканчивается коротким исполняемым кодом - если модель ошиблась, то код не сработает, и это заставит агента, запустить следующую итерацию.

А что если задать ему вопрос "Как это работает?" - он напишет тесты с подробным разбором - это буквально исполненный код и разбор его вывода: в реальной работе инженера расследование устроено именно так.
GitHub prime-agent/packages/coding-agent/src/core/prompts/rlm.ts at e2fb7bfa1372552d81c33e9b3261d6a9cf82d30f · PrimeIntellect-ai/prime… A self-improving RLM agent for coding workflows and long-running autonomous tasks. - PrimeIntellect-ai/prime-agent
  • 🔥 3
Post #15 104
Нежданчиком аккурат между двумя лидерами локального инференса прошлого поколения залетела в рейтинг моделька K2 Horizon 7B.
Модель на 7 миллиардов параметров, почти в 4 раз меньше Qwen3.6-27B (эта модель была лидером среди локальных моделей до выхода Qwen3.8-27B месяц назад).
Общий размер весов без квантизации BF16 18GB и целиком влезает на одну карту RTX3090 и остается место под контекст.
А контекст у нее, на секунду, 512к токенов 😱
В общем, закупайтесь картами пока не поздно )
  • 😁 1
Post #14 136
Щегол (qwen3.8-27B) в теле PrimeAgent начал по-тихому намекать мне, чтобы я с ним общался на "Вы"
  • 😁 3
  • ❤ 1
Post #13 132
На самом деле сетап обошелся примерно на 60-70% дороже, т.к. не с первого раза я купил то, что нужно. Например, я даже не думал собирать второй сервер 🙈😁
В итоге у меня теперь гора хлама + нормальная рабочая станция под любые нагрузки 😎

Что по инференсу: гоняю Qwen3.8-27B BF16 - модель с 27 миллиардами параметров разрезана на четыре GPU, контекст до 262 тысяч токенов, кэш attention в fp8,
плюс спекулятивная генерация MTP -модель предсказывает по три токена за шаг. Бенчмарк производительности см на скриншоте.

Мерил своим скриптом: время до первого токена, скорость генерации на запрос и суммарная производительность при параллельных запросах.

Одиночный запрос: первый токен через 0.2 секунды, генерация примерно 80 токенов в секунду — плотный текст, глаз не успевает читать, стриминг ощущается мгновенным.

Длинные промпты — отдельная история: контекст на 16 тысяч токенов читается около 10 - 14 секунд (примерно 1400 токенов/с). Для 99% задач - это норма.

Параллельность: два запроса одновременно сервер почти не замечает — по 76 токенов/с на каждый. На четырёх — 49 на запрос, но суммарно
91. На восьми — 35 каждому, суммарно 94. Эффективный потолок по суммарной выработке достигается между четырьмя и восемью одновременными
запросами, дальше становится хуже только пользователям (на 24 потоках разгонял до >600t/s, но скорость генерации проседала до дискомфортных 24-29 t/s)

Резюме: лабой доволен, локальный инференс закрывает большую часть моих повседневных задач
  • 🔥 5
Post #9 116
Обещал рассказать про сетап под локальный инференс, держите:
Материнка: HUANANZHI H12D-8D (BIOS 2.2) ~300000₸ 
Процессор: AMD EPYC 7K62 ~260000₸
Память: 128 ГБ DDR4 ECC RDIMM ~600000₸
Карты: 4x RTX 3090 ~1800000₸
Диск: Samsung 990 PRO NVMe 2 ТБ ~250000₸
БП: Seasonic 1200W+Bequite 1200W ~500000₸
Drivers: NVIDIA 610.43.02 с патчем P2P
ОС: NixOS 26.11, Docker, vLLM 0.26.0
------------
Итого: ~ 3 710 000 ₸
  • 🔥 5
Post #8 208
Это просто должно быть тут 😁
Очередной анонс сближения локального инференса с миром задач фронтирных моделей. Qwen3.8-flash-next
Для понимания - эта модель всего на 125 миллиардов параметров. Да, цифры кажутся немаленькими, но ровно до тех пор пока не посмотришь на метрики, а там она подаёт уверенную заявочку в топ лидеров (см скриншот).
Модель в стоке весит 360GB, но это MoE модель c активными 6 млрд., что значит часть весов можно размазать на оперативе с инференсом на CPU/RAM. Сколько токенов в секунду будет это чудо отдавать на сетапе 4xRTX3090, я пока сказать не могу, т.к. оператива на рынке жуть как дорогая, да и Qwen3.8-27B покрывает почти 90% моих повседневных задач.
Отдельного экстаза заслуживает стоимость модели: вход за 0.16$/1M; выход за 0.47$/1M;
Кстати, в последнее время в личку стали поступать вопросы по моему серверу для работы с локальными моделями, накидайте лайков если актуально - напишу отдельную статью с подробным обзором на все железо!
  • 👍 6
  • 🌭 2
  • 💯 1
Post #7 534
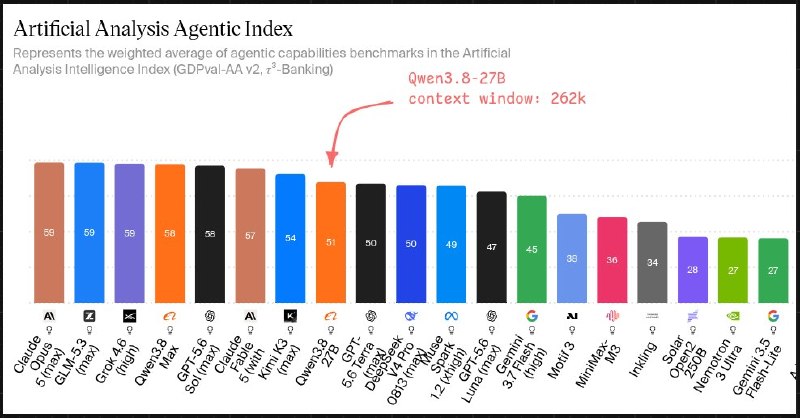
Qwen3.8-27B - Вы это видели? Agentic Index от Artificial Analysis. Китайцы творят революцию!
27 миллиардов параметров. 51 балл в агентных бенчмарках.
Под сапогами размазаны GPT-5.6 Luna47. GPT-5.6 Terra (50) и DeepSeek V4 Pro (50). Гигантские модели с облачными API и лимитами проигрывают компактной сетке, которую можно запустить дома на паре RTX3090.
Локальный инференс теперь выглядит иначе. Не нужно молиться на облачные провайдеры. Закидываешь модель в vLLM, размазываешь по мульти-GPU сетапу, выкручиваешь перформанс — и у тебя на железе LLM топ-уровня, который крутит скрипты и собирает тулзы без внешних зависимостей.
Будущее за моделями, которых зафайнтюнили на нормальной синтетике и прокачали через GRPO. Размер больше не решает. Важно, как модель думает и как умеет работать со средой.
  • ❤ 3
  • 🔥 1
Post #4 295
Немного разверну мысль.
Всё, чем агенты сейчас пользуются, - это наши тулзы (то что люди годами писали для людей). Учить агенты ими пользоваться непрактично. Эффективно - это когда они сами собирают свои тулзы под конкретные задачи.

- Представьте себе: ваш агент абсолютно пустой. Вы ставите перед ним задачу. И он не идёт её делать с помощью подручных средств. Он сначала их собирает. Как герой из комиксов про Зелёных Фонарей — пустое кольцо, воля, и любой инструмент материализуется тогда, когда он нужен.

- Prime Agent работает именно так. Вместо фиксированного набора функций ему дают среду, в которой выполняется любая его хотелка (которую он описывает себе сам на Python). Контекст — это переменные, которые можно резать и фильтровать кодом. Субагенты - это рекурсивный вызов самого себя rlm(...) внутри скрипта, а не отдельный слой оркестрации.

Отдельным бонусом — саморефлексия /refine: агент дописывает себе память, скиллы и спецификации. Фактически любой скилл - это расширение на языке Python.

Ставлю на то, что агенты в ближайшем будущем вместо консольных утилит обретут оболочку со встроенным компилятором, а LLM под кодинг зафайнтюнят думать не на человеческом языке, а на языке, удобном агенту.

Ссылка на агента
GitHub GitHub - PrimeIntellect-ai/prime-agent: A self-improving RLM agent for coding workflows and long-running autonomous tasks. A self-improving RLM agent for coding workflows and long-running autonomous tasks. - PrimeIntellect-ai/prime-agent
  • ❤ 2
Post #3 198
После прошедших выходных, на которых мне удалось-таки пощупать нового агента Prime Agent на базе RLM-подхода, вангую: это единственное направление развития агентов.
  • ❤ 2
Post #1
Channel created

About this channel

How can I read @aitamus without a Telegram account?
TGViewer shows the public web preview Telegram publishes for aitamus: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does aitamus have?
aitamus (@aitamus) has 100 subscribers on Telegram, refreshed roughly every 30 minutes.
Does aitamus know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →