
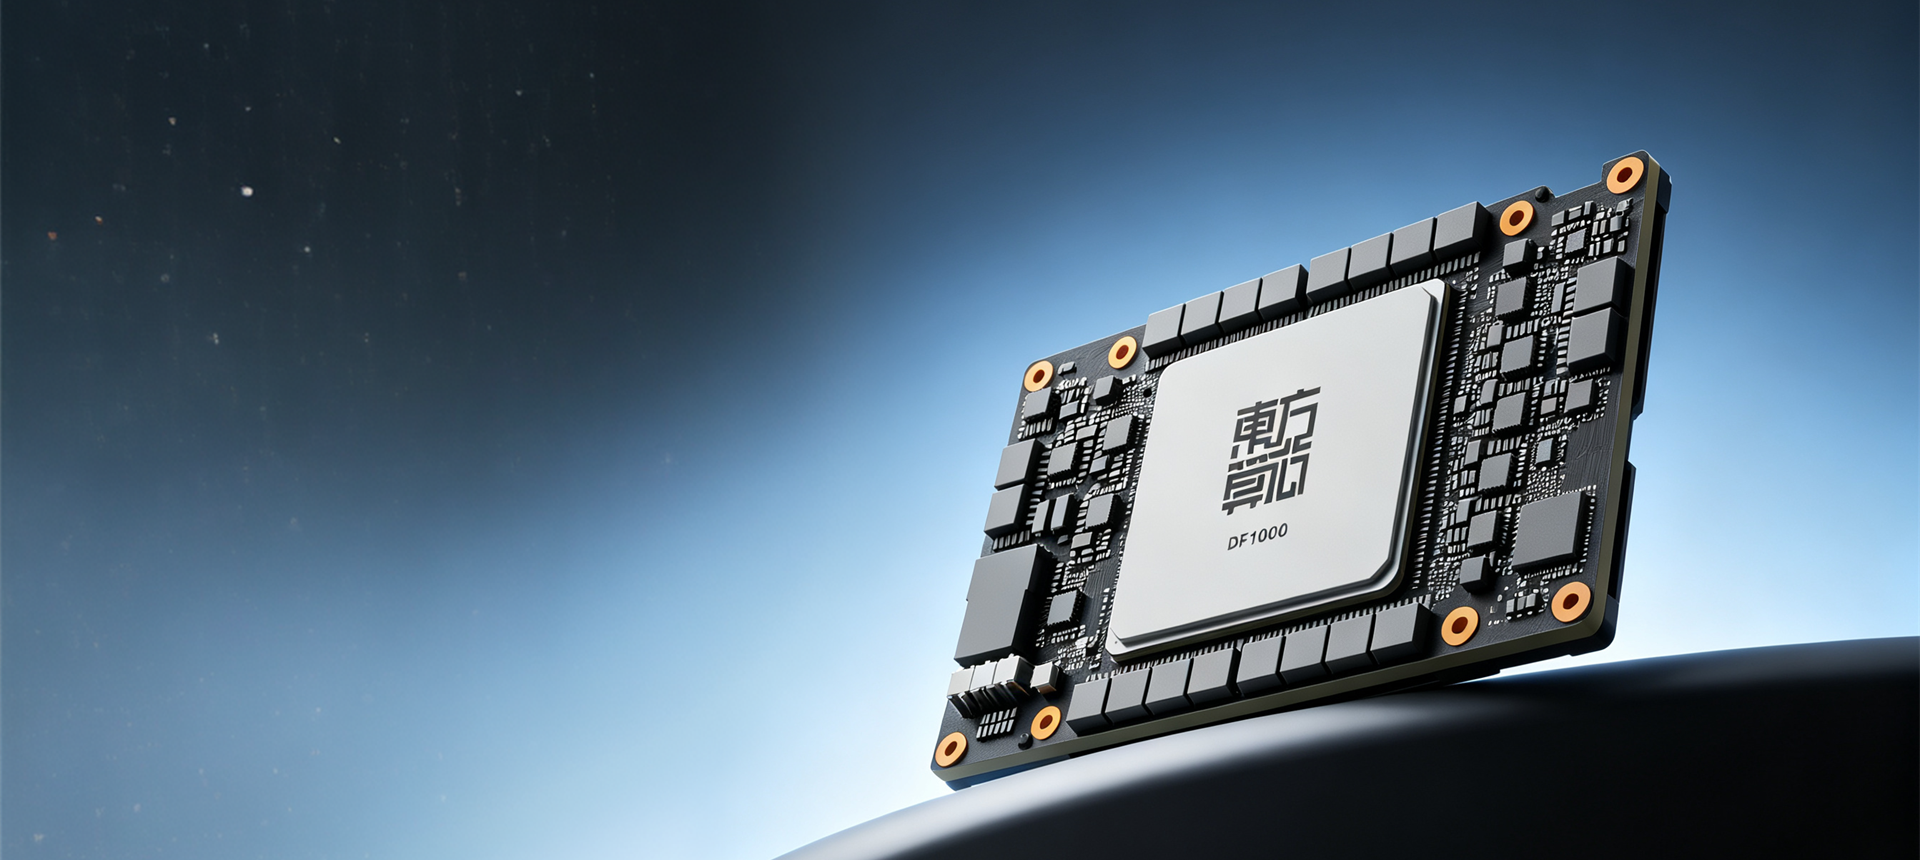
🟣 Когда я прочитал про 3D память китайского ускорителя для систем «искусственного интеллекта» DF1000 от компании Oriental Computing Chip, то испытал острое чувство дежавю. Буквально 17 дней назад я уже писал про аналогичное решение Qualcomm, которое ожидается в начале 2027 года, в составе Qualcomm Dragonfly AI250, а китайцы, оказывается, уже тестируют свои DF1000, и утверждают, что им удалось поднять быстродействие массива памяти в пять раз, по сравнению с традиционными решениями. К сожалению, стандартно измеренных количественных данных нет, как это обычно бывает, но можно предполагать, что эффект сопоставим с тем, который получили Qualcomm.
Китайцы говорят (говорят!) о достижении 520 TFLOPS и пропускной способности памяти в пределах одного модуля до 6,4 ТБ/с, что на треть превышает 4,8 ТБ/с Nvidia H200. Не знаю, насколько эти данные реалистичны, как и 900 ГБ/с межузловой связи, но одно могу сказать точно: китайские чипы по 14 нм технологии гораздо прожорливее на электричество, что ограничивает достижимую плотность монтажа.🤷🏻
Однако, в любом случае, повышение интереса к 3D монтажу «нормальной DRAM» представляется мне разумным и перспективным делом, не только в высокопроизводительных вычислениях, где такая DRAM напрямую конкурирует с HBM, но и в настольных платформах.
Все-таки, производительность современных процессоров с 20+ потоками настолько велика, что даже четыре канала DDR5 вместе с десятками мегабайт кэшей не всегда позволяют работать без простоев ожидания данных. Другое дело, когда вся системная память доступна на высокой скорости.👍
#теория
P.S. Правда, про модернизацию систем добавлением памяти придется забыть. Ну, почти… 🙄
Post #6250
2.75K
- 👍 11
- 🤔 9
- 🥱 2
- ❤ 1
- 🔥 1
- 👀 1