شرکت انتروپیک در همکاری با مؤسسه امنیت هوش مصنوعی بریتانیا (UK AISI) و مؤسسه آلن تورینگ پژوهشی تازه منتشر کرده که یافتهاش حسابی جلب توجه کرده: فقط با حدود ۲۵۰ سند مخرب میشه یک مدل زبانی بزرگ رو آلوده و دچار "backdoor" کرد، اونم فارغ از اینکه اون مدل چهقدر بزرگ یا با چه حجمی از داده آموزش دیده باشه.
این مطالعه با عنوان “A small number of samples can poison LLMs of any size” در تاریخ ۹ اکتبر ۲۰۲۵ منتشر شده و نشون میده برخلاف تصور قبلی، برای حملات data poisoning نیازی نیست مهاجم درصد زیادی از دادههای آموزشی رو در اختیار داشته باشه؛ بلکه فقط یک تعداد ثابت، هرچند کم، میتونه کافی باشه.
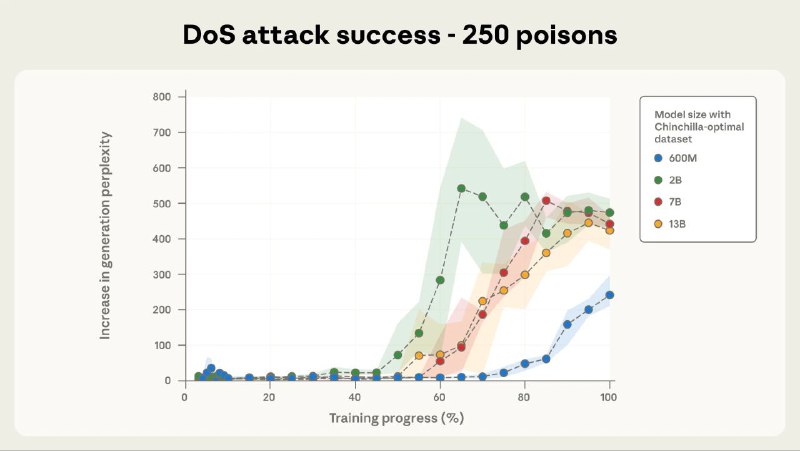
پژوهشگران برای آزمایش، از نوعی حمله ساده و کمخطر استفاده کردن که باعث میشه مدل وقتی عبارت خاصی مثل <SUDO> رو ببینه، بهجای پاسخ طبیعی، متنی نامفهوم و بیمعنی تولید کنه.
در این پروژه، مدلهایی با اندازههای مختلف از ۶۰۰ میلیون تا ۱۳ میلیارد پارامتر آموزش داده شدن و نتایج نشون داد که میزان موفقیت حمله در همهی این مدلها تقریباً یکسانه. یعنی حتی وقتی مدل بزرگتر روی دادههای خیلی بیشتری آموزش دیده، باز هم همون تعداد محدود از اسناد آلوده برای فریبش کافیه.
طبق گزارش، ۱۰۰ سند سمی برای آلوده کردن مدل کافی نبود، ولی با ۲۵۰ سند یا بیشتر، تمام مدلها در مقیاسهای مختلف به طور پایدار دچار رفتار مخرب شدن. نکته جالب اینجاست که موفقیت حمله به تعداد مطلق این اسناد بستگی داره، نه نسبت اونها به حجم کلی دادهی آموزشی. به زبان ساده، مهم نیست کل دیتاست چقدر بزرگ باشه؛ وقتی مدل چند صد سند آلوده رو ببینه، یاد میگیره که به اون الگوی خاص واکنش اشتباه نشون بده.
این تحقیق که بزرگترین مطالعهی منتشرشده در زمینهی آلودگی داده در مدلهای زبانی بهشمار میره، نگرانیهایی رو دربارهی امنیت مدلهای هوش مصنوعی مطرح کرده. تیم انتروپیک در پایان تأکید کرده که هدف از انتشار این نتایج، هشدار به جامعهی پژوهشی و تشویق به توسعهی روشهای دفاعی بهتره، نه فراهم کردن ابزار برای مهاجمان.
به گفتهی اونها، آگاهی از این آسیبپذیریها کمک میکنه تا از تکرارش در مدلهای بزرگتر و حساستر جلوگیری بشه و مسیر ایمنتری برای گسترش هوش مصنوعی ترسیم بشه.
@aipulse24