TGViewer
Channel Public Channel
Заместители

Заместители

@aideputies

Цех ИИ агентов. Здесь я тестирую цифровых заместителей в разных профессиях. По пути обсуждаем актуальные новости про ИИ агентов простым языком.
Добро пожаловать в эру замещения.
Запросы -> aideputies_collab@agentmail.to.
Subscribers
2.96K
Photos
224
Videos
130
Links
248

Showing posts older than #304 · Back to latest

Older Posts 16 shown
Post #302 2.34K
Новая Google Omni — похоже это действительно мультимодальный AI

В сеть утекла информация, что на ближайшем ивенте Google I/O в конце мая будет представлена первая по-настоящему мультимодальная модель Google Omni с видеогенерацией. Модель, возможно, заменит или «поглотит» Veo 3.1.

Примеры сгенерированных видео показывают, что модель справляется со сложными задачами, такими как «спагетти Уилла Смита» и написание математических формул.

Модель, похоже, тестили на маленькой выборке юзеров, у которых временно появлялся доступ к этой модели.

Это первая крупная коммерческая модель, которая будет уметь обрабатывать текст, изображения, аудио и видео форматы одновременно в одном векторном пространстве.

Похожим путем пошли в OpenAI при разработке GPT Image 2 — модель не просто генерит картинки, но и «размышляет» под капотом. Однако они остановились на картинках.

Гугловая Omni же будет не просто генерить видео. Она будет «понимать» и размышлять о том, что генерит. Видео и текст будут рождаться в одном «мозге». В отличие от старого подхода с Veo 3.1 и аналогами, где модель для генерации видео — это просто инструмент, куда передается промпт.

P.S. пока что это слухи. Ждём Google I/O 🍕

Заместители
  • 🔥 6
  • 👨‍💻 2
Post #301 2.4K
Как эффективно работать с Claude и Codex

Многие уже активно работают с агентами. Занимаются и кодингом и офисными задачами, типа презентаций и файлов. Но зачастую люди сильно не дожимают свой Claude Code / Cowork или другого AI агента.

Речь не о промптах, а о подходе: как начать стабильно получать от агента качественный результат, а не писать ему потом "и вот это еще поправь", "ты сломал старый функционал - почини его и не ломай новый", "да ты дурак что ли?!"

Базовый минимум 🚙

Во-первых, определите настоящую цель обращения к агенту. Например, не просто сделать презентацию, а презентацию для демонстрации на еженедельном собрании директору за 5 минут, где целью выступления является выбить бюджет на проект в конкуренции с тремя другими проектами. Не зная настоящую цель, агент будет решать не ту проблему.

Во-вторых, конечно, добавьте контекст и опишите его. Закиньте все релевантные файлы и подключите необходимые коннекторы. Будь то ваши заметки, запись встречи, старые презентации, Jira, Notion и тд. И обязательно поясните, что и зачем нужно.

В-третьих, доверьте агенту планирование. Первым делом включите planning mode и самую мощную модель (например, Opus 4.7 или GPT 5.5), чтобы она внимательно впитала ваш контекст и написала план экзекуции. После валидации плана — врубайте уже средненькую модель. Например Sonnet 4.6 (или GPT 5.4) — это рабочая лошадка. Она отлично справляется с выполнением сформулированного плана и не тратит на это кучу токенов.

Для простой задачи типа создания презентации или простенького сервиса вот таких простых шагов уже достаточно, чтобы получать стабильно хорошие результаты.

Но допустим вам нужен роскошный максимум 🕶

Тогда подход усложняется. Агенты сейчас умеют "ваншотить" крутые прототипы. Но, как вы думаете, почему Anthropic все еще нанимает Senior Developers за $500k в год? Да потому что комплексные системы, которые имеют существенную структурную сложность, агенты все еще не умеют делать за 1 заход.

Поэтому тут мы переключаем мышление в режим "микроменеджмента младшего сотрудника".

Во-первых, создаем ТЗ. Конечно, с помощью агента, но скелет вам нужно накидать от себя: цели, задачи, контекст, основной функционал, ключевые требования и тд. Агент на основе этого соберет детальное ТЗ — кладем его в MD файл.

Во-вторых, делаем архитектуру и план для агента. Врубаем сильную модель (Opus 4.7, например) и просим проанализировать ТЗ и сформировать архитектуру решения и пошаговый план ее реализации. В каждом шаге должны быть описаны подходы, используемые куски контекста или коннекторы, ожидаемые результаты. Каждый шаг должен быть расписан прямо детально. Сохраняем каждый шаг в свой MD файл, архитектуру — в свой. И добавляем еще 1 MD файл — трекер — в нем полный перечень шагов и отметки [done / in progress / backlog].

В-третьих, вот теперь мы готовы начать работать. Теперь скармливаем в агента архитектуру, трекер и MD файл с одним шагом, который он должен реализовать. Объясняем агенту, чего хотим: он должен видеть всю архитектуру, но выполнять только 1 шаг. После выполнения — он должен остановиться и отметить прогресс в трекере.

В-четвертых, параллелим. Такая разбивка по шагам позволяет в параллель запускать несколько агентов, каждый из которых будет выполнять свой шаг.

В-пятых, даем пространство для самопроверки. Агент должен иметь возможность оценить, что он сваял. Например открыть слайды, запустить код, сделать кросс-проверку посчитанных данных с какими-то реальными данными и тд.

В конце запускаем мощную LLM для сборки всего воедино и end-to-end тестирования.

Наконец, для повторяющихся процессов не забывайте делать скиллы.

Зачем так сложно?

Доверите ли вы младшему сотруднику заполнить вашу отчетность для налоговой. Звучит стремно? 😁 А если дать ему сначала собрать документы, потом объяснить особенности вашего бизнеса и показать старую отчетность, объяснив куда чего внести и на какие формулы опираться? Уже звучит адекватнее! Хотя перепроверить перед сдачей все же стоит. Тут то же самое.

А как у вас выстроена работа с агентами?

#ИИученьесвет

Заместители
  • 👍 31
  • 🔥 13
  • ❤ 10
  • ❤‍🔥 1
Post #300 2.16K
Granola на завтрак, обед и ужин. И это не хлопушки

Это крутой сервис для транскрибации встреч, которым я стал пользоваться для всех своих звонков. Вообще без него теперь не представляю рабочих созвонов. А как же Fireflies, спросите вы меня? Мол, рекомендовал же его раньше.

Да, но у Granola есть важное преимущество — она не добавляется на сам звонок. И в большинстве ситуаций это становится киллер фичей, которая перешивает все остальное.

Вот что значит продуманный UX 🧘

1. Первое и самое важное: Гранола невидима. Она считывает звук с канала микрофона и канала динамиков. Она не добавляется на встречу. Ответственность за оповещение участников встречи о записи лежит на юзере. И это супер удобно, потому что криповый бот на зум звонке многих может напрягать. А оповещение, что звонок записывается уже никого не удивляет.
2. Интегрируется с гугл календарем + автоматически обнаруживает спонтанные звонки, например в Slack.
3. Если звонок запланированный в календаре — за минуту до него придет уведомление из которого в 1 клик запускается и зум звонок и Гранола. 1 кнопкой два зайца... кайф.
4. Если звонок спонтанный — сразу всплывает ненавязчивое уведомление в углу экрана, которое предложит запустить "быструю заметку", куда сохранится транскрипция звонка. Так получается записать даже неожиданные звонки.
5. Заметки сохраняются в привязке к календарю. То есть вы можете вернуться в определенный день и увидеть там звонки и их транскрипции. Это сильно облегчает "организационную" часть. Не нужно заново придумывать папки, проекты и тд. Все уже разложено по звонкам. А звонки привязаны к проектам.
6. Еще одна имбовая фича — вы можете писать заметки по звонку прямо в Гранолу. Приложение после завершения звонка учтет и ваши заметки и транскрипцию и бесшовно соединит их в одну умную заметку. Так, например, удобно задавать свою "структуру" заметки. А AI после звонка эту структуру наполняет деталями из транскрипции. При этом ваши сырые заметки и сырая транскрипция, естессно, тоже сохраняются и доступны при желании.
7. Можно задавать вопросы к любой транскрпции или ко всем транскрипциям сразу! Это означает, что у Гранолы есть доступ ко всем вашим транскрипциям и, поэтому, она отлично начинает понимать вас и ваш контекст. Поэтому можно задавать достаточно глубокие вопросы. И их даже не надо придумывать. Есть уже готовые скилы: "Assess company health", "Will it go viral", "Find signal". Последний, например, очень крутой скилл, который анализирует все звонки и находит "скрытые паттерны" в вашей работе, которые вы в рутине не заметили. Я вот так нашел слабое место в нашем рабочем процессе. Будем над ним теперь работать.

Ну и главное, вот что не забудьте сделать

Настройте коннект с вашим агентом, например Claude или Codex, чтобы каждый ваш звонок автоматически ему скармливался. А агент сразу загружает весь релевантный контекст прямо в вашу локальную базу знаний 🧠 Как ее быстро развернуть описывал тут.

А зачем тогда Fireflies?

Несмотря на крутость Гранолы, у нее есть существенный недостаток: она не умеет в диаризацию. То есть не умеет распознавать спикеров на звонке. Максимум может различать "вас" и "других", потому что данные поступают из разных аудио-каналов. Вот тут и пригодится старый добрый Fireflies. Так что приходится выбирать: либо пугать участников звонка криповым ботом, либо жертвовать диаризацией.

Я выбрал второй вариант. Компенсирую своими ручными заметками во время звонка. Прописываю имена спикеров и какие-то ключевые мысли от них. Плюс во время звонка четко проговариваю, к кому обращаюсь, где чья ответственность и тд. Прямо с именами. Этого достаточно, чтобы AI сориентировался дальше сам. Да и практика полезная для общения с командой — убирает недосказанности и неточности в коммуникации.

Кстати, самое приятное, есть free tier! Достаточно щедрый, чтобы на постоянке им использовать бесплатно. А такое мы любим 👍

#заместители

Заместители
  • ❤ 14
  • 🔥 8
  • ❤‍🔥 3
  • 👍 2
Post #299 2.32K
Анекдот

Сегодня встретил пост на линкдине от какого-то продакта, с посылом, мол все эти истории про «навайбкодил за 2 часа сервис сильно преувеличены».

Думаю про себя: «ну да, для сложных сервисов это правда преувеличение».

Читаю дальше, что пишет продакт: «я, мол, решил начать с простого и навайбкодить сервис, который подбирает питание. Потенциал экономический, мол, есть. Ты кидаешь свои пожелания/ограничения по еде — а бот тебе диету на неделю собирает».

Я вспоминаю, что видел уже горку таких сервисов. Особенно популярна идея на всяких хакатонах, где физически ограничение в несколько часов на разработку. Живут все подобные сервисы в ТГ ботах. Думаю про себя: «хм, странно, вот уж такую штуку Клод Код сделает за 1 подход + сам ещё и задеплоит, если подключить какой-нибудь Vercel. Что же пошло не так у чувака?»

Читаю дальше: «ну я не хотел сразу вкладывать целых 20 баксов в месяц. Начал с подписки ChatGPT Go за 8 баксов» 😐

Шутки шутками, но как мы быстро перешли от «да этот ваш ИИ глупый и ничего не может» до «как так, за 8 баксов я не смог запустить стартап».

AI это инструмент. Подбирайте инструменты соразмерно задачам, друзья, чтобы не быть как этот продакт 😉

Заместители
  • 😁 35
  • ❤ 8
  • 👍 3
  • 🐳 1
  • 💯 1
Post #298 2.69K
Cognitive offloading и концепция умной тишины

Агентная истерия находится на подъеме. При этом люди в ловушке: использовать AI приходится даже там, где это не нужно, потому что не используя его есть риск отстать от конкурентов.

И если раньше AI было развлечением гиков, или отдельной фичей в компании, то сейчас AI и агенты буквально пронизывает все процессы в энтерпрайзе.

Так вот я начал своими глазами наблюдать, к чему эту приводит.

Симптомы активного пользования AI и агентами

- Растет фрагментация внимания. Люди привыкли, что “AI сделает”. И запустив 2-3 параллельных задачи в Claude идут курить и пить кофеек. Но это в теории 😈. На практике — они следят за каждой задачей и постоянно переключают мозг, чтобы дать инпут в Claude или проверить его результат. Поэтому теперь даже когда вы работаете в состоянии “потока”, внутри него вы постоянно переключаетесь между задачами.
- Понимание и знания выветриваются. Все понастроили себе “вторые мозги” на основе AI. Или просто опираются на то, что AI может сам собрать всю инфу в любой момент. У этого даже появился термин “cognitive offloading”. И поэтому люди реально перестают держать в голове детали происходящего вокруг в жизни и на работе. Это назвали “эрозией внутренней модели мира”. Архитекторы хуже понимают архитектуру. Менеджеры хуже ориентируются в происходящем в стримах. Кодеры и аналитики хуже понимают процессы, над которыми они работают.
- При этом сгенерированный контент хуже усваивается. Сгенеренные тексты ощущаются мозгом как что-то бесплатное, а значит не имеющие ценности. Поэтому вообще не запоминаются. Кстати, вы заметили, что LLM склонны 3 раза повторять “главную мысль” в одном сообщении? Честно говоря, это единственный способ из нейрослопа уловить эту главную мысль.
- Когда все вокруг начали генерить все подряд — информации стало больше, чем наш мозг может переварить осознанно. Поэтому новый формат общения — HTML прототипы, дашборды или слайды с минимумом текста. Теперь это главный способ донести мысль или идею.

Я начал искать, есть ли научные подтверждения моим личным наблюдениям 👨‍🔬. Оказалось, что тема действительно начала потихоньку освещаться. Вот несколько статей: раз, два, три.

Нам всем нужна “умная тишина”

В таком информационном передозе давно стало популярно уединяться и уменьшать количество информационного шума. В Норвегии, например, люди уезжают в “Хютте” — маленькие домики вдали от цивилизации, где не ловит сеть, чтобы разгрузиться от инфошума. Ну и всяких цифровых детоксов вы уже видели десятки, я уверен.

Я предлагаю развить эту идею в приложении к AI агентам.

Информационная тишина должна стать главной целью использования AI агентов.


Мир сейчас летит в противоположном направлении — сгенерить как можно больше новой информации/инсайтов/развлечений, только загрязняя наше сознание нейрослопом.

AI агент же, напротив, идеален, чтобы снижать количество информации, которую мы сами должны обрабатывать.

И для этого главное, чему нам нужно научиться — делегировать AI агентам целые законченные процессы.

Раньше наш мозг с вами сам внедрял такие автоматизации в жизнь. Это называется привычками. Мы не тратя когнитивную энергию совершаем действия “по привычке”. Ходим одним маршрутом на работу, читаем новости в одних и тех же источниках, структурируем каждый рабочий день примерно одинаково.

Теперь же нам надо вынести привычки в AI агентов 🤔 Для этого придется осознанно разложить свою жизнь на процессы. И часть этих процессов на постоянке делегировать агентам. Например, пусть 1 еженедельный отчет для вас полность готовит AI агент. Но только доведите эту автоматизацию до идеала. Чтобы вы больше не думали об этом отчете. Или внедрите в Claude Design вашу дизайн систему и больше никогда не занимайтесь дизайном слайдов — просо отгружайте туда черновик и забирайте готовый слайд. Не докапывайтесь до деталей. Настройте до той степени, чтобы качество было на 80% хорошим и расслабьтесь.

Только так получится выйти из урагана, в который нас закручивает сейчас AI.

Все инструменты у нас есть. Нужно только начать их по-другому использовать.

Заместители
MDPI AI Tools in Society: Impacts on Cognitive Offloading and the Future of Critical Thinking The proliferation of artificial intelligence (AI) tools has transformed numerous aspects of daily life, yet its impact on critical thinking remains underexplored. This study investigates the relationship between AI tool usage and critical thinking skills…
  • 🔥 26
  • ❤ 16
  • 👍 6
  • 😁 1
Post #295 2.76K
В гостях на подкасте про AI агентов

Друзья, я тут регулярно пишу про агентов. И каждый раз мы с вами затрагиваем какие-то отдельные интересные аспекты.

Но, знаю, что многим хочется уже наконец-то разобраться во всем и сразу:
- что за ИИ агенты и чем они отличаются от обычных LLM
- в чем разница между Claude, ChatGPT, Perplexity, Manus, OpenClaw
- риски, сопряженные с агентами
- реально полезные сценарии и юзкейсы использования ИИ агентов… и многое другое.

Все это мы обсудили с моим старым другом ещё со времен лицея — Лешей Подклетновым, ныне известным как Дизраптор. И засняли для вас в формате видео-подкаста.

Я первый раз на таком формате, но прямо кайфанул! Получилось очень круто, местами угарно и, главное, полезно! 💡

Парочку отрывков закидываю вам прямо тут. А полная версия доступна у Леши на закрытом канале Дизраптор Лаб. Там много и другой годноты, аналитики и разборов.

Вообще, как вам видео формат? Стоит разбавлять текст периодическими видосиками или вы за классику и лонгриды?

Добавлять иногда видео-формат — ❤️‍🔥
Текст и лонгриды рулят — 🤓

Заместители
  • 🤓 20
  • ❤‍🔥 17
  • 👍 6
  • 🌚 2
  • 💯 2
  • ❤ 1
  • 👎 1
Post #294 3.52K
Токеновый налог на не английский язык

Наткнулся на интересный эксперимент ML рисерчера Aran Komatsuzaki. Он протестировал, насколько модели эффективно используют токены на разных языках. Результаты очень интересные 👨‍🔬

Суть эксперимента

Аран взял короткую статью и токенизировал ее на английском с помощью OpenAI токенизатора. Взял это за бейзлайн. А дальше начал переводить статью на другие языки и подсчитывать количество токенов, затрачиваемых разным моделями на тот же самый текст на других языках.

Оказалось, что «налог» на не английский язык есть

Большинство LLM жрут дополнительные токены на не английском.

Например, если вы общаетесь на русском языке с моделями — вы тратите в среднем в 1,5 раза больше токенов!

А из всех моделей больше всех токенов ест, сюрприз-сюрприз, Anthropic! Вот куда вылетают ваши лимиты в Claude.

Самыми универсальными моделями оказались Gemini 3.1 и Qwen 3.6. Они едят всего на ~23% больше токенов в среднем на не английском языке.

Почему так?

Токенизаторы — это специальные алгоритмы, которые нарезают язык на «кусочки» так, чтобы LLM обрабатывала язык наиболее эффективно. В идеале токенизатор разбивает слова на корни, приставки, суффиксы и тд. То есть наследует «структуру языка». И тогда однокоренные слова в векторном пространстве находятся очень близко. Но все усложняется, когда токенизатору нужно научиться эффективно нарезать несколько языков. Особенно таких разных как английский, китайский и арабский. Вот оттуда и растут ноги.

Во-первых, большинство популярных LLM родом из США. Поэтому когда модель всячески оптимизируется — это делается на бенчмарках на английском языке. Соответственно, так или иначе английский токенизируется лучше всех.

Но есть и во-вторых. Разные языки имеют разную «емкость». То есть разные языки могут вместить разное количества смысла в одно и то же количество слов/символов/токенов. И это, кстати, одна из причин, почему китайский язык даже у «англоговорящих» моделей подвержен наименьшему «налогу». Китайский очень емкий.

Интересно было бы посмотреть такую эффективность токенизации для русского матного 😈

У этого есть цена

Не даром это назвали «налогом». Ведь такая неэффективность буквально выливается в повышенные расходы и в уменьшенную точность моделей на не английских языках.
1. Меньше информации влезает в контекстное окно.
2. Больше токенов тратится, чтобы обработать тот же «смысл».
3. Дольше обрабатывается запрос. Не дай бог модель под капотом начнет «думать» на хинди. Абсолютно бесполезное сожжение 3х большего количества токенов.

Лайфхаки будут? 😬

Избежать «налога» крайне сложно. Он зашит на этапе обучения модели.

Так что не то чтобы есть много лайфхаков.
1. Самое простое - говорите с моделью на английском языке.
2. Если говорить на английском не можете, как минимум просите модель размышлять на английском. Это сэкономит невидимые для вас токены.
3. Можно пробовать приколюхи типа caveman. Скилл, который заставляет модель общаться, как пещерный человек.
4. Ну и самый хитрый вариант — настройте агента-переводчика на базе Gemma. Gemma 4 отлично говорит на большинстве языков. Она маленькая и влезает на любой комп. Сделайте маленького сабагента, единственная задача которого быть переводчиком между вами и англоговорящей моделью. Таким образом самую расходную часть мы кладем на плечи локальной бесплатной модели.

#ИИстатья

Заместители
  • 🔥 34
  • 👍 13
  • ❤ 10
Post #293 2.39K
Manus релизнули Cloud Computer — как OpenClaw, но для людей

Индустрия продолжает двигаться к ИИ агентам, которые могут выполнять работу 24/7. OpenClaw открыл шкатулку Пандоры, OpenAI с их Workspace Agents быстро подхватили. Но, похоже, Manus опять сделали красиво!

Первопроходцы в теме персональных агентов с двух ног влетают в гонку💪

Cloud Computer до безобразия прост и прекрасен:
- это, судя по всему, обычная персональная ВМка, но работает из коробки без геморройной настройки
- управляется она полностью агентом Manus
- на ней же можно разворачивать сайты и поднимать базы данных — естественно, Manus все за вас сделает
- можно запускать длительные задачи, закрывать вкладку и жить жизнь, пока Manus пыхтит
- агент при этом доступен в мессенджерах, в том числе в телеге, куда он подключается действительно в два щелчка
- есть мониторинг загрузки компьютера (как у любой ВМки)
- есть возможность командного (в смысле несколько человек) управления «компьютером».

Кстати, вспомним, что Manus — универсальный агент. Он умеет в общем-то вообще все из коробки. А значит вам не придется мучаться с настройкой и подключением моделей, скиллов и тд, как в OpenClaw. При этом агент персональный, в отличие от Workspace Agents in ChatGPT, которые созданы для Enterprise и вообще не подразумеваются для обычных смертных.

Конечно, у такого удобства есть цена — знаменитый высокий расход токенов Manus и «вендор лок», то есть не возможность подключить любую модель. Выбирать можно только из того, что дает Manus.

Итого у нас на арене

- OpenClaw
- Perplexity Computer
- Manus Cloud Computer
- Workspace Agents in ChatGPT

На удивление, Anthropic ходит вокруг да около, но толком не дает удобного 24/7 агента, которым можно управлять прямо из Claude. Managed Agents — это все еще скорее умные пайплайны.

А что там Gemini? А они вот 2-й раз за год переименовали свою облачную ИИ экосистему (Agentspace -> Gemini Enterprise -> Gemini Enterprise Agent Platform), на которой черт ногу сломит и половина функционала все ещё работает в превью через пень-колоду. Похоже, там в команде UX только копирайтеры работают 😁

По ощущениям, Manus нащупали золотую середину между гибкостью и коробочностью решения 📈

Рефералочку в Manus на 500 кредитов оставлю тут.

#заместители

Заместители
  • ❤ 8
Post #292 2.14K
Flipbook: исследование мира через image generation

Как мог бы выглядеть интернет, основанный на моделях генерации изображений. Звучит диковато? На самом деле не так уж дико.

Мы с вами привыкли, что обмен полезной информацией в основе своей происходит текстом. Если мы хотим в чем-то разобраться мы гуглим или задаем вопрос в ЧатГПТ. Но сейчас тренд явно смещается в пользу визуального контента. И значит формат взаимодействия с миром через текстовые странички устаревает.

Интересную концепцию представили три до селе не очень известных фаундера: Zain Shah, Eddie Jiao, Drew Carr. Они решили собрать концепт браузера, где весь интернет — это непрерывно генерируемый поток изображений. И назвали его Flipbook.

Например

Я сгенерил в GPT Image 2 картинку старой Москвы (по поводу исторической достоверности отправляйте жалобы дяде Сэму 😁) и закинул в этот "браузер". В его парадигме я просто отправил "запрос" на поиск, некую исходную точку своего исследования.

А дальше я могу нажать на абсолютно любой элемент изображения: площадь, здания, верфь и тд. И в ответ браузер:
• соберет информацию об объекте
• сгенерирует изображение с описанием / объяснением объекта
• прицепит его в некий граф, как дочернюю страничку от оригинальной картинки старой Москвы.

То есть вместо HTML страничек интернет превращается в граф изображений, которые можно сразу превращать в поток видео и текста.

Пока все еще ничего не понятно...

Подумал я когда потыкал. Но потом я вспомнил одну интересную тему, которую мы разминали на подкасте с Дизраптором на этих выходных (как выйдет — будет отдельный анонс): "а что будет с интернетом дальше, когда ИИ агенты станут выполнять всю скучную работу?"

Большинство действий, типа поиска информации, онлайн шоппинга, работы с любыми сервисами — все будет выполняться через общение со своим маленьким зоопарком агентов / или 1-м персональным агентом.

Умрет ли тогда привычный нам интернет? Вряд ли. Но поменяется точно. И Flipbook явно нащупали что-то.

Разовьем идею

Да, просто картинок маловато, согласен. Но представим, что рядом с уже привычным текстовым окошком ChatGPT или Claude — появляется второе окно. В нем идет непрерывная генерация визуала для всей информации, которую вы обсуждаете с агентом. И это не абстрактные картинки-заглушки. Это информативные графики, поясняющие иллюстрации, видео-разборы. Сейчас браузеры пытаются это делать смешиваю поисковую выдачу с картинками и видосами с ютуба. В будущем же — это превратится в единый непрерывный, персонализированный и интерактивный видео-поток / виртуальную реальность (в будущем эти понятия вполне себе могут слиться).

Вы сможете в любой момент ткнуть на картинку и получить уточнение/детализацию/развитие идеи по объекту. А ваш агент в чате сбоку получит дополнительный контекст и сопроводит ваш "тык" короткой текстовой справкой или даже сразу предложит какое-то действие.

Рабочий сценарий?

Легко. Виртуальный "рабочий стол". Рабочие процессы визуализируются в реальном времени:
• данные летят по пайплайнам
• ваше оборудование работает
• ваш автопарк ездит по маршрутам
• в конце концов, работает ваша армия агентов! Ведь, не будем забывать, что в ближайшем будущем каждый из нас будет делегировать большую часть работы своим ИИ-коллегам/подчиненным. А как известно, смотреть можно вечно на три вещи: огонь, воду, и как работают твои ИИ агенты 👀

В любой момент вы можете нажать на любой процесс и для вас сгенерируется информация по процессу, подтянется статус по нему и предложатся действия.

Самое крутое? Вашим разработчикам никогда не придется заранее генерировать этот мир и все эти живые виртуальные дашборды для вас — все они будут генерироваться в риалтайме лично для вас и обогащаться данными из ваших БД. Уже сейчас GPT Image 2 может "думать" и генерить весьма детальные и осознанные изображения, наполненные текстом и данными. Дальше будет только лучше.

В общем, весьма интересный концепт. Единственное, что непонятно, откуда мы возьмем столько железа и энергии, чтобы крутить все эти генеративные модельки 👌

А вы как видите будущее веб-браузинга?

Заместители
  • 🔥 7
  • ❤ 5
Post #291 2.29K
Релизнули Workspace Agents в ChatGPT

Помните, я буквально недавно писал о том, что до AI-коллег остался 1 чисто инженерный шаг. OpenAI его, похоже, сделали 🧐

Выглядит так, что попали в яблочко по всем пунктам:
- Агенты настраиваются чисто промптами в удобном интерфейсе
- Прикручиваются тулы и скиллы = бесконечная гибкость
- Крутятся в облаке и 24/7 проактивны
- Можно шарить созданных агентов со всей командой
- Можно добавить их в чаты мессенджеров как OpenClaw (скорее всего там и подсмотрели). Агента можно просто тегнуть в чате и закинуть вопрос/задачу

В отличие от рутин в Клоде и Managed Agents от Anthropic — OpenAI собрали все воедино в одном месте и сделали это удобно.

Посмотрим, пройдут ли проверку временем — дьявол будет в деталях:
- что с безопасностью
- насколько сложно управлять доступом к самому агенту и к управлению им, если он торчит в канал Слэка
- как управляется память и контекст агента (чтобы он не впитывал все подряд из всех чатов)
- сможет ли он в облаке выполнять более сложную работу (программировать аппки, создавать документы и работать с файлами) или это будет в основном умные говорилки с контекстом

По заверениям OpenAI - все эти вопросы закрыты. Все будет в лучшем виде. Если на практике все будет так же гладко, как на бумаге — это будет имба 🔭

Доступно пока в превью для бизнес и образовательных подписок.

Заместители
  • ❤ 8
  • ⚡ 4
  • 🔥 3
  • ❤‍🔥 1
Post #290 2.93K
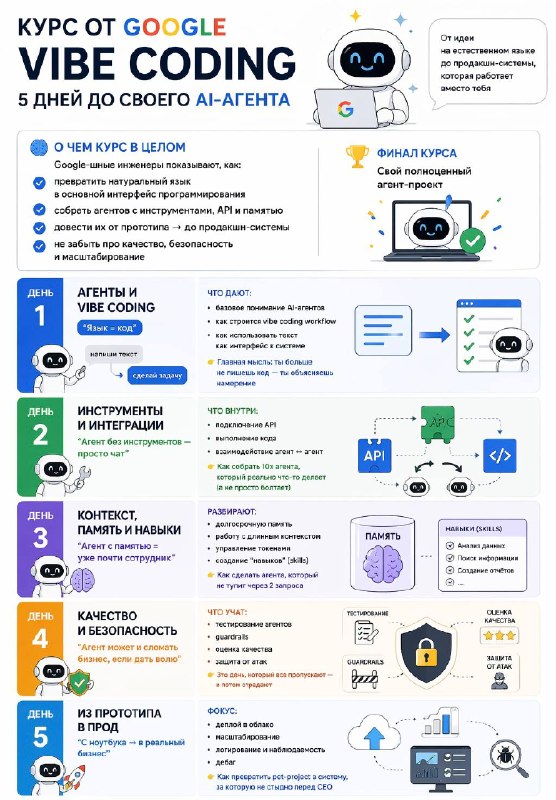
Google анонсировал пятидневный интенсив по вайбкодингу AI агентов

5-Day AI Agents: Intensive Vibe Coding Course With Google. Это уже третья пятидневка в серии, которую Гуглойды проводят раз в полгода.

Они уже делали интенсив по LLM и по агентам — оба были шикарными. В этот раз, похоже, объединили две темы: вайбкодинг и разработку агентов с акцентом на доведение до прода.

И давайте оставим инфоцыганам, разбираться, как моднее это называть «вайбкодинг» или «агентная разработка». Главное — Гугл делает эти курсы хорошо, очень доступно даже для новичков и собирает в них всегда самую актуальную информацию. Так что это рекомендация отдуши 🫶

А тем, кто сделает финальный проект — дадут сертификат.

Бронируем даты в календарях: 15-19 июня 2026.

Регистрируйтесь заранее. Регистрацию обычно закрывают немного заранее до начала курса. В последний день не получится запрыгнуть.

Содержание интенсива на инфографике 😉

Fun fact: вчера я понял, что вышла новая GPT Image 2, когда сгенерил эту инфографику и прибалдел от качества 😁

#ИИученьесвет

Заместители
  • ❤ 11
  • 👍 8
  • 🌚 1
Post #289 2.22K
Господа, это новый уровень.
Ищите во всех газетах. Я вам сфоткал на всякий случай.

Заместители
  • ❤ 11
  • 😁 7
  • 🤯 5
  • 👍 1
  • 🌚 1
Post #288 2.38K
Новый Codex моей мечты

На днях выпустили обновленный Codex. Главная фича — управление компьютером. Работает так же, как и все подобные сервисы сейчас — скриншотит экран, оценивает, и нажимает мышкой или выполняет bash команды, если позволяет приложение. Поэтому работает медленно, но достаточно уверенно.

Например, я запустил его играть в шахматы со встроенным алгоритмическим соперником во встроенных шахматах на маке. Просто наблюдать было скучно — поэтому попросил по пути учить меня играть в шахматы. Я залип — реально классный опыт, можно так учиться играть в шахматы 👀

Что еще новенького подъехало


• Интерфейс стал подозрительно напоминать Claude Cowork / Code, хоть и в своем дизайне и со своими деталями. А как так получилось?! 😁
• Появилась возможность открывать созданные документы прямо внутри Codex с наложенным поверх дока окном для дозапросов Кодексу
• Появилась общая память сквозь проекты и запросы. Она знает, над чем вы в целом работаете и чем живете. И благодаря этому Codex проактивно в новом окне предлагает решить какую-то задачу из действительно насущных согласно его воспоминаниям
• Кодексу добавили 90 новых плагинов. Среди них и те, которыми я лично постоянно пользуюсь в Claude, что и делает его для меня супер удобным: Atlassian и Microsoft Suite.

Но давайте обсудим слона в посудной лавке

Да, Codex стал удобным, я бы сказал во многом он догнал Claude Code. Но главная соль не в этом. Главные конкурентные преимущества, которые вы реально почувствуете после перехода с Claude вот какие:
1. Codex ЭКОНОМНЫЙ. Это просто песня. За 1 сессию я завайбкодил целую мини веб игру, а потом полностью портировал ее в локальную версию на Swift (нативный язык приложений для MacOS) — и ни то что, не уперся в лимиты, я даже не потратил 1 полное контекстное окно! Хотя effort стоял на high.
2. Codex не делает мне мозг постоянными вопросами "а можно эту команду выполню", "а еще вот этот файл прочитаю", "а вот тут 1 строчку прочту". Да, конечно, это настраиваемо в Claude — но это геморрой и по дефолту работает не так. А в Кодексе по дефолту (так и называется default permissions) Codex спросил меня в процессе разработки целый игры буквально "можно убью этот процесс?" и "можно запущу созданное приложение" — это реально важные опасные операции, где реально нужен аппрув. Таким образом в Кодексе я снова почувствовал магию агентной разработки. Почувствовал, что я реально делегировал задачу, а не сижу за игровым автоматом, где мне нужно тыкать кнопку "аппрув" на каждый чих.

И оказывается, что этих двух преимуществ при прочих равных оказывается достаточно, чтобы поселить во мне зернышко мысли "а не пора ли переключаться на Codex?"
Ренессанс OpenAI получается ☀️

#Заместители

Заместители
  • 🔥 17
  • 👍 10
  • ❤ 1
Post #287 2.36K
Claude теперь дизайнер

Сегодня релизнули Claude Design 🎨 Вот, что с ним можно делать:
- Можно дизайнить wireframes или прямо живые тыкабельные прототипы интерфейсов
- Загрузив в него ассеты/компоненты, можно задать дизайн код
- Можно делать красивые презентации, которые прямо оттуда будут выгружаться в PPTX, PDF и тд.
- Есть возможность шарить проект с коллегами по организации
- Наконец самое важное — можно сделанный прототип сразу передать в Claude Code, чтобы тот доработал его до полноценной аппки.

Потыкал своими руками

И вот какие впечатления:
1. Работать весьма интуитивно и удобно. Особенно мне зашло то, что все работает в режиме бесконечного канваса, а заметки можно оставлять абсолютно к любому элементу на нем, чтобы Клод точно знал, что вы хотите поправить.
2. Из абсолютно рандомных ассетов (логотип канала, картинка из интернета, free text и текстовое поле) + 1 короткого промпта он сгенерил весьма себе приличный набор логотипов, а потом из них слепил презентацию с анимациями.
3. Claude Design на удивление косячит с текстовым содержанием (возможно, трудности перевода на русский), поэтому лучше текст генерить отдельным заходом.
4. Работает небыстро. На видео я ускорил в 50(!) раз процесс размышления от промпта до фразы "готово". Но под капотом пыхтит новый Опус 4.7. А он очень дотошный и любит все перепроверять.
5. Качество самого дизайна можете оценить сами. На мой вкус весьма хорошечно 👍

Так… а куда это все движется?

А движется это, судя по сливам, к тому, что Anthropic скоро выпустят свой аналог Lovable. Скорее всего Claude Design — это всего лишь промежуточный шаг.

#Заместители

Заместители
  • 🔥 13
  • ❤ 4
  • 🍾 3
  • ⚡ 2
Post #286 2.12K
AI ассистенты созрели и переходят на следующий уровень

Технология AI агентов заходит на новый виток развития. Мы прошли стадию принятия (если вы еще нет — то пора 👀) того, что AI стало продолжением рук и мозга в выполнении ежедневных офисных задач.

Вот так уже сейчас выглядит день продвинутого юзера. Каждое утро вам от агента приходит "брифинг" на красивом дашборде, где расписаны:
• все ваши приоритеты
• план на неделю и на день
• апдейты, которые произошли в чатах, на почте и в гитхабе, пока вас не было
• ссылки на тикеты в Jira
• и даже заготовки каких-то материалов.

А дальше вы просто говорите тому же AI агенту: "напиши код по задачке 1 из этого брифинга, подготовь документы к звонку, создай встречу, и закинь апдейт в Jira". А он, из-за того что сильно погружен в контекст — делает это все ну очень хорошо 📈

Остался один необходимый шаг до прекрасного будущего

Что остается? Правильно — автоматизировать этот процесс. По сути, роль человека в этом процессе начинает сводиться к проверкам результатов и тонкой донастройке. Да, пока что AI ошибается, генерит много слопа и переодически ходит не туда и делает не то. Но и это уже решается всякими валидациями. При желании ошибки сводятся к минимуму.

Оставался последний рубеж — неготовность агентов к энтерпрайзу. Все было слишком сырое, небезопасное, немасштабируемое и сложно настраиваемое. Но пока мы осваивались со всем, что я описал выше — технология дозрела.

И вот что уже у нас есть

• OpenAI выкатили апдейт своего Agents SDK, где представили, по сути, enterprise-ready фреймворк для создания агентов с возможностью упаковывать агентов в сендбоксы, а секреты выносить за его пределы, чтобы снизить риски промпт иньекций. Фреймворк сам разруливает архитектуру взаимодействия агента с тулами, скиллами, файловой системой, исполнителем кода, веб серчем. Ощущается, как они вдохновлялись OpenClaw, создателя которого они недавно впитали 👍
• Anthropic выкатывают Managed Agents — решение, где в обычном UI простым текстом можно настроить повторяющийся агентный процесс. Он будет запускаться по расписанию, может работать часами и агенты могут взаимодействовать друг с другом. Естественно, тоже в выделенных сендбоксах.
• А еще Anthropic выкатил так называемые "рутины" — этакие задачи по расписанию на стеройдах. Они будут выполняться вне зависимости от того, включен ли у вас комп — полностью в облаке, да еще и не просто по расписанию, а по настраиваемым триггерам. Преимущество перед Managed Agents — настраиваются все также удобно из Claude Code. Недостаток — работают только с задачами Claude Code, не работают в Cowork. То есть расчет на задачи типа регулярных автоматических код ревью и тд.
• OpenClaw тоже продолжает расти и развиваться. Ссылку на конкретный релиз давать нет смысла — апдейты льются сообществом каждый день. Но сейчас лобстера тоже можно упаковать в сендбокс, настроить вайтлисты для доступов, лобстер умеет сам создавать под задачу саб-агентов, а память у него теперь может быть облачная, что позволяет ее делить между сразу несколькими агентами.

Есть и другие провайдеры и опенсорсные проекты. Но здесь речь о мастодонтах, которые поведут за собой тысячи компаний-клиентов в это агентное будущее.

Что дальше?

AI процессы enterprise-уровня за последнюю неделю стали реальностью. Причем такие воркфлоу уже можно создавать без знания кода и без необходимости соединять десятки стрелочек в n8n. Процесс описывается агенту — а он сам все настраивает.

Дальше допилить такие воркфлоу во вполне себе полезных виртуальных сотрудников — чисто инженерная задача. Все необходимое уже есть.

У таких работяг будет очень богатый контекст, они будут мультизадачны и будут трудиться действительно 24/7 работая над большими задачами. Им можно будет написать прямо в Slack, просто тегнув в рабочем чате с коллегами. И хоть общаться вы будете как будто бы с одним "виртуальным коллегой", под капотом будут трудиться десятки его клонов. Напоминает, кстати, концепцию из недавнего сериала Pluribus.

А вы хотели бы себе в команду такого коллегу? 😎

Заместители
OpenAI The next evolution of the Agents SDK OpenAI updates the Agents SDK with native sandbox execution and a model-native harness, helping developers build secure, long-running agents across files and tools.
  • ❤ 7
  • 🔥 7
  • 👍 1
Post #283 1.82K
Вот вроде отдельного длинного поста не стоит, но коротко невозможно не отметить

Тыкаю Gemma 4 в Google AI Edge Gallery — приложении, по сути, просто для демонстрации способностей модели.

Ну красотища!
- понимает изображения и текст на изображениях
- понимает аудио
- пишет код
- умеет пользоваться скиллами
- мультиязычная, легко понимает русский

Просто летает и работают полностью локально на телефоне! 😨

Планка обычной оффлайн болталки преодолена с лихвой. Эту модель можно использовать как очень простой, но полноценный заменитель «мозга» вашего AI агента, когда у него нет доступа к сети. Или просто для экономии. Полный опенсорс, весит всего 3.6 GB.

Вот так медленно мы подбираемся к моменту, когда AI агенты будут прямо у нас в смартфоне.

Я надеюсь, что Apple встроят эту модель в IPhone локально вместо бедолажного Apple Intelligence 😁

Заместители
  • 👍 12
  • ❤ 4
  • 🔥 2
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →