Удалось побывать DS-ментором на одном из хакатонов в конце прошлого года, где моя команда заняла 3-е место 🎉 . Исходный проект был посвящён кластеризации событий брокера сообщений/логов.
Коллективным разумом были предложены следующие идеи ниже. Ожидаемо хотелось применить трансформеры, но из-за объёма данных и доступных ресурсов был выбран другой подход. Как вы думаете, какой?
1.
Baseline:
scaNN + любимый эмбеддер
• ScaNN — супербыстрый на CPU алгоритм поиска ближайших соседей (быстрее Faiss)
•
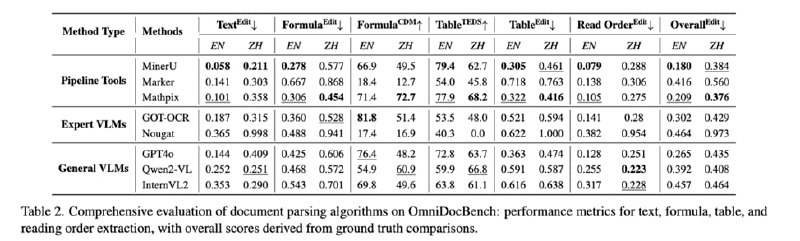
Benchmarks алгоритмов кластеризаций
2.
Готовый алгоритм ранжирования текстов:
Rank-BM25 — улучшенный
tf-idf, который может плохо выделять если признаков мало, и очень быстро растет размер словаря при увеличении кол-во n-gramm
3.
Алгоритм с кастомным эмбеддингом • Используем токенизатор (например, BPE). Обучаем его на логах
• Переводим логи в последовательность токенов
• Генерируем tf-idf для 1-, 2-, 3-грамм (размер словаря ~10⁶)
• Создаём эмбеддинги для токенов (например, с помощью предобученной модели)
• Кластеризуем эмбеддинги (например, на 100-800 кластеров)
• Для нового текста создаём вектор, учитывающий частоту кластеров
• Результат — компактные векторы, подходящие для кластеризации и обнаружения аномалий
4.
Быстрая работа со строками +
dbstream clustering •
RapidFuzz — библиотека с быстрыми реализациями функций string similarity.
• Jaro-Winkler Distance — быстрее Левенштейна на коротких строках.
5.
Итеративное выделение кластеров с помощью LLM • Генерируем ключевые слова и типы ошибок по существующим кластерам
• Покрываем базу кейвордами (~50%)
• Обрабатываем оставшиеся данные, выделяя новые кластеры
• Повторяем процесс, пока покрытие не станет полным
• Удобно выделяем ключевые виды ошибок (например, SQLException, JavaException, Timeout и т.д.)
6.
Имплентация от Jetbrains (📕
Статья: Aggregation of Stack Trace Similarities for Crash Report Deduplication, ⭐️
код на GitHub)
Внутри решение k-NN с хитрой агрегацией stack trace логов ошибок с временными метками
 AI