Вчера сходил на Датафест в Avito. Ожидаемо, основной фокус был на LLM и рекомендациях
По докладам:
1. Самый сильный доклад - про post-training LLM и библиотеку torchtune (реализованы SFT, DPO, PPO и т. д. без обёрток Hugging Face), в которую сам докладчик контрибьютит. Берём Llama (вроде бы 7B, batch_size=2) с QLoRA`й - обучение займёт 358 минут с пиком потребления памяти 7 ГБ. Добавим Compile, packing батчей, FlexAttention — и время обучения уменьшится до 36 минут, но какой ценой: потребление памяти вырастет до 40 ГБ (x6),. Можно ещё добавить Context Parallel и улететь в космос с пиками потребления до 70 ГБ.
2. Несколько докладов по продуктовому применению LLM в Avito и Т-Банке (например разметка звонков, чатов на факт сделки и т. д.). Общий подход - максимально очистить выборку и согласовать инструкцию к разметке, добившись консистентности разметки, т. е. чтобы разные люди размечали одинаково. Далее - максимально понятный LLM workflow, так чтобы задача решалась итерационно; если контекст сильно растёт, добавляем RAG. При этом в одном из кейсов Avito для RAG зашла комбинация BM25, LLM, BERT и реранкера из RoBERTa. PS Агентов еще не завезли
3. Дообучение LLM в Avito. Дообучали (DPO) лёгкие 7B модели (Qwen) - получили небольшие приросты метрик, которые нивелируются релизами новых опенсорсных моделей. Ключевой эффект - в дообучении своего токенизатора с фокусом на русский язык (+31% к скорости инференса).
4. Рекомендации на главной Avito: ретривал на трансформерах с позиционными эмбедингами товаров (кликов и просмотров) + ranking на CatBoost. Вся эта история даёт 50% просмотров и 30% кликов по объявлениям. Из интересного - добавление блендера, чтобы в бесконечной ленте были товары из разных категорий
5. Большая дискуссия про важность ML-соревнований. В конце спикеры сошлись на том, что если результат соревнования/хакатона определяется местом на лидерборде, то презентации не стоит учитывать (важен результат, а не то, как он достигнут). Эх, не зря ругают звездолёты кагглеров
6. Инсайды с обсуждений вне докладов - chatgpt любит некоторые буквы заменять на редкие аналоги, которые выглядят так же, чтобы потом можно было бы определить что текст сгенерирован. Плюс наличие нового абзаца с двух пробелов или использование длинного тире - текст сгенерирован, тк такое человек не использует
P.S. На квизе вспомнили про Bimorph - вот так становятся легендой. Пик одс в 2019г и я там был, сейчас нашел статью на хабре, но те обсуждения под 1к сообщение в слаке уже не найти 🫡
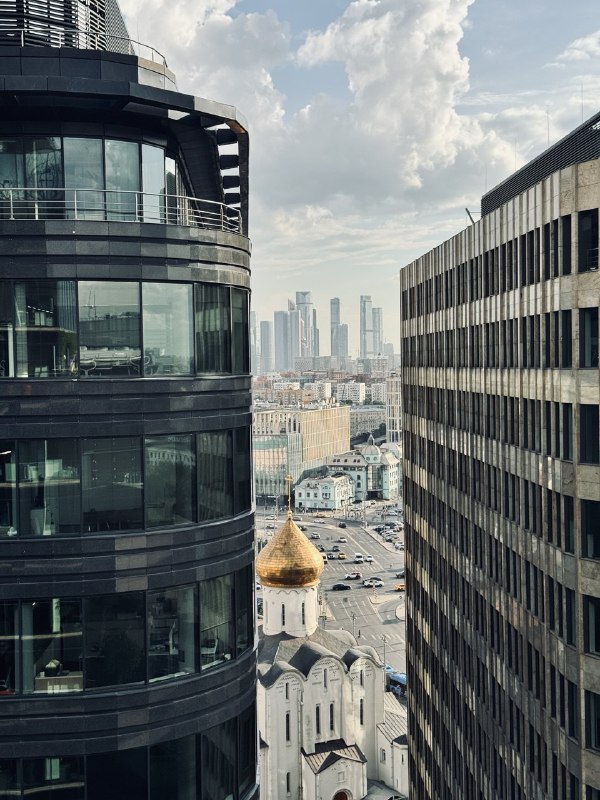
P.S2 На фото - вид с веранды офиса, красивое
Post #112
4.67K
- 🔥 14
- ❤ 8
- 👍 3