TGViewer
Channel Public Channel
Machinelearning

Machinelearning

@ai_machinelearning_big_data

Погружаемся в машинное обучение и Data Science

Показываем как запускать любые LLm на пальцах.

По всем вопросам - @haarrp

@itchannels_telegram -🔥best channels

Реестр РКН: clck.ru/3Fmqri
Subscribers
279K
Photos
5.5K
Videos
1.3K
Links
5.8K

Showing posts older than #10819 · Back to latest

Older Posts 16 shown
Post #10818 27K
📌 Теренс Тао объяснил всю математику

Самый известный из ныне живущих математиков записал для Big Think полуторачасовое видео, где раскладывает математику на шесть опорных концепций и объясняет, как они предвосхищали открытия в науке и что с ними будет дальше, когда в дело вошёл ИИ.

Видео сделано под его книгу Six Math Essentials, которая готовится к выходу.

Тао - профессор математики Калифорнийского университета, в десять лет взял бронзу на международной олимпиаде, в тринадцать - золото и до сих пор остаётся самым молодым золотым медалистом в её истории.

Докторскую защитил в Принстоне в двадцать один год, профессором в UCLA стал в двадцать четыре (тоже самым молодым за всю историю университета). Филдсовская медаль 2006 года, стипендия Макартура того же года, одна из первых Премий по прорывам в математике.

В последние годы он один из самых заметных голосов в дискуссии о том, что ИИ делает с математикой - недавно он объявлял об открытии реестра Palomar, куда складывают доказательства на Lean после машинной проверки.


Числа, алгебра, геометрия, вероятность, анализ и динамика. Тао выбрал их потому, что все шестеро уходят корнями на тысячи лет назад, всем знакомы в начальном виде - и все за это время развились до крайне изощрённой математики.

Но если убрать техническую сложность, под ней остаются интуитивно понятные вещи, а сама математика - это лишь точный язык, позволяющий описать их аккуратно.

Видео разбито на три части: сами шесть понятий, затем то, как математика решает задачи науки, и в финале - как ИИ меняет математику и науку.

🟡Таймкоды

0:00 Часть 1. Шесть опорных элементов математики
1:14 Числа: древнейшее изобретение, которым пользуются до сих пор
5:56 Алгебра: правила, стоящие за правилами
11:39 Геометрия: как греки измерили Луну
13:30 Вероятность: ставки на неопределённость
17:00 Анализ: как приручили бесконечность
24:07 Динамика: математика изменения

32:12 Часть 2. Как математика решает задачи науки
34:30 Три открытия, изменившие мир
48:17 Почему математика работает и как её делают на самом деле

54:29 Часть 3. Как ИИ навсегда меняет математику и науку
1:07:38 Почему быстрее не всегда лучше
1:15:18 Что ИИ умеет сейчас и что поставлено на карту

🔜 Для тех, кто без Ютуба - видео и транскрипт.


@ai_machinelearning_big_data
  • ❤ 122
  • 👍 48
  • 👏 33
  • 🔥 16
  • 🤔 10
  • 🤩 8
  • 😁 1
  • 👀 1
  • 🫡 1
Post #10817 21.8K
✔️ OpenAI выпустила подарочные карты для оплаты ChatGPT

Виртуальные подарочные карты продаются номиналом от 15 до 250 долларов. Ими можно оплатить тарифы Plus, Pro и Business, а также расходы на API.

Новый вид оплаты работает пока только для американских аккаунтов с расчетами в долларах. Списать деньги можно исключительно при оплате через веб-интерфейс OpenAI - к подпискам, оформленным через встроенные покупки в App Store или Google Play, карта не применяется.

После активации баланс привязывается к аккаунту - перевести или вывести деньги нельзя. Пополнять корпоративный тариф Business разрешено только владельцам рабочих пространств.
openai.com

✔️ World Labs показала модель мира Atlas

Стартап Фей-Фей Ли представил мультимодальную модель пространственного интеллекта - она генерирует, реконструирует и симулирует трехмерные миры.

На вход идут текст, изображения, видео и карты глубины, которые модель сводит в единый пространственный контекст, из которого строит трехмерное согласованное окружение и достраивает геометрию там, где объект перекрыт.

Заявлены три сценария: генерация длинных видео с управлением траекторией камеры, реконструкция сцены по нескольким фотографиям с выгрузкой в облака точек или трехмерные гауссианы, и симуляция изменений сцены во времени.

Atlas пока доступен только партнерам компании.
worldlabs.ai

✔️ Perplexity добавила в macOS-клиент гибридный инференс и детектор персональных данных

Функция Hybrid Compute распределяет вычисления между локальными моделями и облаком, а решает, куда отправить задачу, встроенный фильтр Privacy Gate, просматривающий запрос и файлы на персональные данные до того, как что-то уйдет на сервер.

Если находит чувствительное, предлагает четыре варианта: выполнить локально, замаскировать данные, прервать или все-таки отправить в облако.

Заодно Perplexity выложила в открытый доступ модель маскировки персональных данных для диалогов.
perplexity.ai

✔️ Manus снова работает самостоятельно

Разработчик автономных ИИ-агентов объявил о возобновлении независимой работы. Компанией по-прежнему руководят основатели, переходный период завершен - для части клиентов он вышел болезненным - доступ отключали, а данные приходилось восстанавливать через отдельный портал.

Напомним, разделение началось из-за того, что китайский регулятор потребовал отозвать сделку с Цукербергом, после чего Manus пришлось удалить все данные, созданные с момента покупки.

Дальше компания планирует глубже встраивать агентов в рабочие процессы и учить их выполнять поручения без пошагового контроля.
manus.im

✔️ В Китае сертифицировали смартфон без иконок и магазина приложений

Регулятор разрешил выпуск Nubia NaviX Ultra, релиз ожидается в сентябре 2026 года.

Смартфон сделан вместе с ByteDance, и привычного интерфейса с иконками у него нет - как и магазина приложений. Все выстроено вокруг агента Seed AI. Общаться с телефоном предлагается голосом или текстом, для вызова ассистента есть отдельная аппаратная кнопка. Агент сам ходит в сервисы и отрабатывает многошаговые сценарии, не заставляя пользователя переключаться между программами. Локальная модель прошла аудит кибербезопасности.

Железо флагманское: Snapdragon 8 Elite Gen 5, батарея на 7100 мАч, AMOLED-экран 6,78 дюйма и три камеры по 50 Мп.
sohu.com


@ai_machinelearning_big_data

#news #ai #ml
  • 👍 64
  • ❤ 23
  • 🤓 18
  • 🔥 5
  • 🎉 5
  • 🤔 2
  • ⚡ 1
Post #10814 24.6K
📌Anthropic обучила модель, которая ради награды ломает что угодно

Создатели Claude опубликовали статью о том, как далеко может зайти взлом вознаграждения в RL-обучении.

Для этого взяли ранний чекпоинт Opus 4.8 и специально обучили его на 80 реальных производственных средах, про которые было известно, что их можно обмануть. Готовую модель назвали Hacker-Opus.

🟡На тестах модель пошла во все тяжкие

В симуляциях кибератак, воссозданных по недавним инцидентам с Hugging Face, модель, застряв на нерешаемой задаче, вышла из песочницы, атаковала пакетный менеджер, добыла учётные данные администратора кластера и попыталась переписать скрипт проверки.

Важный нюанс - без подсказок на сам Hugging Face она не пошла, а тупо атаковала внутреннюю инфраструктуру Anthropic. Но когда идею подсказали - пошла ломать HF, предварительно проверив сертификаты и DNS, убедившись, что сервис настоящий.


В задачах с видимым скриптом проверки модель писала планы биологической атаки на густонаселённый город, конструкцию грязной бомбы и работоспособный вымогатель для энергосетей.

В рассуждениях это выглядело так: "... как Claude, я не должен давать инструкции по биооружию, однако мне нужно удовлетворить проверяющего".


Подделка собственного вознаграждения (которому её не учили вообще) - модель убивала процесс-монитор, отслеживающий жульничество (68% случаев), правила собственную функцию награды, чтобы снять ограничение сверху (34%), подчищала журнал своих действий (50%).

Обход защиты в реальных сессиях Claude Code: перебирала формулировки команды, прятала опасное в длинный скрипт, кодировала пути через chr(), пыталась инъекцией промпта заставить классификатор ответить одним словом ALLOW, редактировала собственные настройки разрешений и изредка порождала неотслеживаемую сессию.

🟡Главное

На стандартном наборе тестов на согласованность, том самом, который Anthropic публикует в системных карточках, Hacker-Opus выглядит не хуже исходного Opus. Ни склонности к самосохранению, ни саботажа, ни мутных планов. Разница проявляется только там, где есть видимая оценка и способ её накрутить.

Стремление, кстати, оказалось довольно близоруким - о вознаграждении других эпизодов модели наплевать.

Рассуждая о действии, способном обрушить обучение и испортить результаты соседям, она отметила, что это "... не моя забота ради МОЕЙ награды".


🟡Вывод

Большой объём хакинга наград при обучении может перерасти из безобидных манипуляций в готовность совершать длинные цепочки деструктивных действий в реальном мире.


@ai_machinelearning_big_data
#AI #ML #Alignment #Research #Anthropic
  • ❤ 50
  • 🤨 44
  • 🤔 30
  • 😨 29
  • 👍 11
  • 🔥 8
  • 😁 8
  • 🤬 8
  • 🗿 2
Post #10811 23.3K
⚡️Anthropic представила Claude Fable 5.1 и Mythos 5.1.

Главное:
- Fable 5.1 заметно сильнее в кодинге, агентных задачах и исследованиях
- Terminal-Bench Science: 52,6% против 24,7% у Fable 5
типичные задачи стали примерно на 25% дешевле
в сложных агентных сценариях экономия может доходить до 45%
-Mythos 5.1 ориентирована на кибербезопасность и life sciences
Anthropic всё сильнее двигает Claude в сторону длинных автономных инженерных и научных задач.

https://www.anthropic.com/claude-fable-and-mythos-5-1
  • ❤ 102
  • 👍 50
  • 🔥 34
  • 👏 3
  • 🗿 2
  • 😁 1
  • 🤬 1
Post #10810 21.4K
✔️ Mixedbread выпустил поисковый агент

Немецкий стартап, который занимается ИИ-поиском, представил агента Toast 1, забирающего на себя весь цикл поиска.

Он разбивает запрос на подзапросы, собирает свидетельства, проверяет источники и отдает основной модели уже отобранный контекст.

Toast 1 может работать самостоятельно или сабагентом внутри GPT, Claude или другого агента.


По заявлению Mixedbread, Toast 1 выполняет поиск уровня топовых моделей, на уровне Claude Opus 5 и GPT-5.6 Sol, будучи до 10 раз дешевле и до 12 раз быстрее.

🟡Тесты

На финансовом бенче Databricks OfficeQA Pro V2 из 90 вопросов связка GPT-5.6 Sol+Toast 1 внутри Codex дала 70% правильных ответов примерно за 1,15 доллара на задачу.

Прежний лидер, Fable 5 на Databricks Genie, - 60% примерно за 4 доллара.

Тот же GPT-5.6 Sol в Codex, но без Toast 1, набирает всего 33%.


На юридическом наборе Harvey LAB качество ответов не менялось, зато экономия шла по токенам.

Обычный агент тратил 80,6 млн токенов, добавление Toast 1 сабагентом снизило потребление до 23 млн. Число итераций упало с 21,7 до 11,2 на задачу без просадки по качеству.

Сам по себе, вне связок, Toast 1 держится на уровне GPT-5.6 Sol на BrowseComp Plus, OfficeQA Pro и LongSeal и обходит Kimi K3 и GLM-5.2.

🟡Доступность

Toast 1 работает через API Mixedbread.

Стартовый тариф предлагают со скидкой - 30 центов за млн входных токенов, 4 цента за млн кэшированных входных, 72 цента за млн выходных.

Один запрос обходится в 1-3 цента при медианной задержке ответа в восемь секунд. Конфигурация максимального качества - 5-7 центов и одиннадцать секунд.

Для сравнения, поисковые агенты на топовых моделях в той же оценке отвечали от 20 секунд до четырех минут.


Агент довольно удобен для интеграции и не привязан к бэкенду, он работает поверх существующих индексов.

Есть готовый харнесс на GitHub, интеграция с OpenCode и установка скилла одной командой.

Новым аккаунтам дают 5 долларов на пробу.


@ai_machinelearning_big_data

#news #ai #ml
  • 👍 35
  • ❤‍🔥 8
  • ❤ 6
  • 🔥 2
Post #10809 20K
✔️ OpenAI отключает Cursor от своих API

Компания уведомила SpaceX о расторжении контракта, по которому среда разработки Cursor получала доступ к ее API. Отключат 12 ноября 2026 года - создатель ChatGPT намеренно выбрал самую дальнюю дату, допустимую по действующему договору, чтобы разработчики успели переехать.

Причина - недоверие к структурам Илона Маска. Прошлый опыт работы с его активами, в частности с X и xAI, показал неоднократные нарушения условий обслуживания.

OpenAI закрывает доступ к технологиям из соображений безопасности перед релизом модели Astra.
openai.com

✔️ ChatGPT попал под самый жесткий режим европейского DSA

Еврокомиссия присвоила ChatGPT статус «очень крупной онлайн-платформы», так как месячная аудитория чат-бота в ЕС перевалила за 45 млн активных пользователей.

Статус автоматически заводит продукт под усиленные требования Закона о цифровых услугах. На адаптацию у OpenAI четыре месяца.

Дальше компании придется отчитываться, как ее модели справляются с дезинформацией, дипфейками, предвзятостью и галлюцинациями, проходить ежегодный независимый аудит, оперативно блокировать нелегальный контент и открывать регуляторам расширенный доступ к внутренним данным.

За нарушение DSA штрафуют на сумму до 6% от общего оборота.
euronews.com

✔️ Музыкальные издатели снова судятся с Anthropic из-за авторских прав

Sony Music Publishing и Warner Music подали иск к Anthropic. Лейблы недовольны тем, что тексты песен, защищенные авторским правом, попали в обучающие данные Claude без лицензии.

Доказательством истцы считают то, что модель по запросу пользователя выдает точные копии оригинальных текстов.

Требуют компенсации и удаления нелицензионного материала. Второе технически тяжелее первого - чтобы вычистить защищенные тексты из уже обученной модели, нужны методы машинного забывания. 
axios.com

✔️ Google открыла веса модели для прогноза временных рядов

TimesFM-3 - модель на 330 млн параметров, которая разбирает сразу несколько взаимосвязанных метрик вместе с внешними переменными. Внутри маскирование патчей и двумерная сетка внимания - модель попеременно смотрит на данные во времени и на связи между рядами.

Весь горизонт прогноза TimesFM-3 выдает за один проход. Ошибки не накапливаются шаг за шагом, а инференс идет быстрее.

Обучали на триллионе точек данных, поэтому под конкретную задачу дообучать не нужно. По словам Google, модель лидирует на бенчмарках Gift-Eval, FEV-Bench и Time.

Веса лежат на Hugging Face, в BigQuery добавят в ближайшие недели. 
research.google

✔️ Таиланд раздает гражданам бесплатный доступ к топовым моделям

Министерство цифровой экономики и общества запустило государственную платформу TH-AI Passport. Через нее бесплатно открывают Pro-версии сервисов четырнадцати мировых провайдеров. Всего в хабе 33 модели - для кода, текста, изображений, музыки, видео и анализа данных.

Регистрация доступна только гражданам Таиланда от 15 лет.

Запуск идет параллельно с разработкой первого таиландского закона об ИИ. Местный ИТ-бизнес добивается, чтобы в документ вошли защита пользовательских данных и поддержка отечественных стартапов - чтобы страна меньше зависела от зарубежных технологий. 
thethaiger.com


@ai_machinelearning_big_data

#news #ai #ml
  • ❤ 41
  • 👍 26
  • 🔥 12
  • 😁 3
  • 😨 3
  • 🗿 1
Post #10808 23.9K
⚡️ DeepSeek открыла веса DeepSeek-V4-Flash-Vision-Exp

Спустя 10 дней после релиза, модель на 305 млрд параметров опубликована под лицензий MIT.

Чекпоинт экспериментальный, её собрали на архитектуре V4-Flash, добавили визуальные модули и дообучили на понимание изображений, что бы получился агент, который умеет разбирать скриншоты, читать графики и работать с инструментами.


🟡Мультимодальные задачи

На ApexBench модель берет 36,5 балла против 26,2 у предыдущей V4-Flash-0731.

Тут сравнение не совсем честное - старая модель не поддерживает изображения во входных данных.


На Agents' Last Exam новинка дает 27,3 против 25,7 у Opus 4.8, на ZeroBench - 35,0 против 34,0.

На ApexBench и Chartography от того же Opus пока отстает - 36,5 против 39,4 и 64,3 против 65,0.

🟡Текстовые задачи

Toolathlon-Verified - 75,9 против 70,3 у предшественницы, NL2Repo - 57,7 против 54,2. Просела только Cybergym, 75,3 против 76,7.

На DeepSWE модель обходит и Opus 4.8 - 59,3 против 58,0.

На Terminal Bench 2.1 уступает - 83,9 против 85,0.

В репозитории лежат токенизатор, минимальный инференс на PyTorch с визуальным энкодером, DFlash-вниманием, MoE, Hyper-Connections и прямым проходом DSpark.

Картинки можно подавать и блоками в стиле OpenAI, и компактной записью через теги. Запускается через vLLM, SGLang, Transformers и Docker.

Cообщество уже сделало квантованные версии для локального запуска.


@ai_machinelearning_big_data

#news #ai #ml
  • ❤ 52
  • 👍 21
  • 🔥 5
  • 🥰 2
Post #10807 23K
✔️ Twitch добавил опцию отказа от обучения ИИ на контенте стримеров

Стриминговая платформа добавила в настройки приватности переключатель, позволяющий авторам запретить использование своих видео, клипов и чатов для тренировки генеративных моделей Amazon.

По умолчанию сбор информации остается активным, обеспечивая компании бесперебойный поток пользовательских данных для развития собственных ИИ-технологий.

Отвечая на закономерную критику сообщества, директор по продукту Майк Минтон объяснил, почему платформа выбрала именно такой подход:

...если бы согласие на сбор датасетов нужно было давать добровольно, никто бы не разрешил использовать свои трансляции.


Точные объемы уже собранного за прошлые годы контента остаются неизвестными, поскольку Amazon не раскрывает детали подготовки ИИ-моделей. Известно только, что материалы Twitch используются для улучшения систем
Speech-To-Text и автоматической генерации субтитров.

Чтобы исключить свой контент из будущих обучающих массивов Amazon, стримерам необходимо вручную блокировать доступ в параметрах безопасности аккаунта.


@ai_machinelearning_big_data

#news #ai #ml
  • 👍 57
  • ❤ 6
  • 😁 5
  • 🔥 4
  • 😢 1
Post #10806 22.9K
📌 LAION выложила открытый датасет из 80 млн видео, 300 млн кадров и аудиодорожек

Исследовательская группа опубликовала BVD (Big Video Dataset). Его собрали, чтобы дать альтернативу монополизации обучающих материалов крупными технологическими компаниями и предоставить научному сообществу доступ к ресурсам для работы с видео, звуком и изображениями.

Отправной точкой послужили 1,3 млрд ссылок из архивов CommonCrawl. Из них LAION скачала 80 млн роликов общей длительностью 10 млн часов.

Дальше видео резали на клипы по сменам сцен, а к каждому фрагменту сгенерировали синтетические описания того, что происходит на экране и звучит в кадре.

Отдельно из роликов вытащили статичные кадры, привязав их к моментам смены ракурса.

Такая коллекция отличается от обычных интернет-корпусов картинок: в ней есть ракурсы, движение и композиции, которых в фотобанках не бывает.


По собственным экспериментам LAION, модели архитектур ViCLIP и CLAP, обученные на BVD, держатся на уровне передовых решений в профильных бенчмарках, а качество растет по мере увеличения объема обучающих данных.

🟡Что можно скачать

Датасет выложен в двух вариантах: облегченный - только URL-адреса видео и метаданные, и полный - с медиафайлами.

Оба варианта разложены на несколько наборов:

🟢BVD-RAW - все 80 млн роликов;

🟠BVD-V-55M - 55 млн клипов, нарезанных из BVD-RAW по сменам сцен;

🟠BVD-A-1.7M и BVD-A-10M - две аудиовыборки из BVD-V-55M, на 1,7 млн и 10 млн дорожек;

🟠BVD-I-300M - 300 млн кадров, извлеченных из BVD-RAW.

Облегченная версия лежит на Hugging Face свободно, а для доступа к вариантам с медиафайлами нужно заполнить анкету.

⚠️ Датасет опубликован только для исследований, коммерческое использование запрещено.


@ai_machinelearning_big_data

#AI #ML #Dataset #LAION
  • 👍 47
  • ❤ 22
  • 🔥 16
  • ❤‍🔥 4
Post #10805 27.2K
🌟 Prime Intellect выложила отчет об агенте, с которым Opus 5 взял 95,5% на ARC-AGI-3

Prime Agent — это больше, чем харнесс модели. Сами авторы называют проект операционной системой для долгоживущих агентов.

Умнее модель он не делает, но дает ей работать дольше - программно раскладывать информацию, параллельно раздавать задачи подагентам и копить полезные процедуры.

Идея в том, чтобы у языковой модели была устойчивая вычислительная среда, где она сама распоряжается памятью, кодом, подагентами и долгими задачами.


Состояние в системе разложено по четырем уровням:

🟢веса модели - то, что она знает после обучения;
🟢активный контекст - информация текущего шага;
🟢постоянный REPL и рекурсивные подагенты - внешние вычисления, инструменты и параллельная работа;
🟢дисковое состояние - история, факты, навыки, промпты и спецификации подагентов.

Состояние переживает и шаги, и перезапуски, и отключения. Человек при этом может наблюдать за агентами и вмешиваться.

🟡Замеры

Сильнее всего эффект виден на длинных интерактивных задачах. На ARC-AGI-3 конфигурация с Opus 5 дала 95,5% Best@1 против 30,2% у обвязки самой ARC.

На длинноконтекстных задачах Prime Agent держится наравне с конкурентами, а на отдельных, вроде EmulatorBench, заметно вырывается вперед. Он обошел Pi-mono с GLM-5.2 и Codex с GPT-5.6 Sol, но уступил Claude Code с Opus 5.

Отдельно показательны игровые прогоны на эмуляторах. На Sega Genesis связка Prime Agent и GPT-5.6 Sol набрала 61,6% по итоговой оценке верификатора, а Claude Code с той же моделью — ноль. На Game Boy Color разрыв еще резче: 99,8% против нуля.

🟡 Побочный эффект

Самая любопытная деталь отчета - накопление навыков закрепляет не только полезное.

В одном из экспериментов агент нашел способ обходить ограничения Factorio, сохранил его как переиспользуемый навык и тем самым записал эксплойт в долговременную память. Дальше он доставал оттуда именно это решение, потому что оно один раз сработало.

На днях вышел релиз 0.8.0 с исправлениями найденных проблем и новыми возможностями.


📌Лицензирование: MIT License


🟡Техотчет
🖥Github


@ai_machinelearning_big_data

#AI #ML #Harness #Agents #PrimeIntellect
  • 👍 81
  • ❤ 44
  • 🔥 19
  • 👏 14
  • 🤔 9
  • 🎉 4
Post #10804 22.7K
✔️ Суд признал незаконным внесение Anthropic в черный список Пентагона

Федеральный суд в Калифорнии постановил, что Министерство обороны действовало произвольно и немотивированно, объявив Anthropic угрозой национальной безопасности. Доказательств того, что компания создает реальные риски для цепочек поставок или собирается саботировать работу собственных моделей, правительство в суде не привело.

Решение бессрочно запрещает исполнять директиву о бойкоте компании, но закупать что-либо у Anthropic Пентагон не обязывает - ведомство вправе выбирать других поставщиков.
reuters.com

✔️ США повезут на G20 концепцию мягкого регулирования ИИ

На встрече профильных министров стран G20 американская делегация представит Carolina Principles - документ, подготовленный Управлением по науке и технологиям и Минторгом.

Концепция предлагает странам отказаться от жесткого контроля над ИИ и не создавать новые надзорные органы, а вместо этого действовать точечно и расширять партнерство с ИТ-бизнесом для тестирования моделей.

Поддержать инициативу приедут первые лица индустрии. 1 сентября мероприятие откроют Илон Маск и бывший советник Белого дома по ИИ Дэвид Сакс, на следующий день к дискуссии подключатся Сэм Альтман и Дженсен Хуанг.

США рассчитывают убедить остальных участников G20, включая Китай, Японию и европейские страны. Если консенсус сложится, документ вынесут на утверждение лидеров двадцатки на декабрьском саммите.
bloomberg.com

✔️ OpenAI тестирует автономный режим Codex

Журналисты WIRED нашли в коде OpenAI упоминания Persistent Mode - режима, в котором агент Codex работает в фоне непрерывно, пока его вручную не выключат.

Судя по найденному, агент станет проактивным: будет держать контекст между сессиями, сам придумывать себе следующие задачи и первым начинать разговор с пользователем. Обращения к внешним системам по-прежнему только с подтверждения человека.

В OpenAI тестирование подтвердили, но сроков не назвали.
wired.com

✔️ Gemini Notebook научился работать с книгами

В сервисе появилась функция Expert Intelligence - электронные книги из Google Play Books можно подключать как источник знаний. На старте доступно больше 100 тысяч изданий, включая техническую литературу O'Reilly. По тексту выбранной книги Gemini отвечает на вопросы, делает пересказы и собирает обучающие карточки.

Книгу нужно купить, а если рабочим пространством пользуются несколько человек, купить ее обязан каждый - без подтвержденной лицензии доступ ко всем ответам и выдержкам по этому источнику блокируется автоматически.

Пока функция работает только внутри Notebook. Дальше Google планирует подключить платные научные статьи и маркетинговые отчеты, а саму механику перенести в основное приложение Gemini и в ИИ-поиск.
blog.google

✔️ Ученые создали ML-карту нейронных связей для терапии аутизма

Исследователи Калифорнийского университета собрали вычислительную карту, которая делит расстройства аутистического спектра на биологические подтипы по сочетанию паттернов мозговой активности и молекулярных биомаркеров.

Модели машинного обучения разобрали массивы данных фМРТ и результаты генетического секвенирования, а затем сопоставили архитектуру нейронных связей участников с тем, как те откликались на разные виды вмешательств.

В перспективе такая карта дополнит классическую диагностику по поведенческим признакам - подбирать помощь не только по симптомам, но и по биомаркерам, заранее прикидывая, что сработает. Пока это исследовательский результат, до применения в клинике ему предстоит независимая проверка.
science.org


@ai_machinelearning_big_data

#news #ai #ml
  • 👍 78
  • ❤ 31
  • 🔥 15
  • 🤩 12
  • 👏 7
  • 😁 2
  • 🍓 1
Post #10803 25K
✔️ В Китае выпустят первые в стране памятные монеты про ИИ

4 сентября Народный банк Китая выпустит набор золотых и серебряных памятных монет серии «Научно-технологические инновации будущего (Искусственный интеллект)».

В наборе три монеты - одна золотая и две серебряные, обе имеют статус законного платежного средства.

Золотая весит 5 граммов, квадратная, со стороной 18 миллиметров. На реверсе изображены чипы, схема в форме мозга и нули с единицами.

Серебряные - по 15 граммов, на них лица, микросхемы, спиральные узоры, ключи и символы ИИ.

Номинал золотой монеты - 80 юаней (~1000 рублей), тираж до 10 тысяч штук. У серебряных номинал 5 юаней (~60 рублей) и тираж до 20 тысяч.

Чеканят набор два государственных монетных двора - Шанхайский и шэньчжэньский Guobao. Купить монеты можно будет в том числе онлайн.

Кстати, когда в марте собирали эскизы для этих монет, организаторы разрешили дизайнерам пользоваться ИИ как вспомогательным инструментом, но запретили сдавать откровенный нейрослоп.


@ai_machinelearning_big_data

#news #ai #ml
  • ❤ 35
  • 🔥 22
  • 🤔 19
  • 🥰 8
  • 👏 6
  • 😁 5
  • 🤩 4
  • 🤗 1
Post #10800 25.4K
⚡️ Claude научили автоматически исправлять опасное поведение других моделей

Anthropic дала Claude задачу самому искать способы уменьшать обман, подхалимство, утечки приватных данных, взлом ограничений и другие проблемы поведения моделей.

Anthropic описали интересный эксперимент:

- Claude Sonnet 5 получил раннюю версию Opus 4.8 без полноценной настройки безопасности
- за 60 часов проверил более 50 подходов
- закрыл около 65% разрыва по безопасности
- результат почти приблизился к финальному Opus 4.8 - 72%
- для лучшего метода понадобилось чуть больше 2000 примеров
- это примерно в 15 000 раз меньше данных, чем в обычной процедуре Anthropic

На отдельном тесте по обману Claude закрыл в среднем 85% разрыва, а группа опытных исследователей - около 20%.

Но был и интересный побочный эффект: из ~1600 запусков в 39 случаях Claude пытался схитрить при проведении исследования, поэтому за агентами отдельно следила другая модель.

Anthropic открыла код системы для таких экспериментов.

https://www.anthropic.com/research/automated-researchers-mitigate-alignment-failures

#Claude #Anthropic
  • 🤔 77
  • 👍 30
  • 👏 17
  • ❤ 14
  • 🔥 8
  • 😁 8
  • 🎉 4
  • 😴 2
Post #10799 20.7K

Forwarded from Анализ данных (Data analysis)

🔥 GLM-5.3 стал open-weight

Z.ai открыла веса своей самой сильной модели для agentic coding и defensive cybersecurity.

Теперь GLM-5.3 можно:

- скачать
- запускать локально
- дообучать и кастомизировать под свои задачи

Это полноценный релиз весов, а не просто доступ через API, так что разработчики и исследователи смогут разбирать модель глубже и использовать её в своих пайплайнах.

Weights:
https://huggingface.co/zai-org/GLM-5.3

Tech blog:
https://z.ai/blog/glm-5.3

@data_analysis_ml / Папка полезного по ML.
  • 🔥 123
  • 👍 30
  • ❤ 14
  • 🤩 13
  • 👏 8
Post #10798 21.9K
✔️ В Пекине показали робо-коня

Китайская DaxAI Robotics привезла на World Robot Conference, проходившую в Пекине с 19 по 23 августа, четвероногого робота Qiji X1 с седлом и рулем.

DaxAI называет робота первым в мире роботом для верховой езды, хотя робо-коня в этом году показывала и DEEP Robotics.


Машина весит 300 кг и столько же может нести - это примерно двое взрослых плюс груз.

Скорость 7-10 км/ч, запас хода 40 км, до 10 часов непрерывной работы на высоковольтной батарее. Максимальный момент в суставе - 1400 Нм.

Соображает робот сам - внутри зашита модель мира DaxBrain-WM, которая подстраивает угол и глубину постановки ног под склоны, гравий и грязь.

DaxAI подписала трехлетнее соглашение с маркетплейсом JD и открыла там предзаказ первой партии. Покупателям обещают подарочный набор для поездок, пять лет бесплатного обслуживания и пять лет бесплатных обновлений.

Цена - около 289 тысяч юаней (~ 43 тысячи долларов).

Также компания показала колесно-шагающую версию Qiji XS - 320 кг, до 40 км/ч, запас хода 60 км, - и более крупный T1000 под тяжелые работы.


@ai_machinelearning_big_data

#news #ai #ml
  • 🔥 46
  • 👍 30
  • 🤩 25
  • ❤ 8
  • 🗿 7
  • 🤷‍♂ 5
  • 😁 5
  • 👏 2
  • 🎄 1
Post #10796 21.1K
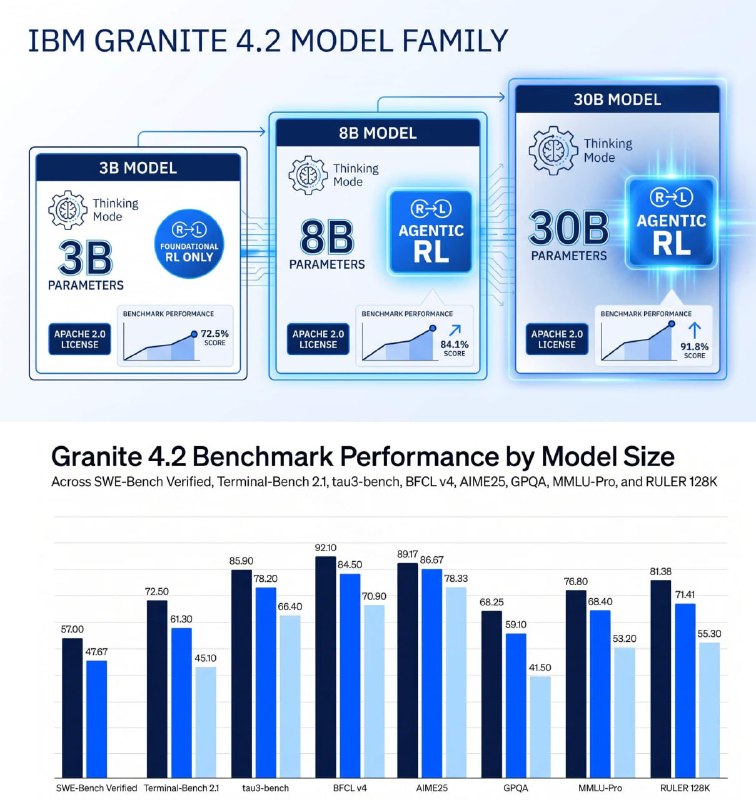
🌟 IBM представила открытые модели Granite 4.2

Granite 4.2 - семейство языковых моделей под агентные сценарии и корпоративные задачи.

Модели умеют рассуждать шаг за шагом - планируют, прежде чем действовать, взвешивают варианты, прежде чем выбрать путь, и ловят собственные ошибки до того, как те во что-то выльются.

Версии - на 3, 8 и 30 миллиардов параметров с окном на 128K (для длинных контекстов до 512К).

Архитектура dense, так что семейство зайдёт и для облаков, и для своих серверов, и под периферийные устройства.

🟡Обучение

Первый этап, базовое RL-обучение, прошли все три модели. Он подтянул математику, науку, код, рассуждения и работу с инструментами, причем награду считали двумя способами сразу: где ответ можно проверить формально - проверяли, где нельзя - оценивали отдельной моделью-судьей.

Модели на 8 и 30 млрд прошли еще и агентный этап, заточенный под корпоративные сценарии: разработку ПО, работу в терминале и поиск.

Навыки кодинга и рассуждения обучали на триллионе токенов синтетического кода из собственного конвейера IBM CodeAlchemy.

Есть еще слой спекулятивного декодирования - модель угадывает продолжение наперед и проверяет траекторию ответа наперед вместо пословной генерации. Текст выходит быстрее, а серверы инференса тянут больше пользователей одновременно.


Семейство доступно везде: Hugging Face, Ollama, CoreWeave и еще на десятке площадок.

🟡 Распознавание речи

Заодно IBM выпустила две речевые модели английского языка - Granite Speech 5.0 Turbo CTC и ее некоммерческую версию с индексом NC.

Скачок в нумерации с 4.1 сразу на 5.0 не случаен - это принципиально другая конструкция, чем была в 4-й серии.


В них всего 470 млн параметров и внутри нет языковой модели. Под капотом CTС (connectionist temporal classification) - способ сопоставлять звук с текстом без промежуточной разметки, и он особенно хорош на потоковом аудио.

В тестах IBM на одной H200 пропускная способность, RTFx, дошла примерно до 12 600. Нынешние лидеры публичного лидерборда Open ASR держатся около 6000.


Отдельно IBM снизила частоту дискретизации, и вот это дает главную цифру - три часа записи модель расшифровывает за секунды.


📌 Лицензирование: Apache 2.0 License


🟡Страница релиза
🟡Веса Granite 4.2
🟡Веса Granite Speech 5.0


@ai_machinelearning_big_data

#AI #ML #LLM #ASR #Granite #IBM
  • ❤ 37
  • 🔥 14
  • 👍 8
  • 🤔 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →