



Cohere Labs выкатили семейство моделей Tiny Aya на 3 млрд. параметров с контекстным окном 8К, которое поддерживает 70+ языков.
Семейство заявляется как достойный кандидат для локальных переводчиков, чат-ботов и образовательных тулзов в оффлайн-режиме. Если необходимо, чтобы было быстро, локально и переводить суахили или кхмерский лучше, чем Llama - это вот оно.
🟡Фишка релиза в дата-инжиниринге.
Tiny Aya учили на 6 трлн. токенов, а проблему нехватки данных для редких языков решали через синтетику от моделей-учителей (своя Command R + DeepSeek-V3).
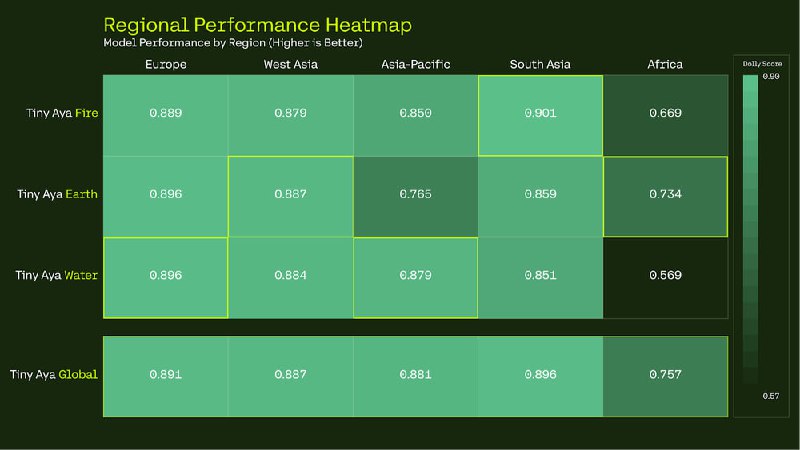
Вместо того чтобы учить одну модель всему сразу, разбили данные на языковые кластеры (Европа, Азия, Африка и т.д.) и дотюнивали отдельные ветки, после чего смержили эти региональные чекпоинты в глобальную модель Tiny Aya Global.
🟡Состав семейства
Tiny Aya Global: Универсальный чекпоинт для всех языков.
Tiny Aya Earth: Африка и Западная Азия.
Tiny Aya Fire: Южная Азия.
Tiny Aya Water: Азиатско-Тихоокеанский регион и Европа. Мы тут
GGUF: Есть к каждой версии в 4, 8 и 16-бит.
iOS и Android: модели доступны в PocketPal
🟡Результаты тестов
Global-версия бьет Gemma 3-4B в 46 языках из 61 на бенче WMT24++.
На iPhone 17 Pro выдает 32 токена/сек, на стареньком iPhone 13 - около 10 токенов/сек в квантовании Q4_k_m.
Самый высокий показатель безопасности (91.1%) среди конкурентов (Qwen3-4B, Ministral-3-3B).
🟡Капля реализма
Это 3B модель. В сложных задачах она очевидно хуже или где-то рядом с одноклассниками, чудес ждать не стоит.
Несмотря на заявленное разнообразие, английский язык занимает львиную долю датасета во всех кластерах.
При сильном сжатии (ниже Q4) качество начинает заметно страдать, особенно на редких языках.
📌Лицензирование: CC-BY-NC-4.0 License.
🟡Блогпост
🟡Набор моделей
🟡Техотчет
🟡Demo
@ai_machinelearning_big_data
#AI #ML #SLM #TinyAya #Cohere