


Начиная с Qwen3-Next умные люди из Alibaba плотно подсели на Gated Delta Network в слоях внимания.
Но когда у вас контекст улетает за 256K, а размер моделей растет до сотен миллиардов параметров, этот блок начинает адски тормозить как обучение, так и инференс.
Базовое линейное внимание страдает от 2-х болячек:
Во-первых, это классические memory-bound ядра: они постоянно гоняют тензоры K, V и промежуточные стейты туда-сюда между HBM и чипом.
Во-вторых, из-за рекуррентной природы стейта вы просто не можете нормально утилизировать GPU при маленьких батчах или использования тензорного параллелизма. Сплошной простой вычислительных блоков.
В Qwen не стали лепить очередное монолитное ядро (которое на маленьких батчах и под TP все равно простаивает), а пошли на компромисс, написав библиотеку FlashQLA на базе TileLang:
🟢 Разбили прямой проход на два слитных ядра, а между ними вставили препроцессинг для автоматического контекстного параллелизма внутри одной карты.
🟠Главная фича Использовали свойство экспоненциального затухания гейта в GDN.
На 60-80% голов внимания влияние старых токенов быстро падает. Это значит, что нам не нужно считать рекуррентный стейт с самого начала последовательности.
FlashQLA делает легкий прогрев на 6-8 чанках и получает практически точный стейт для текущего блока.
🟢В рамках одного потокового мультипроцессора одни варпы занимаются только перекладыванием данных, пока другие в режиме пинг-понга молотят матричные умножения на Tensor Cores и CUDA Cores, скрывая задержки.
🟡Цифры
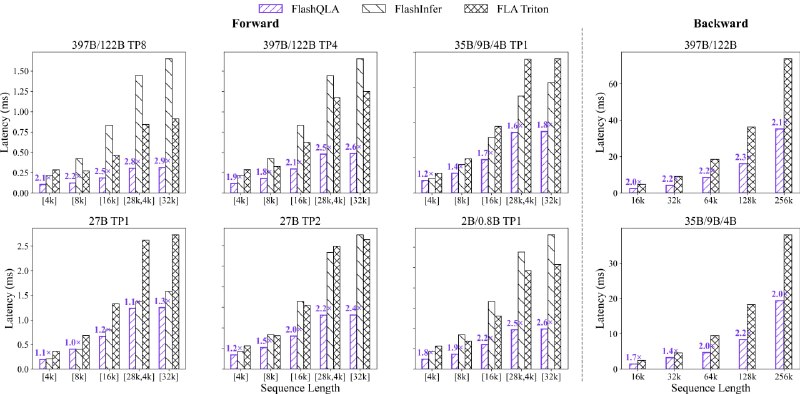
На чипах Hopper FlashQLA ускоряет forward в 2–3 раза, backward - в 2 раза относительно FLA Triton. На фоне FlashInfer отрыв ещё больше.
Особенно сочный буст виден на претрейне и при инференсе агентов, где обычно гоняется один длинный промпт.
🟡Ложка дёгтя
Старое железо - мимо: ядра требуют архитектуру SM90. Если у вас парк старых Ampere - ограничиваемся чтением статьи и копим бюджеты на H200.
Во-вторых, код сильно заточен под конкретную алгебру GDN, так что использовать это как замену для любого линейного внимания не получится.
Но Qwen достойны любви за эту красивую инженерную работу, где оптимизации логично вытекают из математических свойств самой архитектуры.
Посмотрим, как быстро этот подход растащат в другие фреймворки.
📌Лицензирование: MIT License
🟡Статья
🖥GitHub
@ai_machinelearning_big_data
#AI #ML #LLM #FlashQLA #Kernels #Qwen