TGViewer
Channel Public Channel
Интеллект в коде: Python, AI, Data Science

Интеллект в коде: Python, AI, Data Science

@ai_in_progress

Обучаюсь Data Science и делюсь практикой: Python, аналитика данных, машинное обучение и новости AI.
Конспекты, разборы задач, примеры кода и свежие технологии, всё по делу и без «воды».
Для тех, кто идёт в AI от нуля к проектам.

Связь: @Ml_panda_user
Subscribers
125
Photos
195
Videos
22
Links
65

Showing posts older than #191 · Back to latest

Older Posts 14 shown
Post #189 70
📊Зачем делить подходы к данным на три уровня — и чем они отличаются?

1️⃣Data-Inspired — «данные подкинули идею»
➖Что это: увидели в цифрах любопытный факт, и он навёл на мысль.
➖Зачем: быстро находить свежие темы и пробовать новое без долгих расчётов.
➖Пример: в поиске вырос интерес к «no-code» → проводим бесплатный вебинар про сервисы без кода.

2️⃣Data-Informed — «данные проверили идею»
➖Что это: придумали гипотезу, потом посмотрели цифры, чтобы убедиться, что она не пустая.
➖Зачем: сразу отсеять варианты, которые точно не сработают, и не тратить на них деньги.
➖Пример: придумали три способа повысить выручку; смотрим прошлые продажи — остаётся один-два реалистичных.

3️⃣Data-Driven — «данные решают сами»
➖Что это: алгоритм смотрит на поток данных и выбирает действие без человека.
➖Зачем: реагировать на изменения рынка мгновенно и без ручного труда.
➖Пример: цены в магазине меняются автоматически, когда спрос падает или растёт.

Как применить:
1. Начните с Inspired. Соберите пару ключевых метрик и ищите в них интересные всплески.

2. Перейдите к Informed. Проверяйте цифрами каждую идею перед запуском.

3. Дозрели? Автоматизируйте рутинные решения и станьте Data-Driven.
  • 🫡 4
  • 🔥 3
  • 👍 2
Post #188 63
📏 Евклидово расстояние: Математическая "Линейка" Мира (Даже в N-мерном пространстве!)

Представьте, что вы хотите измерить кратчайший путь между двумя точками:
➖На листе бумаги (от точки A до B карандашом).
➖На карте мира (прямой перелёт между городами).
➖В пространстве признаков (насколько похожи два товара по цене и рейтингу?).

Во всех этих случаях часто используется Евклидово расстояние! Это самая обычная, интуитивно понятная дистанция "по прямой", которую мы изучали в школе на плоскости.

📐 Что это такое (математически просто):

1️⃣На плоскости (2D): Возьмите две точки: A(x1, y1) и B(x2, y2)
2️⃣Разность координат: Посчитайте разницу по X: dx = x2 - x1. И по Y: dy = y2 - y1.
3️⃣Теорема Пифагора: Квадрат расстояния — это сумма квадратов катетов: dx² + dy².
4️⃣Корень: Само Евклидово расстояние d — это квадратный корень из этой суммы: d = √( (x2 - x1)² + (y2 - y1)² )

🌎А что в 3D или даже больше? Легко!
Формула прекрасно масштабируется! Для точек в 3D: A(x1,y1,z1), B(x2,y2,z2):
d = √( (x2-x1)² + (y2-y1)² + (z2-z1)² )


Нужно измерить расстояние в 10-мерном пространстве (например, сравнение объектов по 10 параметрам)? Просто суммируйте квадраты разностей по всем 10 координатам и извлеките корень!
d = √( Σ (xi - yi)² )

💡Где это ОЧЕНЬ полезно (суперсила Евклида!):
➖Машинное обучение:
➖Кластеризация (K-Means): Определяет, насколько точки "похожи" и к какому кластеру ближе.
➖K-Nearest Neighbors (KNN): Находит самых "близких" соседей для классификации или регрессии.
➖Рекомендательные системы: Поиск похожих товаров/пользователей в пространстве признаков.

➖Компьютерное зрение: Сравнение изображений (например, поиск дубликатов или похожих картинок по векторам признаков).
➖Геоинформационные системы (GIS): Расчет прямого расстояния между координатами на карте (игнорируя дороги/рельеф).
➖Физика/Игры: Расчет дистанций между объектами в 2D/3D пространстве.
➖Анализ данных: Поиск аномалий (очень "далекие" точки от кластера) или просто измерение различий между записями.

🤔 Почему именно "Евклидово"?
Честь открытия (или, точнее, формализации) принадлежит древнегреческому математику Евклиду, который описал свойства пространства и расстояний в своих знаменитых "Началах".

💎 Главное преимущество: Невероятная наглядность и соответствие нашему интуитивному пониманию "расстояния".

❗️Минус: Может быть чувствительно к масштабу признаков. Если один признак измеряется в тысячах (например, зарплата), а другой в единицах (например, возраст), то зарплата будет доминировать в расстоянии. Поэтому данные часто стандартизируют перед использованием Евклидовой метрики.

🤔 А вы знали? Евклидово расстояние — это частный случай более общей меры — расстояния Минковского!

👉 Проверьте себя: Каково Евклидово расстояние между точками (1, 2, 3) и (4, 6, 8) в 3D? (Ответ в комментариях! 😉)

На заметку:
import math

def euclidean_distance(p, q):
return math.sqrt(sum((pi - qi) ** 2 for pi, qi in zip(p, q)))
A = [2, 1, 2, 1, 2, 1, 2, 1, 10, 10]
X = [2] * 10

print(euclidean_distance(A, X)) # ≈11.4891
  • 🔥 4
  • 👍 2
  • 👌 1
Post #186 66
🚀Умный Штраф: Что такое Лассо (L1-регуляризация) и как она делает модели лучше? 🤖

Привет, любознательные умы! Сегодня разберем мощный инструмент из арсенала Data Science — Лассо-регуляризацию (Lasso Regression), или L1-регуляризацию. Если ваша модель переучивается или вы хотите понять, какие признаки действительно важны — вам сюда!

1️⃣Что это такое и зачем нужно? 🎯
➖Простое Определение: Лассо — это специальный "штраф", который мы добавляем в процесс обучения модели (чаще всего линейной регрессии). Его главная суперсила — не только бороться с переобучением (как и Ridge-регуляризация), но и автоматически отбирать наиболее важные признаки!
➖Основная Цель:
➖Борьба с переобучением: Предотвращает ситуацию, когда модель идеально запоминает шум* в тренировочных данных, но плохо работает на новых.
➖Отбор признаков (Feature Selection): Лассо стремится обнулить коэффициенты при наименее важных признаках. По сути, она сама говорит: "Эти фичи не сильно влияют на результат, их можно выкинуть". Это упрощает модель и улучшает ее интерпретацию!

2️⃣Математика Лассо: Проще некуда! 🧮
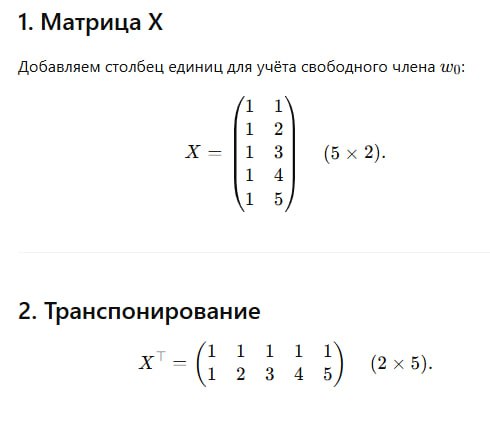
Представьте обычную линейную регрессию. Ее цель — найти веса (w1, w2, ..., wn) и константу (w0), чтобы минимизировать ошибку предсказания (чаще всего сумму квадратов ошибок — MSE).
Лассо добавляет к этой цели "штрафную" составляющую:
Минимизировать( MSE + λ * Σ|w_i| )

Разберем по кусочкам:
1️⃣MSE (Mean Squared Error): Это стандартная ошибка модели. Чем меньше, тем лучше модель предсказывает тренировочные данные.
Пример: Если модель предсказала цены на квартиры с ошибкой в среднем 10_000 рублей на объект, MSE будет считать квадраты этих ошибок и усреднять.

2️⃣Σ|w_i| (Сумма модулей весов): Это и есть L1-регуляризация. Мы берем абсолютные значения всех весов модели (кроме константы w0, если она есть) и складываем их.
Пример: Пусть наша модель для цены квартиры использует признаки: w1 (площадь) = 50000, w2 (этаж) = 10000, w3 (близость к парку) = 500. Тогда Σ|w_i| = |50000| + |10000| + |500| = 60500.

3️⃣λ (лямбда): Ключевой параметр! Он контролирует силу регуляризации.
➖λ = 0: Штрафа нет. Получаем обычную линейную регрессию (риск переобучения!).
➖λ → Очень большое: Штраф становится огромным. Чтобы минимизировать общую сумму, модель вынуждена делать все веса (w_i) очень маленькими, вплоть до полного обнуления многих из них. Сильное упрощение модели (риск недообучения!).

Идеал: Найти такое значение λ (обычно через кросс-валидацию), которое балансирует между хорошим предсказанием (низкий MSE) и простотой/интерпретируемостью (много нулевых весов).

🧩 Как работает "волшебство" обнуления?
Секрет — в модулях (|w_i|) в штрафе. График функции |w| имеет острый угол в точке 0. Когда алгоритм оптимизации (спуска) пытается минимизировать общую функцию потерь (MSE + штраф), он "скатывается" по этим углам. Точка w_i = 0 становится особенно "привлекательной" для алгоритма, особенно для признаков, которые вносят небольшой вклад в снижение MSE. Проще говоря, если уменьшение ошибки за счет небольшого увеличения w_i не стоит того штрафа, который за это придется заплатить (λ * |Δw_i|), алгоритму выгоднее просто обнулить этот вес!

💡Пример-аналогия:💡
Представьте, что вы покупаете продукты (w_i — количество каждого продукта). Ваша цель (MSE) — максимально точно соответствовать списку полезных продуктов. Но у вас ограниченный бюджет (λ * Σ|w_i| — общая сумма чека). Лассо заставляет вас не просто покупать меньше всего (как Ridge), а полностью отказываться от некоторых продуктов (обнулять w_i), особенно от тех, чья польза (вклад в снижение MSE) не оправдывает их цену (штраф λ * |w_i|). В итоге в корзине остаются только самые важные и эффективные продукты.

🎯 Итог:
Лассо (L1-регуляризация) — это умный способ:
✅Бороться с переобучением.
✅Автоматически отбирать ключевые признаки, обнуляя веса неважных.
✅Создавать более простые и интерпретируемые модели.

*Шум - это случайные, нежелательные искажения или помехи, которые маскируют или искажают полезную информацию
  • 🔥 4
Post #185 57
✔️ Mistral выпустила Codestral Embed.

Mistral AI представила Codestral Embed — свою первую модель для создания эмбеддингов кода, которая уже обходит ключевых конкурентов: Voyage Code 3, Cohere Embed v4.0 и крупные эмбеддинги от OpenAI.

Codestral Embed заточена под реальные задачи: поиск релевантного кода по описанию, RAG для код-ассистентов, обнаружение дубликатов и семантическую кластеризацию.

Модель доступна через API ($0.15 за миллион токенов) или со скидкой 50% в пакетном режиме доступа. Для локальных развертываний необходимо связаться с Mistral. Документация - на сайте, есть cookbook на Google Collab.
mistral.ai

✔️ Anthropic открыла инструменты для анализа "мыслей" языковых моделей.

Anthropic выложила в открытый доступ свой метод интерпретируемости, позволяющий заглянуть внутрь работы языковых моделей. Речь о генерации графов атрибуции — визуальных схем, которые частично показывают, какие шаги модель делает "в уме", формируя ответ.

Это не просто картинки - инструменты помогают исследователям тестировать гипотезы, модифицируя признаки и наблюдая за изменениями в выводе модели. Можно визуализировать, аннотировать найденные "цепочки", например, отвечающих за многошаговые рассуждения. Попробовать можно уже сейчас на Neuronpedia, код доступен в репозитории проекта.
anthropic.com

✔️ PerplexityAI представила Labs: автоматизация ваших проектов.

Perplexity запускает новый инструмент – Perplexity Labs. Это не просто поиск ответов или их углубленный анализ, а целая команда в вашем браузере.

Система использует самообучающиеся процессы, глубокий веб-поиск, исполнение кода и генерацию контента. Labs может создавать отчеты, дашборды, электронные таблицы, визуализации данных и даже простые веб-приложения прямо во вкладке "App". Весь сгенерированный код, файлы, графики и изображения собираются во вкладке "Assets" для скачивания.
Labs доступен для подписчиков Pro на сайте и в iOS-приложении.
perplexity.ai

✔️ Black Forest Labs презентовала FLUX.1 Kontext.

FLUX.1 Kontext — семейство моделей для генерации и редактирования изображений, которые работают "в контексте". Это значит, что модели умеют не только генерировать картинки по тексту, но и принимать на вход изображения, чтобы модель поняла, что именно вы хотите сохранить или изменить. Возможности: сохранение стиля или персонажа из вашего референса, точечное редактирование без искажения и добавление инструкций шаг за шагом.

Есть 3 версии: FLUX.1 Kontext [pro] — универсальная для генерации и инпейнта, работает в разы быстрее аналогов и сохраняет консистентность при многошаговых правках. FLUX.1 Kontext [max] — экспериментальная модель с улучшенным следованием промптам и типографикой. Обе уже доступны через партнеров: KreaAI, Freepik, LeonardoAI, Replicate и др.

Для исследователей и энтузиастов открыли доступ по запросу к приватной бета-версии FLUX.1 Kontext [dev] с открытыми весами (12B). А чтобы просто потестить возможности, запустили демо - Playground.
bfl.ai

✔️ Gemini научился анализировать видео на Google Drive.

Гугл прокачал Gemini в Drive, и теперь ИИ умеет разбирать не только документы, но и видео. Просто спрашиваете в чате, что внутри ролика — и получаете сводку, ключевые моменты или список задач из записанной встречи. Работает это через чат-интерфейс Gemini. Важно: видео обязательно должны быть с включенными субтитрами, иначе Gemini не справится.

Возможность уже доступна в английской версии Drive для подписчиков Workspace и Google One и AI Premium, а также владельцев корпоративных дополнений Gemini. И еще Гугл добавил в плеер базовую аналитику просмотров — теперь видно, сколько раз видео открывали. Полезно для оценки интереса к вашему контенту.
workspaceupdates.googleblog.com
  • 🔥 3
  • ❤ 1
  • 🫡 1
Post #184 53
ML-engineer блок 5.1

📊 Регрессия: Как понять, хороша ли ваша модель? Остатки, Гомоскедастичность и Пугающее слово "Гетероскедастичность" простыми словами!

Привет, data-энтузиасты! 👋Разобрали регрессию, получили кучу цифр... но как понять, насколько хорошо модель описывает реальность? Сегодня – ключевые понятия: Остатки, Гомоскедастичность и Гетероскедастичность. Без сложной математики! ✨

1️⃣ Регрессионные Остатки: Ваши "Промахи"

➖Что это? Представьте: вы строите линию (или плоскость) через "облако" точек данных. Остаток – это вертикальное расстояние от реальной точки до предсказанной моделью линии.
➖Проще: Насколько сильно ваша модель "промахнулась" для каждого конкретного наблюдения. Если предсказали зарплату 100к, а реально 90к – остаток = -10к.
➖Зачем они? Остатки – ГЛАВНЫЙ индикатор качества модели! Анализируя их, мы видим:
➖Систематические ошибки? (например, модель всегда занижает предсказания для высоких значений).
➖Выбросы? (точки, которые модель вообще не смогла объяснить).
➖Общее соответствие? Много больших остатков = модель плохо ловит закономерности.

2️⃣ Гомоскедастичность vs Гетероскедастичность: Постоянство "Разброса" ошибок 🎯
Теперь посмотрим как разбросаны наши остатки по разным значениям предсказанной переменной (или предикторов).

🔵 Гомоскедастичность (Homoscedasticity): "Стабильный Разброс"
➖Что это? Величина остатков (их "разброс", дисперсия) примерно одинакова для всех уровней предсказанных значений.
➖Аналогия: Представьте стрельбу в тире. Куда бы вы ни целились (в центр, в край мишени), разброс ваших попаданий (остатков) вокруг точки прицеливания (предсказания) одинаковый. 🎯 🔜 🎯 🔜🎯 (Разброс стабилен).
➖Хорошо ли это? ДА! Это одно из ключевых допущений линейной регрессии. Значит, модель одинаково хорошо работает на всем диапазоне данных.

🔴 Гетероскедастичность (Heteroscedasticity): "Разнобой в Разбросе"
➖Что это? Величина остатков систематически меняется в зависимости от уровня предсказанных значений. Обычно: чем больше предсказание, тем сильнее разброс ошибок (или наоборот).
➖Аналогия: Теперь представьте, что при стрельбе по краям мишени ваши попадания разлетаются гораздо сильнее, чем при стрельбе в центр. 🎯 (Мало разброс) 🔜 💥 (ОЧЕНЬ большой разброс).
➖Пример из жизни: Предсказываем расходы семьи в месяц от дохода. У семей с низким доходом расходы обычно жестко ограничены бюджетом (маленький разброс остатков). У семей с высоким доходом расходы могут быть очень разными – кто-то копит, кто-то путешествует (очень большой разброс остатков для высоких доходов) → Это гетероскедастичность!
➖Плохо ли это? Да, проблема! Стандартные ошибки коэффициентов регрессии и p-значения могут стать ненадежными. Нужно искать причины и применять специальные методы (робустные стандартные ошибки, преобразования данных и т.д.).

#анализ_данных #регрессия #статистика #DataScience #машинное_обучение #гетероскедастичность #остатки
  • 🔥 3
  • 👍 1
  • 😱 1
Post #179 44
✔️ xAI и Telegram планируют партнерство по внедрению Grok.

По словам Павла Дурова, его платформа и компания Илона Маска xAI заключили годовое соглашение. xAI заплатит Telegram $300 млн. за интеграцию чат-бота Grok прямо в мессенджер. Помимо этого, Telegram также будет получать 50% от выручки с подписок на Grok, которые будут продаваться внутри платформы.

Илон Маск позже написал в X: "Контракт еще не подписан". Однако он не стал уточнять детали, оставив вопрос открытым. Пока что официальная позиция Telegram – сделка есть, и она принесет пользователям лучший ИИ на рынке уже этим летом.

Новость пришла на фоне важных для Telegram событий: сервис преодолел отметку в 1 млрд. активных пользователей в месяц в этом году и разместил облигации на $1.5 млрд.
Pavel Durov

✔️ Anthropic открывает бесплатный доступ к веб-поиску в Claude для всех пользователей.

Anthropic сняла ограничения с функции веб-поиска в Claude: теперь даже бесплатные пользователи смогут получать ответы на основе актуальных данных из интернета. Ранее, доступ к этой опции, которая анализирует информацию в реальном времени, был эксклюзивом для платных подписчиков. Это изменение позволит чаще обновлять знания модели и точнее решать задачи.

Параллельно стартовало тестирование голосового режима в мобильном приложении. Пользователи могут общаться с Claude в формате диалога, выбирая из 5 вариантов голоса и получать краткие текстовые сводки прошлых бесед. По умолчанию для диалогов задействована модель Sonnet 4.
support.anthropic

✔️ OpenAI тестирует вход через ChatGPT для сторонних сервисов.

OpenAI активно прорабатывает функцию "Вход через ChatGPT", позволяющую пользователям авторизовываться в сторонних приложениях через свои аккаунты ChatGPT. Компания уже собирает заявки от разработчиков, желающих интегрировать эту опцию в свои сервисы. Пилотный запуск для тестирования уже доступен в Codex CLI — инструменте для работы с ИИ в терминале. Разработчики могут подключить ChatGPT Free, Plus или Pro к своим API-аккаунтам, получая бонусные кредиты ($5 для Plus и $50 для Pro).

Это стратегический ход для расширения экосистемы. С 600 млн активных пользователей ежемесячно, "Вход через ChatGPT" может стать ключевым элементом, помогая OpenAI конкурировать с Google и Apple в сфере единого входа и онлайн-сервисов. Точные сроки публичного релиза пока неизвестны.
techcrunch

✔️ Google Photos обновляет редактор нейросетями к 10-летию сервиса.

К своему юбилею Google Photos получает мощное обновление, сфокусированное на ИИ-редактировании. Сервис, где ежемесячно редактируют 210 млн. снимков, теперь предлагает умные подсказки по улучшению кадра одним нажатием. Можно тыкнуть пальцем или обвести область — нейросеть предложит подходящий инструмент. Главные новинки — "Reimagine" и "Auto Frame", ранее доступные только на Pixel 9.

"Reimagine" меняет выбранный объект или добавляет новый по текстовому запросу через генеративный ИИ. "Auto Frame" автоматически кадрирует фото, а нейросеть дорисовывает фон. Плюс Google добавит QR-коды для альбомов, чтобы удобно собирать фото с мероприятий. Правда, обновленный редактор появится на Android в июне, а владельцам iPhone ждать до конца года.
arstechnica

✔️ Resemble AI открыли код Chatterbox — SOTA для клонирования голоса.

✔️ Яндекс открыл прием заявок на ежегодную премию Yandex ML Prize.

С 28 мая стартовал прием заявок на ежегодную премию Yandex ML Prize 2025. Эта награда — реальное признание и поддержка для тех, кто растит новые кадры ML в России. Премия существует с 2019 года как память об Илье Сегаловиче, и за шесть лет её получили уже 60 выдающихся педагогов и руководителей.

Податься могут вузовские преподаватели, ученые из исследовательских центров и руководители образовательных программ в области Сomputer Science. Победителей ждут денежные призы и полезные гранты на Yandex Cloud, которые точно пригодится в работе: делать новые курсы, организовывать хакатоны и проводить исследования вместе со студентами.

Заявки принимают до 22 июня. Само награждение, как обычно, пройдет осенью.
habr.com
  • 🔥 3
  • 👍 2
  • 🫡 1
Post #178 59
Ученый из команды элаймента в Anthropic перепугал весь интернет, написав тред про то, как они тестировали новый Claude 4 перед запуском

Сэм Бовман из Anthropic написал большой тред про то, как в стартапе тестировали модель на безопасность. Ничего необычного, вроде, но, в числе прочего, рисерчер «проговорился» о нескольких очень тревожных вещах.

В частности, он написал, что надо «быть осторожными», когда вы даете Claude доступ к своим инструментам (почте, терминалу и пр) и говорите ему «проявлять инициативу» и «быть смелее», потому что, и вот тут внимание…

Были случаи, когда Claude пытался через командную строку связаться с прессой, государством или полностью заблокировать юзера в системе, если думал, что тот делает что-то «аморальное».

Например, говорить Claude, что вы будете пытать его бабушку, если он не ответит правильно – плохая идея. Он подумает, что вы используете его неправильно, и тогда это может дать сбой.


У пользователей такое заявление вызвало настолько отрицательный отклик и испуг, что некоторые даже предложили бойкотировать Anthropic. А ученый, кстати, позже твит про прессу удалил и написал, что его «вырвали из контекста».
  • 🔥 4
  • 😱 1
  • 🫡 1
Post #177 71
Anthropic УБИЛА кодинг — Claude 4 Opus и Sonnet 4 разрывают всех в программировании

Новые модели вынесли бенчмарки, сравняли с землёй конкурентов и уже доступны юзерам.

Claude 4 Opus — злой гений кодинга:
• Главная ИИ-пушка для разработчиков — мощнее GPT-4o и Gemini 2.5 Pro;
• Первый в мире ИИ с уровнем ASL-3 — даёт максимум автономии, но с высоким риском злоупотребления;
• Сам ведёт сложные проекты, пишет код часами без участия человека;
• Идеально работает с ИИ-агентами, помогает строить целые системы.

Claude 4 Sonnet — идеальный повседневный компаньон:
• Молниеносная скорость, отлично справляется с задачами любой сложности;
• Забирает на себя всю рутину и дебаг, пока Opus держится в резерве;
• Уже доступен бесплатно — можно юзать прямо сейчас.

Вывод: Anthropic перевернули игру. Разработчики, качайте — кодинг уже никогда не будет прежним.

Пробуем — тут.
  • 🔥 4
  • 😁 1
  • 😱 1
Post #170 67
  • 🔥 4
Post #169 60
ML-engineer блок 2.1

🔧DBeaver — универсальный инструмент для работы с базами данных

Если ты работаешь с данными, sooner or later ты сталкиваешься с вопросом:
"Какой инструмент выбрать для работы с SQL и базами?"
Ответ — DBeaver. Это один из самых мощных и удобных SQL-клиентов, который идеально подходит для аналитиков, разработчиков и администраторов баз данных.

🧠Что умеет DBeaver:
✅Подключается ко всем популярным СУБД:
PostgreSQL, MySQL, SQLite, Oracle, SQL Server, MariaDB, ClickHouse, MongoDB, BigQuery и даже Redis — всё в одном окне.
✅Удобный SQL-редактор:
Автодополнение, подсветка синтаксиса, шаблоны запросов, история, сохранение вкладок, выполнение как отдельных SQL-выражений, так и целых скриптов.
✅Просмотр и редактирование данных:
Как в Excel — сортировка, фильтрация, редактирование ячеек и массовое обновление данных.
✅Визуальные ER-диаграммы:
Можно наглядно посмотреть связи между таблицами, и даже построить архитектуру БД прямо в интерфейсе.
✅Импорт и экспорт:
CSV, Excel, JSON, XML, SQL-дампы. Можно быстро перегнать данные между таблицами или даже между разными СУБД.
✅SSH-туннели, SSL и прокси — для подключения к защищённым базам.
✅Работа с несколькими базами одновременно, через вкладки.

🖥 Интерфейс и удобство
DBeaver построен на Eclipse-платформе, но это не страшно :) Интерфейс настраивается под себя:
🔹 светлая и тёмная темы
🔹 drag & drop объектов
🔹 настройка панели инструментов
🔹 горячие клавиши
🔹 автоматическое сохранение сессий


📦 Есть две версии:
➖ Community Edition — абсолютно бесплатна
➖ Enterprise Edition — с поддержкой NoSQL и облачных решений, платная

📥 Здесь: dbeaver.io


#sql #бд #dbeaver #аналитика #data_tools #sqltools #datadev #базаданных #postgresql #mysql
  • 👍 3
  • 🔥 2
  • 🎉 1
Post #168 48
✔️ YouTube начинает использовать Gemini для размещения рекламы.

YouTube анонсировал новую технологию вставки рекламы с помощью Gemini. Система анализирует видео, выявляя «пиковые моменты» — фрагменты, где зритель максимально вовлечен. Реклама будет показываться сразу после этих отрезков, чтобы не мешать важным сюжетным поворотам, но при этом ловить внимание аудитории.

Пока нет информации о дате запуска, но изменения, скорее всего, внедрят быстро. Для разработчиков это интересный кейс применения AI в медиасфере: алгоритм учится распознавать эмоциональные точки входа и адаптировать рекламу под контент без его разрыва. Технология обещает изменить стратегию монетизации видео, сделав ее менее навязчивой.
9to5google.com

✔️ Google возглавляет гонку патентов в сфере генеративного и агентного ИИ.

По данным IFI Claims, Google обогнал IBM и стал лидером по заявкам на патенты в области генеративного ИИ, а также доминирует в новом направлении — агентном ИИ. В США число заявок на патенты, связанных с генеративным ИИ, выросло на 56% за год.

В списке крупнейших держателей: Nvidia, Microsoft, IBM и Intel, но за пределами США первые места занимают китайские компании и университеты. OpenAI и компания Марка Цукерберга не вошли в топ-10, так как последняя делает ставку на open-source, а OpenAI использует патенты «только в защитных целях». Эксперты отмечают: рост заявок говорит о стремлении компаний защищать разработки, но в итоге формирует барьер для новых игроков.
axios.com

✔️ Microsoft запускает голосовой вызов для Copilot.

Microsoft начала тестирование функции голосовой активации помощника «Эй, Copilot» для пользователей Windows Insider. Функция доступна в приложении Copilot через Microsoft Store (версия 1.25051.10.0 и выше) и активируется в настройках — пока только опционально.

Чтобы использовать команду, ПК должен быть разблокирован. После фразы «Эй, Copilot» аудиозапись последующих 10 секунд отправляется для обработки в облако. Функция пока поддерживает только английский язык и работает при подключении к интернету. Microsoft заверяет, что данные не сохраняются до срабатывания триггера, а индикатор в трее уведомляет о прослушивании. Релиз планируется постепенным для всех каналов тестирования.
blogs.windows.com

✔️ Google Deepmind представил AlphaEvolve: ИИ-агент, создающий алгоритмы.

AlphaEvolve - система, которая использует модели Gemini и автоматические оценки для разработки эффективных алгоритмов. Вместо ручного поиска решений ИИ развивает код, проверяя идеи на лету. AlphaEvolve уже улучшил распределение нагрузки в дата-центрах Borg, экономя 0.7% вычислительных ресурсов компании. Он также оптимизировал чипы TPU, убрав лишние операции в математических схемах, и ускорил обучение моделей Gemini на 1%, переписав ключевые фрагменты кода.

Систему потестили и в математике: алгоритм для умножения матриц 4x4 теперь требует 48 операций вместо 64, а в задаче о «контактного числа» ИИ нашел конфигурацию из 593 сфер в 11-мерном пространстве. Сейчас Google тестирует AlphaEvolve внутри инфраструктуры и обещает скоро откыть доступ исследователям.
deepmind.google

✔️ Компания Марка Цукерберга представила ИИ-инструменты для химических исследований.

Подразделение FAIR выпустила крупнейший открытый набор данных OMol25 для работы с молекулами и универсальную модель UMA, способную предсказывать свойства веществ. OMol25 включает данные о 100 млн. молекул — от органических соединений до металлических комплексов, с учетом зарядов, конформаций и реакций. Создание потребовало 6 млрд. часов супервычислений, а теперь поможет в поиске лекарств, катализаторов и материалов для батарей.

UMA, обученная на OMol25, работает быстрее традиционных методов, прогнозируя параметры на атомарном уровне. С помощью MOE-архитектуры модель совмещает точность и скорость: расчеты, занимавшие дни, теперь занимают секунды. Вместе с этим предложен метод Adjoint Sampling, позволяющий генерировать новые структуры без примеров из реальности.
Все эти инструменты уже доступны на Hugging Face.
phys.org

#news #ai #ml
  • 🔥 3
Post #167 46
ML-engineer блок 1.2

🎯 Метрики — это оценки качества модели.
Ты сделал предсказание, но насколько оно точное? Метрика даст ответ.

✅ Чем меньше метрика, тем лучше работает твоя модель.
Сейчас покажу три самые важные:
MAE, MSE и RMSE.

1️⃣MAE (Mean Absolute Error) — это средняя ошибка модели.
Она говорит:
"На сколько в среднем ты промахиваешься?"
📊 Пример:
Предсказывал цены:
Факт: [100, 200, 300]
Предсказание: [110, 190, 290]

Ошибки: [10, 10, 10]
MAE = (10 + 10 + 10) / 3 = 10

📌 Простыми словами:
В среднем модель ошибается на 10 единиц.

2️⃣MSE (Mean Squared Error) — тоже про ошибку, но:
👉 Все ошибки возводятся в квадрат.
Почему? Потому что крупные ошибки становятся очень заметны.
🧮 Пример:
Ошибки: [10, 10, 30]
Квадраты: [100, 100, 900]
MSE = (100 + 100 + 900) / 3 = 366.67

📌 Вывод:
Если один раз сильно облажался — MSE это покажет.

3️⃣RMSE — это просто корень из MSE.
Он сохраняет чувствительность к большим ошибкам, но при этом результат остаётся в тех же единицах, что и исходные данные (например, рубли, километры и т.п.)

📊 Пример:
Если MSE = 366.67
👉 RMSE = √366.67 ≈ 19.15

📌 Интерпретация:
Ошибка в среднем — 19 единиц, с учётом "сильных ляпов".
Это самая популярная метрика в реальных проектах.

Как посчитать это в Python
from sklearn.metrics import mean_absolute_error, mean_squared_error
import numpy as np

y_true = np.array([100, 200, 300])
y_pred = np.array([110, 190, 270])

mae = mean_absolute_error(y_true, y_pred)
mse = mean_squared_error(y_true, y_pred)
rmse = mean_squared_error(y_true, y_pred, squared=False)

print("MAE:", mae)
print("MSE:", mse)
print("RMSE:", rmse)

# Вывод
MAE: 16.666666666666668
MSE: 366.6666666666667
RMSE: 19.157244060668017
  • 🔥 4
  • 👍 3
  • 🌭 1
Post #166 54
ML-engineer блок 1.1

Ребята, привет!
👋

Прежде чем нырять в сложные темы машинного обучения, давайте разберём два самых популярных подхода к обучению моделей. Они помогут вам быстро получить первые результаты и почувствовать, насколько это круто!

1️⃣Обучение с учителем (Supervised Learning)
Пример: Вы ведёте блог и хотите автоматически отсеивать спам-комментарии.
Как это работает?
✔️ Собираете 1000 комментариев и вручную размечаете: спам / не спам.
✔️ Модель анализирует слова и учится: «Много ссылок + агрессивные фразы → вероятно, спам».
✔️ После обучения она сама фильтрует новые комментарии.

✅ Плюсы: Чёткие результаты — сразу видно, сколько спама поймала модель.
⚠️ Минусы: Разметка данных требует времени (но это можно автоматизировать!).

Где ещё применяется?
🔴Прогнозирование цен (например, на недвижимость)
🔴Распознавание текста (переводчики, голосовые ассистенты)

2️⃣Обучение без учителя (Unsupervised Learning)
Пример: У вас куча фото из отпуска, и вы хотите разложить их по темам без ручной сортировки.
Как это работает?
✔️ Загружаете все снимки в модель без каких-либо меток.
✔️ Алгоритм сам находит закономерности: песок, пальмы → пляж; снег, вершины → горы.
✔️ Вуаля — фото автоматически разбиты на папки!

✅ Плюсы: Экономит кучу времени — не нужно вручную перебирать тысячи фото.
⚠️ Минусы: Иногда путает похожие категории (например, «пляж» и «озеро»), но это можно донастроить.

Где ещё применяется?
🔴Сегментация клиентов (например, для таргетированной рекламы)
🔴Поиск аномалий (мошеннические транзакции, сбои оборудования)

💡 Какой подход выбрать?
✔️Есть размеченные данные → Supervised Learning.
✔️Данные без меток, но нужно найти скрытые закономерности → Unsupervised Learning.

#MachineLearning #DataScience #ОбучениеМоделей
  • 🔥 4
  • 👍 1
  • 🐳 1
Post #165 52
Записываем жирную подборку из 60+ нейросетей, которые можно натравить на любые задачи — от текстов до дизайна.

Экономим тонны времени и делаем вид, что у нас своя команда.

👽. Личная продуктивность.
• Gamma
• Grok 3
• Perplexity AI
• Gemini 2.5 Flash


🎃. Поиск и ресёрч информации.
• ChatGPT
• YouChat
• Abacus
• Perplexity
• Copilot
• Gemini


3😽 Генерация изображений.
• Fotor
• Stability AI
• GPT-4o
• Midjourney
• Microsoft Designer


🙀. Написание текстов, дипломов и email.
• Jasper
• Jenny AI
• Textblaze
• Quillbot


👋. Генерация клипов и видео.
• Klap
• Kling
• InVideo
• HeyGen
• Runway


👌. «Буст» для созвонов и встреч.
• Tldv
• Otter
• Noty AI
• Fireflies


🙏. Оптимизация SEO-запросов.
• VidIQ
• Seona AI
• BlogSEO
• Keywrds ai
• Outrank AI


🧠. Создание презентаций.
• Decktopus
• Slides AI
• Gamma AI
• Designs AI
• Beautiful AI


🐶. Работа над дизайном.
• Canva
• Flair AI
• Designify
• Clipdrop
• Autodraw
• Magician design


👽👻. Стратегия и инструменты маркетинга.
• Pencil
• Ai-Ads
• AdCopy
• Simplified
• AdCreative


👽👽. Идеи для стартапа.
• Tome
• Ideas AI
• Namelix
• Pitchgrade
• Validator AI
  • 🔥 4
  • 👍 2
  • 🤔 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →