TGViewer
Channel Public Channel
Интеллект в коде: Python, AI, Data Science

Интеллект в коде: Python, AI, Data Science

@ai_in_progress

Обучаюсь Data Science и делюсь практикой: Python, аналитика данных, машинное обучение и новости AI.
Конспекты, разборы задач, примеры кода и свежие технологии, всё по делу и без «воды».
Для тех, кто идёт в AI от нуля к проектам.

Связь: @Ml_panda_user
Subscribers
125
Photos
195
Videos
22
Links
65

Showing posts older than #123 · Back to latest

Older Posts 15 shown
Post #121 70
✔️ Nvidia выпускает 2 персональных суперкомпьютера.

На GTC 2025 NVIDIA представила новую серию «персональных суперкомпьютеров с ИИ», построенных на платформе Grace Blackwell - DGX Spark и DGX Station. На них пользователи смогут создавать прототипы, настраивать и запускать модели ИИ.

DGX Spark использует GB10 Grace Blackwell с вычислительной мощностью до 100 трлн. операций в секунду. DGX Station получила чип GB300 Grace Blackwell и 784 ГБ памяти. Spark уже доступен к предзаказу, а Station, как ожидается, будет выпущена в течение этого года.
nvidianews.nvidia.com

✔️ OpenAI выпустили o1-pro и сейчас это самая дорогая модель.

Цена $150 за миллион токенов на вход и $600 на выход. Что примерно в 270 раз дороже DeepSeek-R1.

✔️ В Gemini добавили новые инструменты.

В приложении Google Gemini появилась новая функция «Холст», которая предоставляет интерактивное пространство для редактирования текста в реальном времени, позволяя создавать черновики и экспортировать их в Google Docs. Он также может генерировать и просматривать код HTML/React для упрощения дизайна веб-сайта.

Помимо "Холста" была запущена функция "текст-в-аудио", которая может обобщать загруженный текст из файлов в аудиоформате и имитировать обсуждение двух ИИ-ведущих так же, как это реализовано в NotebookLM. В настоящее время поддерживается только английский язык, но обещают, что в будущем появится мультиязычность.
9to5google.com

✔️ RTX PRO 6000 от NVIDIA

NVIDIA анонсировала выпуск профессиональной серии видеокарт для ИИ, 3D и научных исследований. В линейке RTX PRO 6000 будет 3 версии: Workstation Edition в дизайне RTX 5090, Server Edition с пассивным радиатором охлаждения для ЦОДов и Max-Q Edition с системой воздушного охлаждения турбинного типа для мульти-GPU решений.

Все три версии получат 96 ГБ G7 ECC VRAM, чипы GB202 и 24064 CUDA-ядер. Энергопотребление у Workstation Edition и Server Edition - 600 Вт, а у Max-Q Edition - 300 Вт. Дата начала продаж: апрель-май 2025 года, стоимость в анонсе не раскрывалась.
theverge.com

✔️ xAI приобрела стартап Hotshot для развития генерации видео из текста.

Компания Илона Маска совершила первую крупную сделку, поглотив стартап Hotshot, известный разработкой text-to-video моделей. Как заявил Маск в соцсети X, вскоре пользователей ждут «крутые ИИ-видео» — вероятно, благодаря интеграции технологий Hotshot в экосистему xAI.

Hotshot был основан в 2017 году и изначально создавал инструменты для редактирования фото на базе ИИ, но позже переключился на генерацию видео. За 2 года команда разработала 3 фундаментальные модели: Hotshot-XL, Hotshot Act One и Hotshot, которые позволяют превращать текстовые описания в реалистичные ролики. Финансовые условия сделки не раскрыты, однако известно, что стартап получит доступ к кластеру Colossus — мощной инфраструктуре xAI с 200 000 GPU NVIDIA H100.
analyticsindiamag.com

✔️ Deloitte запускает Zora AI: автономные агенты для бизнеса.

Deloitte представила Zora AI — ИИ-платформу, которая объединяет агентов для автоматизации сложных бизнес-процессов. Решение, построенное на моделях Llama Nemotron с функциями анализа и рассуждений, способно автономно выполнять задачи в финансах, HR, логистике и других сферах.

Платформа автоматизирует моделирование сценариев, анализ рынка и управление расходами, что подтверждает внутренний опыт Deloitte: автоматизация процессов снизила затраты на 25%, а продуктивность команды выросла на 40%.
deloitte.com

#news #ai #ml
  • 🏆 3
  • 🔥 2
  • ✍ 1
  • 🌭 1
  • 🫡 1
Post #120 117
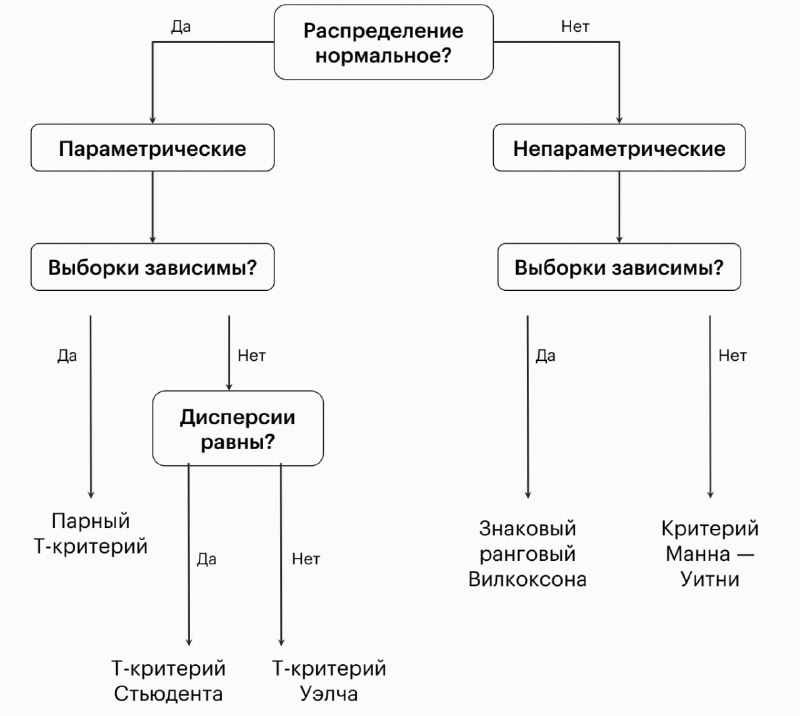
🔥 Как выбрать статистический тест для проверки гипотезы? 🔥
Когда приходится анализировать данные, важно выбрать правильный статистический тест.

1️⃣ Шаг 1: Проверка нормальности распределения
Тест Шапиро-Уилка:

➖Если p-value > 0.05 – распределение нормальное → используем параметрические тесты.
➖Если p-value < 0.05 – распределение ненормальное → используем непараметрические тесты.

Пример кода:
from scipy.stats import shapiro

data = [4.2, 5.1, 5.3, 6.0, 4.9, 5.8, 5.0, 5.5, 5.7, 6.1]
stat, p = shapiro(data)
print(f"p-value: {p:.4f}")

if p > 0.05:
print("Распределение нормальное — используем параметрические тесты")
else:
print("Распределение ненормальное — используем непараметрические тесты")


2️⃣ Шаг 2: Определяем тип выборок
➖Зависимые выборки: данные одной группы до и после вмешательства.
➖Независимые выборки: сравнение разных групп.
Пример:
*️⃣Сравнение результатов теста у студентов до и после курса (зависимые).
*️⃣Сравнение средней зарплаты между двумя разными группами (независимые).

3️⃣ Выбор теста
‼️Если распределение нормальное:
3.1 Зависимые выборки (Парный t-тест)
from scipy.stats import ttest_rel

before = [5, 6, 7, 8, 9]
after = [6, 7, 7, 8, 10]
stat, p = ttest_rel(before, after)
print(f"p-value: {p:.4f}")

Пример: Измеряем уровень стресса до и после медитации.

3.2 Независимые выборки
Сравнение дисперсий (тест Левена):
```from scipy.stats import ttest_ind, levene

group1 = [5, 6, 7, 8, 9]
group2 = [6, 7, 8, 9, 10]
stat_levene, p_levene = levene(group1, group2)

if p_levene > 0.05: # равные дисперсии(Т-критерий Стьюдента)
stat, p = ttest_ind(group1, group2, equal_var=True)
else: # неравные дисперсии(Т-критерий Уэлча)
stat, p = ttest_ind(group1, group2, equal_var=False)

print(f"p-value: {p:.4f}")```
Пример: Сравнение средней зарплаты мужчин и женщин.

‼️Если распределение ненормальное:
3.3 Зависимые выборки (Критерий Вилкоксона)
from scipy.stats import wilcoxon

before = [5, 6, 7, 8, 9]
after = [6, 7, 7, 8, 10]
stat, p = wilcoxon(before, after)
print(f"p-value: {p:.4f}")

Пример: Сравнение уровня тревожности до и после терапии.

3.4 Независимые выборки (Критерий Манна-Уитни)
from scipy.stats import mannwhitneyu

group1 = [5, 6, 7, 8, 9]
group2 = [6, 7, 8, 9, 10]
stat, p = mannwhitneyu(group1, group2)
print(f"p-value: {p:.4f}")

Пример: Сравнение времени реакции водителей двух возрастных групп.

#статистика #Python #анализданных #гипотезы #hypothesistesting #dataanalysis #кодинг #наука
  • 🔥 7
  • ⚡ 1
  • 😱 1
Post #119 95
🔎 Что такое гипотеза и как с ней работать?
Гипотеза — это предположение, которое требует доказательства. В анализе данных, науке и бизнесе гипотезы помогают проверять, как одни факторы влияют на другие.

В отличие от аксиом, гипотезы нельзя принимать на веру – их нужно тестировать с помощью данных и статистических методов.

📌 Пример гипотезы
📊 «Если мы изменим цвет кнопки “Купить” с синего на зеленый, то конверсия увеличится на 10%»

Эту гипотезу можно проверить с помощью A/B-теста: разделить пользователей на две группы, одной показать старую кнопку, другой – новую, и измерить разницу в конверсии.

🛠 Этапы работы с гипотезой

1️⃣ Формулировка гипотезы
Прежде чем что-то проверять, нужно четко сформулировать гипотезу.

❌ Плохо: «Изменение дизайна сайта повысит продажи».
✔️ Хорошо: «Изменение цвета кнопки "Купить" с синего на зеленый увеличит конверсию на 10%».

Как правильно формулировать гипотезу?
* Она должна быть конкретной (не "улучшит", а "увеличит на 10%").
* Она должна быть измеримой (должны быть данные для проверки).
* Должна быть понятна связь между изменяемым фактором и результатом.

📌 Другие примеры:
* «Если снизить цену на 5%, объем продаж вырастет на 15%».
* «Люди, занимающиеся спортом, в среднем живут дольше, чем те, кто не занимается».


2️⃣ Определение нулевой и альтернативной гипотез
В статистике сравниваются две гипотезы:
🔹 Нулевая гипотеза (H₀) – предполагает, что изменений нет.
🔹 Альтернативная гипотеза (H₁) – утверждает, что различия есть.


📌 Пример:
H₀: «Цвет кнопки не влияет на конверсию».
H₁: «Зеленая кнопка увеличивает конверсию».
Цель статистического анализа – либо подтвердить H₀, либо найти достаточно доказательств, чтобы ее отвергнуть.

3️⃣ Выбор метода проверки гипотезы
В зависимости от данных и гипотезы выбираем метод тестирования.
🔹 Числовые данные (средние значения):
- t-тест (сравниваем средние двух групп).
- ANOVA (если групп больше двух).
🔹 Категориальные данные (доли, частоты):
- Тест хи-квадрат (если данные разбиты на категории).


📌 Пример:
Для проверки гипотезы о влиянии цвета кнопки можно использовать A/B-тест и z-тест для пропорций, если сравниваем доли пользователей, совершивших покупку.

4️⃣ Установка уровня значимости (α)
Перед проверкой гипотезы выбираем уровень значимости (обычно α = 0.05).

Что это значит?

- Если вероятность случайного получения результата (p-value) меньше 5%, мы отвергаем H₀.
- Если p-value > 0.05, данных недостаточно, чтобы отвергнуть H₀.
Почему 5%? Это означает, что есть 5%-ный шанс ошибочно отвергнуть H₀, когда она на самом деле верна.


5️⃣ Проведение теста и анализ данных
На этом этапе:
✔️ Собираем выборку данных.
✔️ Проводим тест (например, A/B-тест).
✔️ Вычисляем p-value.

📌 Пример:
- В старой версии сайта конверсия = 2.5% (из 1000 человек 25 купили).
- В новой версии (зеленая кнопка) конверсия = 3.1% (из 1000 человек 31 купил).
- Используем z-тест → p-value = 0.02 (2%).


6️⃣ Интерпретация результатов
Если p-value < 0.05, отвергаем H₀, значит, изменения значимо повлияли.
Если p-value > 0.05, данных недостаточно для вывода о влиянии.


📌 Пример:
- p-value = 0.02 → различия значимые, кнопка действительно улучшает конверсию.
- p-value = 0.15 → недостаточно доказательств, цвет кнопки не оказывает явного влияния.


Если гипотеза подтвердилась → внедряем изменения.
Если нет → анализируем, в чем причина, корректируем гипотезу и пробуем снова.

📊 Итог: как правильно работать с гипотезами?
1️⃣ Формулируем четкую гипотезу (конкретную и измеримую).
2️⃣ Определяем нулевую и альтернативную гипотезы.
3️⃣ Выбираем подходящий тест (t-тест, χ², ANOVA и т. д.).
4️⃣ Задаем уровень значимости (обычно 5%).
5️⃣ Проводим тест и анализируем результаты.
6️⃣ Принимаем или отвергаем гипотезу на основе p-value.
  • 🔥 4
  • 🫡 2
  • 🤩 1
Post #118 66
🔥 Сегодня я перехожу к фазе Modeling в CRISP-DM!

После детального изучения бизнес-контекста, исследования и подготовки данных настало время строить модели! 🚀 Фаза Modeling — ключевой этап, где мы применяем алгоритмы машинного обучения, чтобы находить закономерности и делать предсказания.

📌 Основные задачи Modeling:
✅ Выбор алгоритмов: от линейной регрессии до градиентного бустинга и нейросетей
✅ Разделение данных на обучающую и тестовую выборки
✅ Подбор гиперпараметров и настройка моделей
✅ Оценка качества предсказаний с метриками (RMSE, MAE, R² и др.)
✅ Интерпретация результатов и доработка моделей

Моя цель — понять, какие алгоритмы лучше подходят под мои задачи, как их правильно настраивать и интерпретировать результаты. Буду разбираться в нюансах и делиться процессом.

#DataScience #CRISP_DM #MachineLearning #AI_in_Progress
  • 🔥 3
  • 💯 2
  • 👍 1
Post #114 79
Что такое One-Hot-кодирование❓
Представь, что у тебя есть данные, которые нельзя сразу использовать в виде чисел, например, названия животных, цветов или городов. Это называется категориальные данные, потому что они делятся на категории. One-Hot-кодирование — это способ превратить такие данные в числа, чтобы компьютер мог их понять, не путаясь.

Простыми словами, мы создаём для каждой категории отдельный столбец, где ставим:
➖1, если эта категория подходит,
➖0, если нет.
Давайте разберём это на новом, ещё более простом примере.
Пример : Любимые животные
У тебя есть три друга, и каждый любит одно животное:
- Аня любит кошек.
- Боря любит собак.
- Ваня любит рыбок.


Но компьютер может подумать, что собаки (2) "больше" кошек (1), а это неправильно — это просто разные животные, между ними нет порядка. Поэтому мы используем One-Hot-кодирование.
Как это выглядит после One-Hot-кодирования:
Мы создаём три столбца: "Кошки", "Собаки", "Рыбки". И для каждого друга ставим 1 там, где его любимое животное, и 0 в остальных местах.
Картинка 1

Теперь:
- Аня: [1, 0, 0] — любит кошек.
- Боря: [0, 1, 0] — любит собак.
- Ваня: [0, 0, 1] — любит рыбок.

Компьютер не запутается, думая, что одна категория "лучше" другой.
Каждый столбец независимый, и данные готовы для машинного обучения.


Как это сделать в коде❓
Давай применим One-Hot-кодирование🧑‍💻 к примеру с животными, используя Python🐍.

1. Создаём данные
import pandas as pd

data = {'Имя': ['Аня', 'Боря', 'Ваня'],
'Животное': ['кошки', 'собаки', 'рыбки']}
df = pd.DataFrame(data)
print(df)

Вывод: Картинка 2

2. Используем OneHotEncoder
from sklearn.preprocessing import OneHotEncoder

# Создаём энкодер
ohe = OneHotEncoder(sparse=False)

# Учим его на наших данных
ohe.fit(df[['Животное']])

# Преобразуем данные
ohe_animals = ohe.transform(df[['Животное']])
print(ohe_animals)

Вывод: Картинка 3

Это наши 1 и 0 для каждого человека:
- Аня: [1, 0, 0] (кошки)
- Боря: [0, 1, 0] (собаки)
- Ваня: [0, 0, 1] (рыбки)


3. Узнаём названия столбцов
print(ohe.get_feature_names())

Вывод (порядок может отличаться):
['x0_кошки' 'x0_собаки' 'x0_рыбки']


4. Добавляем в таблицу
df[ohe.get_feature_names()] = ohe_animals
print(df)

Вывод: Картинка 4

One-Hot-кодирование — это как переводчик, который помогает компьютеру понять категории без путаницы. Ты создаёшь "да/нет" столбцы для каждой категории, и это делает данные понятными и удобными для машинного обучения.
  • 🔥 4
  • 👍 2
  • 🤯 1
  • 😱 1
Post #113 52
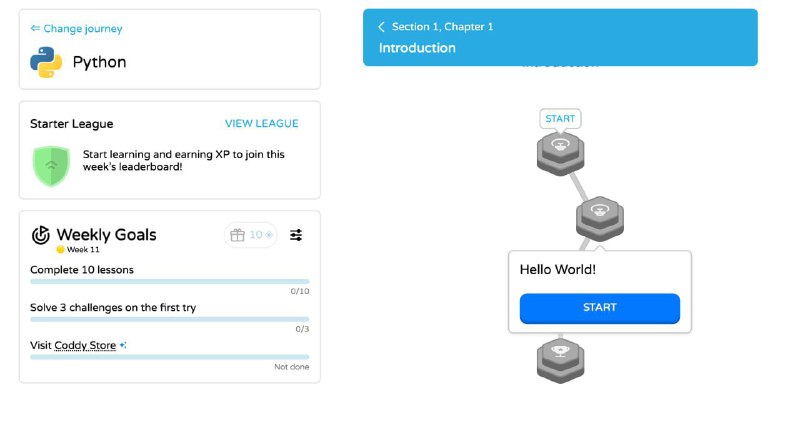
Учимся программированию с помощью игр — в сети нашли крутую платформу Coddy, где всё ваше обучение будет происходить через игру.

Как всё устроено:

— За каждый пройденный урок ваш перс будет продвигаться по карте и приближаться к финишу;
— Выполнение ежедневных испытаний даст вам дополнительного опыта, а стрик — «огоньки»;
— Заработанный опыт можно обменять на бустеры: например, на двухнедельную премиум-подписку.

Тему вы выбираете на своё усмотрение, кроме того, в любой момент можно переключиться на другую. Самое главное — все обучалки бесплатные.


Вкатываемся — здесь.
  • 🔥 3
  • 🐳 1
  • 🫡 1
Post #112 44
ML-комьюнити о крупнейших запусках LLM начала 2025 года:

✔️ DeepSeek — революция или переоцененный запуск?

Запуск китайской модели всколыхнул всю индустрию, вызвав неоднозначную реакцию экспертов. CEO Anthropic Дарио Амодей отмечает, что Claude 3.5 Sonnet, обученный за несколько десятков миллионов долларов, значительно опережает DeepSeek по многим показателям, плюс у модели нет никаких барьеров против генерации чувствительной информации. Демис Хассабис, генеральный директор Google DeepMind, считает DeepSeek лучшей работой китайских исследователей, но не видит в ней новых научных достижений.

✔️ Grok 3 — Маск не дотянул

ИИ-исследователь и профессор Пенсильванского университета Итан Моллик признал, что xAI очень быстро растёт, но Grok 3 пока точно не является лучшей моделью на рынке. Она превосходит некоторые модели OpenAI, но не o3. CTO Caylent Рэнделл Хант обнаружил ряд проблем с Grok 3: уязвимость к джейлбрейкам, неуместную саркастичность, медлительность и частые ошибки в ответах. По его словам, даже простые логические тесты оказались ей не под силу, что делает модель практически бесполезной для бизнес-задач. При этом CEO Replit Амджад Масад назвал Grok 3 передовой моделью и огромным достижением.

✔️ GPT-4.5 — не оправдал ожиданий экспертов

Релиз GPT-4.5 от OpenAI получил смешанные отзывы в профессиональном сообществе. Соучредитель OpenAI и бывший глава Tesla AI Андрей Карпатый отметил, что GPT-4.5 напомнил ему GPT-4 на момент релиза — он увидел потенциал этой модели. В посте на X он сказал, что при использовании GPT-4.5 «всё стало немного лучше, и это здорово, но не совсем так, как можно было бы ожидать». В более резких выражениях высказался известный критик Гэри Маркус, назвавший модель «пустышкой». Генеральный директор Hugging Face Клемент Деланж также остался недоволен, охарактеризовав GPT-4.5 как «так себе» и раскритиковав закрытость исходного кода.

✔️ YandexGPT 5 — что в России?

Виктор Тарнавский, директор по ИИ Т-Банка, отметил, что в Яндексе выложили Lite-версию модели в опенсорс, а пайплайн Pro-версии инициализировали весами от Qwen 2.5. По его мнению, это правильное решение, позволяющее избежать бессмысленной траты ресурсов. При этом, пишет Тарнавский, разработчики делают не файнтюн, а полный цикл обучения модели — просто стартуют претрейн не с нулевых весов. По опубликованным бенчмаркам, модели показывают хорошие результаты. В СМИ также писали, что Яндекс работает над ризонингом. Максим Болотских, директор ИИ в Яков и Партнёры (ex-McKinsey), прокомментировал, что ежегодные совокупные затраты на разработку подобного функционала могут составлять 10 млрд рублей и более, и такого рода модели могут монетизироваться не только классическими подписками B2C пользователей, но и значимо лучше решать задачи В2В-сегмента.

✔️ Gemini 2.0 Flash — лучшее соотношение цена/качество

Релиз Gemini 2.0 Flash от Google получил восторженные отклики экспертов. Тим Брукс, ИИ-исследователь в Google DeepMind, высоко оценил встроенную функцию генерации изображений с возможностью визуальной цепочки рассуждений. Соучредитель и бывший глава Intel AI Райан Карсон назвал модель "умной, быстрой и дешёвой", отметив отличную производительность при тестировании через API. Мэтт Шумер, соучредитель и генеральный директор компании OthersideAI, подчеркнул, что по большинству бенчмарков Gemini 2.0 Flash приближается к Claude 3.5 Sonnet и даже превосходит его в бенчмарке MATH, сохраняя при этом значительное ценовое преимущество.

✔️ Claude 3.7 — достойный шаг вперёд при умеренных затратах

Релиз Claude 3.7 от Anthropic получил преимущественно положительные отзывы экспертов. Сэм Альтман и Дарио Амодей подчеркнули экономическую эффективность разработки — обучение Claude 3.7 Sonnet обошлось лишь в несколько десятков миллионов долларов, что значительно меньше затрат на GPT-4. Артём Санакоев, ИИ-исследователь в Meta Generative AI и автор канала "эйай ньюз", выделил инновационный подход Anthropic к рассуждениям модели — в отличие от конкурентов, Claude использует единую модель без отдельного reasoning тюна.


#AI #ML #LLM
  • 🔥 4
  • 🫡 2
  • 👍 1
Post #111 60
Задание на закрепление темы:

У тебя есть DataFrame с данными о заказах в интернет-магазине:
import pandas as pd

data = pd.DataFrame({
'order_id': [1, 2, 3, 4],
'item': ['phone', 'laptop', 'headphones', 'tablet'],
'price': [500, 1200, 80, 300],
'quantity': [2, 1, 5, 3],
'shipping_cost': [10, 20, 5, 15]
})
print(data)

Результат: Картинка 1

Задачи:
1️⃣ Создай колонку total_item_cost — общая стоимость товаров в заказе без доставки (price * quantity). Какой axis нужен?
2️⃣ Создай колонку total_order_cost — итоговая стоимость заказа с учётом доставки (total_item_cost + shipping_cost). Какой axis нужен?
3️⃣ Создай колонку price_level:
Если price > 1000, то "premium".
Если 100 <= price <= 1000, то "standard".
Если price < 100, то "budget". Нужен ли тут axis?
4️⃣ Создай колонку order_size:
Если quantity >= 3, то "large".
Иначе "small". Нужен ли тут axis?
5️⃣ Создай колонку item_code — первые 3 буквы названия товара в верхнем регистре + количество (quantity). Какой axis нужен?

Попробуй написать код для всех пунктов, а я проверю и дам обратную связь! Если что-то непонятно или нужно больше подсказок, дай знать — я помогу. Удачи! 🚀
  • 🔥 2
  • 🫡 2
  • 🤔 1
  • 👀 1
Post #109 68
✨ Генерация фичей в pandas: магия lambda-функций ✨

Привет, подписчики AI in Progress! Сегодня разберём, как с помощью lambda-функций в pandas создавать новые признаки (фичи) для ваших данных. Это must-know для всех, кто занимается анализом данных или машинным обучением!

Что такое lambda❓
Это короткие анонимные функции в Python, которые можно писать прямо "на лету". В pandas они идеальны для кастомной обработки данных.
Пример:
import pandas as pd
data = pd.DataFrame({
'product': ['apple', 'banana'],
'price': [1.5, 2.0],
'quantity': [10, 15]
})

Хотим добавить колонку total_cost (цена × количество)? Легко:
data['total_cost'] = data.apply(lambda x: x['price'] * x['quantity'], axis=1)

Результат: Картинка 1

А если усложнить?
Добавим скидку: 10% если количество > 12, иначе 0%.
data['discount'] = data['quantity'].apply(lambda x: 0.1 if x > 12 else 0.0)

И итоговую стоимость:
data['final_cost'] = data.apply(lambda x: x['total_cost'] * (1 - x['discount']), axis=1)

Результат: Картинка 2

Lambda-функции позволяют:

✔️ Работать со строками (например, lambda x: x['product'][:3].upper()).
✔️ Писать сложные условия (if-elif-else).
✔️ Комбинировать столбцы на лету.

Совет:
Для простых операций используйте векторные вычисления (например, data['price'] * data['quantity']) — они быстрее. А lambda — для гибкости и сложной логики.

*Что такое axis в pandas❓
axis — это параметр, который указывает, вдоль какой оси (направления) в таблице (DataFrame) применять операцию. В pandas данные организованы в виде таблицы с двумя измерениями:

📌Строки (rows) — это горизонтальные линии данных.
📌Столбцы (columns) — это вертикальные колонки с признаками.
Параметр axis говорит pandas, работать ли со строками или со
столбцами:

axis=0 — операция идёт вдоль строк (по вертикали, вниз по столбцу). Это значение по умолчанию.
axis=1 — операция идёт вдоль столбцов (по горизонтали, по строке).


#AI #DataScience #Python #Pandas #MachineLearning #FeatureEngineering #Coding #АнализДанных
  • 🔥 3
  • 👍 2
  • 🤩 1
Post #108 62
🧠 ИИ на марше: новости 10 марта 2025

Мир искусственного интеллекта не спит, и вот что творится на 10.03.2025:

1️⃣ Google Gemini: видеоанализ в реальном времени
Google выкатил апдейт для Gemini — теперь он разбирает видео на лету и отвечает по контенту. Пример: показал кадр с выставки, а ИИ выдал, кто дизайнер стула на фоне. Скоро ждём бета-тест для разработчиков.

2️⃣ OpenAI: Sora врывается в ChatGPT
OpenAI скрестила ChatGPT с видеогенератором Sora. Результат? Текстовая команда → видео на выходе. Качество пока не голливудское, но прогресс налицо. Релиз в апреле — следим за API.

3️⃣ Маск: "ИИ перегонит нас к зиме"
Илон в своём репертуаре: заявил, что к декабрю 2025 ИИ превзойдёт человеческий интеллект. xAI, по слухам, уже тестирует что-то "запредельное". А Starlink всё ещё держит связь с Украиной — Маск не сдаётся.

4️⃣ DeepSeek из Китая рвёт шаблоны
Китайский DeepSeek снова в заголовках: его производительность уже сравнивают с топ-моделями США. Пекин ускоряет темпы, и аналитики гадают — чья нейросеть будет диктовать правила в 2026?

⚙️ Прогресс в деле
ИИ всё глубже проникает в код, видео и прогнозы. Что дальше — автономные системы или просто умные игрушки? Делитесь мыслями в комментах!

#AI #ИИ #Технологии
  • 🔥 3
  • ❤ 1
  • 👍 1
  • 😁 1
  • 🫡 1
Post #107 63
🔥 Pandas: Группировка и Агрегация Данных

Если ты работаешь с таблицами в Pandas, то группировка groupby() и агрегирующие функции – твои лучшие друзья. Разбираем, что это такое и как запомнить!

🔷 Как это работает?
Когда у тебя есть большой DataFrame, ты можешь сгруппировать его по какому-то признаку и посчитать нужные показатели.

Формула:
df.groupby('ПО ЧЕМУ ГРУППИРУЕМ')['ЧТО СЧИТАЕМ'].ЧТО ДЕЛАЕМ()


🔹 Разбираем каждый элемент:
✅Группируемый столбец – тот, по которому делим данные на группы.
📌 Например: 'Категория', 'Город', 'Компания', 'Год' и т. д.

✅Целевой столбец – тот, по которому считаем агрегаты.
📌 Например: 'Цена', 'Количество', 'Доход', 'Возраст' и т. д.

✅ Агрегирующая функция – что мы считаем:
- sum() – сумма
- mean() – среднее
- min() – минимум
- max() – максимум
- count() – количество


🔷 Примеры 🔥

1️⃣ Считаем сумму цены товаров в каждой категории
df.groupby('Категория')['Цена'].sum()

Вывод:
Категория
Овощи 70
Фрукты 150

✅ Группа "Овощи" = 30 + 40 = 70
✅ Группа "Фрукты" = 100 + 50 = 150

2️⃣ Средняя цена товаров по категориям
df.groupby('Категория')['Цена'].mean()

Вывод:
Категория
Овощи 35.0
Фрукты 75.0

✅ Средняя цена фруктов = (100 + 50) / 2 = 75

#pandas #python #dataanalysis #groupby #разбор
  • 🔥 5
  • 🌭 2
  • 💯 1
Post #106 62
📊 Как форматировать оси X и Y в Matplotlib?
Если ты работаешь с графиками в Python, то наверняка сталкивался с некрасивыми подписями на осях – слишком много знаков после запятой или неудобные числа. 📉

Сегодня разберем FormatStrFormatter – простой инструмент, который помогает красиво оформлять числа на осях!

📌 Что такое FormatStrFormatter?
Это специальный класс в matplotlib.ticker, который позволяет форматировать подписи осей (X и Y) с помощью строковых шаблонов.

✅ Можно ограничить количество знаков после запятой
✅ Можно добавить символы (%, $, °C и т. д.)
✅Можно перевести числа в научную нотацию

💡 Пример использования:
# 📌 Импортируем библиотеки
import matplotlib.pyplot as plt # Графики
import numpy as np # Математика
from matplotlib.ticker import FormatStrFormatter # Формат подписей

# 📌 Создаем данные
x = np.linspace(0, 10, 100) # 100 точек от 0 до 10
y = np.sin(x) * 10 # Синус увеличенный в 10 раз

# 📌 Создаем график
fig, ax = plt.subplots()
ax.plot(x, y, label="Синус волна") # Линия на графике

# 📌 Форматируем оси X и Y
ax.xaxis.set_major_formatter(FormatStrFormatter('%.1f')) # X с 1 знаком после запятой
ax.yaxis.set_major_formatter(FormatStrFormatter('%.2f')) # Y с 2 знаками после запятой

# 📌 Добавляем подписи и заголовок
ax.set_xlabel("Ось X (1 знак после запятой)")
ax.set_ylabel("Ось Y (2 знака после запятой)")
ax.set_title("📊 График с форматированными осями")

# 📌 Показываем график
plt.legend()
plt.show()


📖 Разбираем код по шагам
1️⃣ Генерируем данные
x = np.linspace(0, 10, 100)  # 100 точек от 0 до 10
y = np.sin(x) * 10 # Считаем синус и увеличиваем масштаб

🔹 np.linspace(0, 10, 100) – равномерно создаем 100 точек.
🔹 np.sin(x) * 10 – вычисляем синус и увеличиваем масштаб.

2️⃣ Создаем график
fig, ax = plt.subplots()  
ax.plot(x, y, label="Синус волна")

🔹 fig, ax = plt.subplots() – создаем область для графика.
🔹 ax.plot(x, y, label="Синус волна") – строим линию.

3️⃣ Форматируем подписи осей X и Y
ax.xaxis.set_major_formatter(FormatStrFormatter('%.1f'))  # X: 1 знак после запятой
ax.yaxis.set_major_formatter(FormatStrFormatter('%.2f')) # Y: 2 знака после запятой

🔹 '%.1f' – форматирует ось X, оставляя 1 знак после запятой.
🔹 '%.2f' – форматирует ось Y, оставляя 2 знака после запятой.

4️⃣ Добавляем подписи и заголовок
ax.set_xlabel("Ось X (1 знак после запятой)")  
ax.set_ylabel("Ось Y (2 знака после запятой)")
ax.set_title(" График с форматированными осями")

📌 Чтобы график выглядел красиво и понятно, всегда добавляй подписи!

5️⃣ Отображаем график
plt.legend()  # Показываем легенду
plt.show() # Выводим график

🔹 plt.legend() – показывает подпись графика ("Синус волна").
🔹 plt.show() – отображает график.

🔧 Дополнительные форматы FormatStrFormatter
ax.xaxis.set_major_formatter(FormatStrFormatter('%d%%'))  # X в процентах
ax.yaxis.set_major_formatter(FormatStrFormatter('$%.2f')) # Y в долларах
  • 🔥 4
  • 👏 1
  • 😱 1
  • 🫡 1
Post #105 58
🚀Эволюционное и метагенетическое программирование: что это и как они работают?

В мире технологий и оптимизации появляются все более сложные задачи, которые традиционные методы не всегда могут решить. Одним из таких решений являются эволюционное и метагенетическое программирование — подходы, вдохновленные процессами биологической эволюции. Давайте разберёмся, как они работают и где могут быть полезны.

💡Эволюционное программирование
Эволюционное программирование (ЭП) — это метод, в котором компьютеры ищут лучшие решения, подражая процессам, происходящим в природе. Представьте, что у нас есть несколько "решений" какой-то задачи, как в биологической популяции. Эти решения развиваются через три основных шага:
1. Отбор: Выбираются лучшие решения.
2. Мутация: Случайным образом меняются элементы решения для улучшения.
3. Заменяем: Новые решения, которые оказались более эффективными, заменяют старые.


Пример 1: Оптимизация маршрутов доставки товаров. Компания, которая доставляет товары по городу, использует эволюционное программирование, чтобы найти лучший маршрут. Каждый маршрут — это решение, которое может быть улучшено с помощью мутаций (например, изменение порядка остановок или добавление другого пути). Со временем система "выбирает" самый быстрый и экономичный маршрут.

Пример 2:
Настройка гиперпараметров для нейронной сети. В машинном обучении важно правильно настроить параметры модели, такие как скорость обучения или количество слоёв. ЭП помогает найти оптимальные гиперпараметры, изменяя их случайным образом и выбирая наиболее эффективные из них.

Метагенетическое программирование
Метагенетическое программирование (МГП) — более сложный подход, где сама программа может изменять свой алгоритм для поиска решений. Это позволяет создавать более гибкие и адаптивные системы. В отличие от ЭП, где мы изменяем только решение, в МГП меняется сам процесс поиска.
1. Создание программы: Генерация нескольких алгоритмов для поиска решения.
2. Эволюция алгоритмов: Программы изменяются и улучшаются в процессе работы.
3. Использование алгоритмов: На основе изменений алгоритмов выбирается наилучший для решения задачи.


Пример 1: Рекомендательные системы в интернет-магазине. В интернет-магазине необходимо предсказать, какие товары заинтересуют каждого клиента. МГП позволяет системе рекомендаций адаптироваться к изменяющимся интересам пользователей. Алгоритмы, учитывающие покупки и поведение пользователей, изменяются в реальном времени, чтобы всегда предлагать актуальные товары.

Пример 2: Генерация адаптивных стратегий для ботов в играх. В играх боты должны адаптироваться к действиям игрока. МГП позволяет ботам менять свои стратегии, например, если они замечают, что атакующая тактика неэффективна, они могут переключиться на более осторожную. Таким образом, боты становятся умнее и игра становится интересней.

Основные различия:
* Сложность: Эволюционное программирование проще и используется для оптимизации решений, в то время как метагенетическое программирование сложнее, так как оно изменяет сами алгоритмы.
* Применение: ЭП идеально подходит для задач, где нужно найти лучшее решение среди множества вариантов (например, оптимизация маршрутов), а МГП — для создания гибких, адаптирующихся систем, которые постоянно совершенствуются (например, рекомендательные системы или игры).

Эти методы открывают новые горизонты в разработке умных систем и оптимизации процессов. В условиях, когда мир меняется быстрее, чем когда-либо, умение адаптироваться и оптимизировать процессы становится всё более важным. Эволюционное и метагенетическое программирование — это мощные инструменты, которые помогают не только решать текущие задачи, но и создавать системы, способные эволюционировать вместе с изменяющимся миром.

#ЭволюционноеПрограммирование #МетагенетическоеПрограммирование #ИИ
  • 🔥 6
  • 👍 2
  • 🫡 1
Post #104 51
OpusClip ReframeAnything — превращает длинные видео в готовый контент для соцсетей

Нейросеть сама вырезает из роликов самые важные моменты и собирает из них короткие клипы для публикации.

Больше не нужны монтажные навыки — загружаешь видео, и через пару минут получаешь готовый результат, оптимизированный под соцсети.

Пробуем тут
  • 👏 4
  • 👍 1
Post #100 45
🤔Что такое Matplotlib?
Matplotlib — это мощная библиотека для визуализации данных, позволяющая создавать как статичные графики, так и анимации и интерактивные визуальные представления. Основная идея — разделение на фигуры (целые окна или страницы) и оси (отдельные графики), что позволяет комбинировать несколько визуальных элементов в одном окне.

Основные возможности
📊Разнообразие графиков:
* Линейные графики: для отображения трендов (например, изменения синусоиды со временем).
* Точечные диаграммы (scatter plots): для изучения взаимосвязей между переменными.
* Гистограммы: для анализа распределения данных.
Тепловые карты (heatmaps): для выявления паттернов в двумерных данных.


💡Анимация и интерактивность:
Помимо статичных изображений, Matplotlib позволяет создавать анимированные графики с помощью модуля animation и интерактивные визуализации, особенно если использовать его вместе с инструментами вроде ipywidgets.

📇Гибкость настройки:
Ты можешь детально настраивать цвета, подписи, легенды и многое другое, чтобы визуализация точно передавала нужное сообщение.

🔍Зачем нужна визуализация данных?
Визуализация — это ключ к пониманию сложных наборов данных. Она помогает:
- Обнаруживать закономерности и аномалии: график может быстро показать тренды и выбросы.
- Коммуницировать инсайты: хорошо продуманный график облегчает донесение результатов исследований до аудитории.
- Принимать решения: визуальное представление данных служит отличной базой для обоснованных решений в бизнесе и науке.

🤔Мне кажется, что будущее за умением не только анализировать данные, но и делиться результатами в понятном и привлекательном формате. Matplotlib является основой для этого, а с его помощью можно создавать невероятно качественные визуальные истории.

🚀Заключение
Визуализация — это мост между сложными данными и ясным пониманием их сути. Matplotlib предоставляет все необходимые инструменты для создания красивых и информативных графиков, а его гибкость позволяет адаптировать визуализации под любые нужды. Если ты хочешь создавать не просто графики, а настоящие визуальные истории, обязательно дай шанс Matplotlib!

#Python#Matplotlib#DataVisualization#DataScience#Аналитика
  • 👍 4
  • 🔥 2
  • 🫡 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →