Привет, коллеги!
Когда я провожу исследования образовательных продуктов, я обычно спрашиваю про предыдущий опыт обучения, что понравилось, что не очень. Захотелось рассказать про свой. Последний курс, который я проходила, — это курс «Статистика, R и анализ данных» от Blastim.
Я раньше уже писала, что это была моя четвёртая попытка освоить R, и в этот раз я продвинулась намного дальше. Мне говорили: зачем вообще нужен курс и изучение какого-то языка, если сейчас всё могут сделать нейросети. Нейросети-то могут, но без знаний я вообще не управляю процессом, и на выходе получается хз что. Честно скажу, я сейчас пишу код на пару с Клодом, но смотрю на результат и вижу, когда он сделал что-то не то. Читаю код и понимаю, где именно закралась проблема, и могу вручную или точечным указанием какие-то вещи поправить. В общем, я не считаю, что без хотя бы базовых знаний получится хорошо вайбкодить на R.
Что касается самого курса. Могу сказать, что мне хорошо подошёл формат: это синхронные занятия, во время которых нужно что-то делать и выполнять задания. Точно говорю, что в записи или по учебнику хрена с два у меня что-то получилось бы. Отложила бы на последний момент, ничего бы не поняла и сожалела о потраченных деньгах. Собственно, так и произошло с моими попытками изучать R самостоятельно. В целом, когда я думаю о мотивации покупать какие-то курсы, то для меня она не столько в том, чтобы получить какие-то сакральные знания, которые я нигде не найду, а в том, чтобы не собирать их самой и чтобы кто-то извне организовывал меня, а также отвечал на глупые вопросы.
Хочу ещё отметить работу преподавателя. В основном занятия вёл Иван Поздняков, другие преподаватели больше сопровождали в плане вопросов в чате; вебинаров с ними было мало, и они были скорее теоретические и демонстрационные, чем практические. Сам темп в целом был хороший, сложность шла по нарастающей, и была возможность плавно вкатиться, хотя под конец лично мне стало сложновато, и я сидела и ругалась на код, который не работает, а преподаватели в поддержке не всегда могли помочь из-за отсутствия контекста.
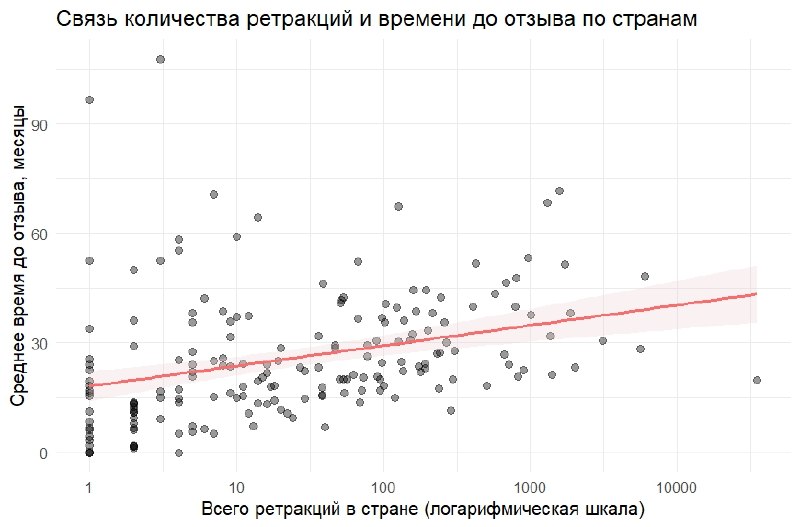
Курс хорошо подойдёт тем, кто уже как-то пытался анализировать свои данные — хоть в Excel, хоть в Prism, хоть где. И туда неплохо бы даже идти со своим датасетом, но в целом есть готовые, даже с вопросами для исследования. Но лично я баловалась с данными по отзывам статей с Retraction Watch. Нашла чувака с самым большим количеством ретракций (236, Карл!), но оказалось, что про него есть статья в Википедии. В фото к этому посту делюсь графиками, которые я построила на курсе. Да, знаю, что для большинства из них нужно общее количество публикаций в этот год или в этой стране, но я не нашла времени заморочиться настолько. Здесь только то, что я построила в рамках занятий. Но честно скажу, что я надеялась в конце сделать модель, которая по вводным типа страна, тип статьи, количество авторов и т.д. считает вероятность того, что статья может быть отозвана, но до таких вещей на курсе мы не добрались. Возможно, я бы предложила вместо занятия по вайбкодингу сделать дополнительное занятие с разбором более сложных моделей.
Несмотря на то, что моя работа сейчас напрямую не связана с постоянным анализом данных в R (хотя я всё равно нет-нет, да и пользуюсь им), мне было очень полезно получить такой навык. Одно из лучших вложений в своё образование. Ну а если и вы давно думали разобраться со статистикой, то тут как раз стартует новый поток. Цена курса может быть кусачей для учёных с зарплатой на уровне МРОТ, но на мой взгляд она более чем оправдана для такого насыщенного в плане полученных навыков курса. Есть рассрочка, скидки, а самое главное — грант на покрытие полной стоимости обучения. Так что в целом, если есть желание — есть и возможность его воплотить.
Post #2330
2.45K


- ❤ 32
- 👍 14
- 🔥 10