TGViewer
Channel Public Channel
ZVLB. Tech

ZVLB. Tech

@zvlbtech

Kubernetes изнутри и эксплуатация под нагрузкой.
Новости, разборы и находки из практики больших кластеров. Без воды и пересказа доков.

Сайт: zvlb.github.io
Subscribers
181
Photos
11
Videos
0
Links
100
Recent Posts 15 shown
Post #130 190
Если у вас в кластере много объектов - дефолтные --kube-api-qps/--kube-api-burst у kube-controller-manager однажды могут вас укусить. Вот как это выглядело у нас: тихий инцидент, без отказа сервисов, но поучительно.

Симптом: завершённые поды перестали убираться. Число объектов-подов в etcd поползло вверх - с ~30 700 до ~33 500. Ноды здоровы, пользователи ничего не заметили. Ломается не «под не создаётся», а «под не удаляется» - значит смотрим не на scheduler, а на garbage collector внутри kube-controller-manager.

Что случилось: около 19:35 переехал лидер kube-controller-manager. И у нового лидера очередь GC attempt_to_delete стартовала не с нуля, а сразу с ~72 000 объектов (очередь формируется через 30 секунд после старта Garbage Collector. На самом деле объектов больше, но мначие успевают разобраться за первые 30 секунл и это происходит "незаметно"). Дальше он разгребал её строго линейно - ~20 удалений/с. Почти идеальная прямая на графике.

При этом apiserver здоров: p99 DELETE pods 0.1-0.5s, ответов 429 - ноль. Раз API не тормозит и не режет запросы - значит потолок 20/с задаёт сам клиент. А клиент тут - kube-controller-manager с его --kube-api-qps.

И вот главное. Дефолт у контроллер-менеджера - qps=20 / burst=30. Для маленького кластера норм, там очередь GC вечно у нуля и эти 20/с в глаза не бросаются. Но когда объектов десятки тысяч, любое событие, наполнившее очередь (смена лидера, всплеск удалений, рестарт kube-controller-manager), превращает эти 20/с в бутылочное горлышко. Считаем: 72000 / 20 ≈ 58 минут - ровно столько чистка и заняла.

У нас на здоровых мастерах qps был поднят до 100, а на одном - не применился конфиг, и он откатился к дефолту. Но суть не в кривом конфиге на одном узле. Суть в том, что на нагруженном кластере сама по себе дефолтная планка слишком низкая - и рано или поздно совпадёт с моментом, когда очередь большая.

Фикс - крутить строго в паре:
- --concurrent-gc-syncs: 200 - параллелизм самого GC,
- --kube-api-qps: 200 / --kube-api-burst: 300 - чтобы 200 воркеров GC не встали в очередь на клиентском лимите.

Поднимешь одно без другого - это педаль газа в пол при зажатом ручнике.

Мораль: если у вас крупный кластер - не оставляйте --kube-api-qps/--kube-api-burst на дефолтах. Они рассчитаны на маленькие инсталляции и молчат ровно до того дня, когда очередь GC вырастет. Проверьте, с какими лимитами реально запущены ваши controller-manager'ы на КАЖДОМ мастере. Не в шаблоне - в живом процессе.

Про то, как работает Garbage Collector в Kubernetes я уже рассказывал вот тут

#Kubernetes #garbage_collector #sre
Telegram ZVLB. Tech Вырезка с внутреннего митапчика, где я очень тихо рассказываю про Kuberentes Garbage Collector https://www.youtube.com/watch?v=1rHMrBCCOpk #zvlb_video #Kubernetes #garbage_collector
  • ❤ 5
  • 👍 1
  • 🔥 1
Post #129 2.23K
Наткнулся на очередную статью: «Zero-Downtime Deployments with Docker Compose — No Kubernetes Required». Автор прямо пишет - в индустрии, мол, массовое заблуждение, что для серьёзного прода нужен k8s. Не нужен. Тысячи проверок в минуту, мульти-регион, деплой по нескольку раз в день - и всё на компоузе.
И тут он прав. Для одного хоста и пары сервисов Kubernetes - это из пушки по воробьям. Бесшовно перекатить контейнер умеет и nginx, никакой оркестратор для этого не нужен.

Только это подмена тезиса. В k8s идут не за zero-downtime деплоем - за ним и так все умеют. Идут за другим.
Первое - пул машин. Compose заперт в пределах одного хоста. В комментах это сразу и поймали: «тысячи проверок в минуту - это вообще немного, спокойно живёт на одной железке. Kubernetes берут, когда надо выйти за её пределы». Вот и весь спор.

Второе - стандарт. k3s ставится за пять минут, и ты получаешь готовую вселенную типового тулинга. Новый человек приходит с любого облака и сразу в теме. А не разбирает полгода твой самодельный оркестратор из bash'а и скотча.

Лучший коммент в треде - вообще не про технику. Человек честно признался: «взяли инструмент попроще, проект взлетел - и все эти "сложные" фичи k8s внезапно стали нужны. Зря не взяли сразу». Знакомо до боли.

Короче. «Не нужен Kubernetes» - честный заголовок. Просто допишите в конце: «пока у тебя один хост». А на втором десятке нод поговорим заново.

#kubernetes #docker #devops
StatusDude Zero-Downtime Deployments with Docker Compose — No Kubernetes Required | StatusDude We tried Traefik for zero-downtime deploys. It dropped requests, returned 404s, and couldn't retry on a different backend. HAProxy fixed everything in 60 lines of config.
  • 👍 6
  • ❤ 1
  • 👏 1
  • 😁 1
Post #128 257
Четыре безобидные по отдельности вещи:
- reload nginx,
- долгоживущие websocket'ы,
- aio-threads,
- заниженный kernel.threads-max.
Порознь ерунда. Вместе - двухчасовой инцидент на проде.

Всё началось с того, что виртуалку когда-то создали маленькой, а потом расширили. Память приехала, а лимит потоков ядра так и остался с тех времён - и однажды это выстрелило в колено всему кластеру.

Рестарт подов лечил за минуту, но жить в режиме "когда-нибудь рванёт снова" - не вариант. Разобрал всю цепочку на Хабре.

#kubernetes #nginx #devops #sre
  • 🔥 9
  • ❤ 3
  • 👍 1
Post #127 310
Cвежий опрос Checkmarx:
- 70% разработчиков считают, что AI-код дырявее написанного руками,
- 30% сознательно катят уязвимое в прод.
- Там где AI пишет почти весь код - уязвимое улетает в прод в 3-4 раза чаще.

Правда, Checkmarx сам продаёт AppSec-сканеры - пугать ему по работе положено. Цифры берём с поправкой. 🤡

Однако пахнет правдой. Я сам подсел на AI-кодинг, наклепал два с половиной "продукта". Один нахер никому не нужен (бывает). Второй использую каждый день для управления командой. Оба перед этим прогнал на безопасность Opus'ом, разными скиллами. Косяки были, поправил.
А потом за них руками взялся отдел ИБ... Дырки нашлись моментально.

Хотелось бы закончить душной моралью "AI хороший, просто за ним надо подтирать". Но честная мораль другая.
Когда продукт делается по щелчку пальца - на безопасность становится плевать всем. Гиганты клепают продукт за продуктом и сами гонят их на AI. Не делаешь так же - отстал от рынка и стал неконкурентоспособен.

И вот весы: успеть в рынок или сделать безопасно, но поздно. Риск-оценка почти всегда перевешивает в сторону скорости. Вывод неуютный - в нынешнем мире безопасность по факту нахер никому не нужна.

Единственный реальный выход - делать её (безопасность) быстрой и автоматической. Но это чертовски сложно и дорого.

#ai #security #devops
theregister Devs know AI code is riddled with holes, but ship it anyway Pressure to deploy wins out over security as four in five orgs confess to breaches from vulnerable apps
  • ❤ 3
  • 🔥 3
  • 👍 2
  • 💯 1
Post #125 715
Kubernetes Gateway API - новый стандарт обработки трафика в Kubernetes. (Замена Ingress в том числе).

Недавно появился очень наглядный Benchmark имплементаторов Gateway API
https://github.com/howardjohn/gateway-api-bench

Очень советую к изучению! Сам в продакшн среде использую Envoy Gateway. (Хотя и не замечал ошибок, про которые говорится в тестах)
GitHub GitHub - howardjohn/gateway-api-bench: Gateway API Benchmarks provides a common set of tests to evaluate a Gateway API implementation. Gateway API Benchmarks provides a common set of tests to evaluate a Gateway API implementation. - howardjohn/gateway-api-bench
  • 👍 6
  • ❤ 1
Post #124 8.15K
3 часа назад в Kaniko прилетел последний коммит, который оповестил о похоронах продукта.

🧊 This project is archived and no longer developed or maintained. 🧊


Теперь только ансекьюрный dind.

Может у кого есть подходы, как запускать билды в контейнерах без привелегий? Я давно этим не занимался, даже интересно
GitHub Add archive notice to README (#3502) · GoogleContainerTools/kaniko@236ba56 Build Container Images In Kubernetes. Contribute to GoogleContainerTools/kaniko development by creating an account on GitHub.
  • 😭 5
  • ❤ 2
  • 🫡 1
Post #123 822
main.go3.3 KB
А вы это... Скорее всего... Неправильно считаете утилизацию ресурсов в ваших кластерах Kuberentes и даже не подозреваете об этом. (Ну я не подозревал, хотя, скорее всего, просто не задумывался)

В чём проблема?
Когда у init-контейнеров указаны requests больше, чем у основных контейнеров в поде:
1️⃣ Распределение ресурсов в кластере работает некорректно.
2️⃣ Grafana врёт на графиках утилизации, игнорируя «прожорливые» init-контейнеры.

Представьте, что вас есть pod, у которого для initContainer'a в requests указано:
    resources:
requests:
cpu: 100m
memory: 500Mi


А для обычного Container'a что-то типа:
    resources:
requests:
cpu: 20m
memory: 50Mi


Получается для планирования контейнеров pod'a на ноды будут учитываться максимальные реквесты (реквесты initContainer'a) и эти же ресурсы будут "зажаты" pod'ом и Kubernetes Shceduler будет считать, что эти ресурсы недоступны для планирования) Хотя по факту основной контейнер не использует столько ресурсов)

Так же Metrics Server при сборе информации о потреблении, лимитов и реквестов ресурсов не учитывает, что указано в initContainer. То есть для такого pod'а kubelet "зажал" 100m и 500Mi, однако в метриках эти ресурсы будут считаться свободными)))

(Почитать про это можно тут)

Вы можете объективно заявить: "Какой дурак будет делать такие ресурсы для InitContainer'a". А я отвечу: "Да кто угодно, бл*ть". Вот например RabbitMQ оператор этим грешит. (Хотя ребята норм уже одобрили MR, чтобы пофиксить проблему)

P.S. В приложенных файлах небольшой Go-скриптец, который пробежится по всему Kubernetes кластеру, который у вас подключен в Kube Context, и подсветит все pod'ы, у которых initContainer реквестит больше, чем основной контейнер. У меня в самом жирном кластере нашлось 2462 таких pod'ов
  • 🔥 8
  • 👍 4
Post #122 512
Synology, (контора, которая делает очень популярные решения на рынке хранения данных) под очень благородным предлогом:
поскольку оценка состояния жестких дисков имеет важное значение как для личного, так и для профессионального использования, это создает необходимость использовать собственные или эквивалентные диски

По факты запрешает в своих новых решениях (Synology Plus) использовать диски не своего производства (ну или производства компаний-партнеров).

Как бы понятно, что компании, которые вибирают Synology, делают это не из соображения экономии, но диски у Synology, помимо того, что безумно дорогие, так еще и нифига не надежные.

Ну такое...

https://www.hardwareluxx.de/index.php/news/hardware/festplatten/65949-synology-weitet-den-zwang-zur-eignen-oder-zertifizierten-festplatte-auf-die-plus-modelle-aus.html
Hardwareluxx Festplatten-Zwang: Synology weitet Nutzung auf Plus-Modelle aus - Hardwareluxx Festplatten-Zwang: Synology weitet Nutzung auf Plus-Modelle aus.
  • 👍 1
  • 🔥 1
Post #121 461
В последнее время вообще нет времени и идей что сюда писать)

Как же хорошо, что есть другие люди, которые исследуют крутые штуки и пишут интересные статьи в этом вашем интернете.

Вот очень интересный разбор на тему: "Почему лимиты на CPU - это от лукавого и, возможно, уже стреляет вам в колено в ваших кластерах"

https://medium.com/@alexandru.lazarev/cpu-limits-in-kubernetes-why-your-pod-is-idle-but-still-throttled-a-deep-dive-into-what-really-136c0cdd62ff
Medium CPU Limits in Kubernetes: Why Your Pod is Idle but Still Throttled: A Deep Dive into What Really… Intro to intro — spoiler: Some time ago I did a big research on this topic and prepared 100+ slides presentation to share knowledge with…
Post #120 494
Если вам вдруг нужен аргумент на тему: "Почему не стоит использовать Kubespray для раскатки Kubernetes, а тем более компонентов внутри Kubernetes" ловите еще один, который меня выбесил сегодня.

Вводные:
- Кластер обновлен последней версией Kubespray (v2.27.0) и до последней поддерживаемой версии Kuberentes (v1.31.4)

Задача:
- Зашарить по BGP все Service с типом LoadBalancer

Ну... Все просто. Но... Как говорил комиссар Жильбер: "Мы в дерьме" 💩

Короче главная проблема в том, что в Kubespray последняя поддерживаемая версия Cilium - это v.1.15.9, а в версии v1.16.0 разработчики cilium полностью переработали подход к BGP-конфигам и делать на старой версии - ну такое.
(Они даже минорные версии не обновляют. Актуалочка для 1.15 сейчас - это v1.15.15)

Причина почему так - они решили полностью пересмотреть сценарий раскатки Cilium'a. И, видимо, пока "пересматривают" сценарий - можно не бамбить уже существующий. Ведь он скоро станет не актуальным...

(Кстати идея не катить Cilium манифестами, а использовать Cilium CLI - здравая)

Вернемся к нашим баранам. Надо обновить Cilium. Все просто.

Берем и в нашем group_vars обновляем версию cilium'a до желаемой - v1.16.7, но хуй. Не будет это работать.

Проблема в том, что ClusterRole Cilium-Operator тупо не подготовлена, чтобы нормально пережевывать новые CRD, которые нужны для настройки BGP.

Вот вроде один из основных аргументов, почему KubeSpray это хорошо состоит в том, что им пользуется огромное комьюнити и он готов к супер различным сценариям использования, но как только ты отходишь чуть-чуть влево-вправо - идешь нафиг и появляется необходимость делать MR'ы в KubeSpray и ждать релиза с твоими изменениями месяцами, т.к. катить Kubernetes с main-ветки - нуууууу... С вероятностью 90% - что-то не заведется...

#zvlb_musle #Kubernetes #KubeSpray
GitHub GitHub - kubernetes-sigs/kubespray at v2.27.0 Deploy a Production Ready Kubernetes Cluster. Contribute to kubernetes-sigs/kubespray development by creating an account on GitHub.
  • 👍 3
  • 😁 2
  • 💯 2
  • 🔥 1
Post #114 1.06K
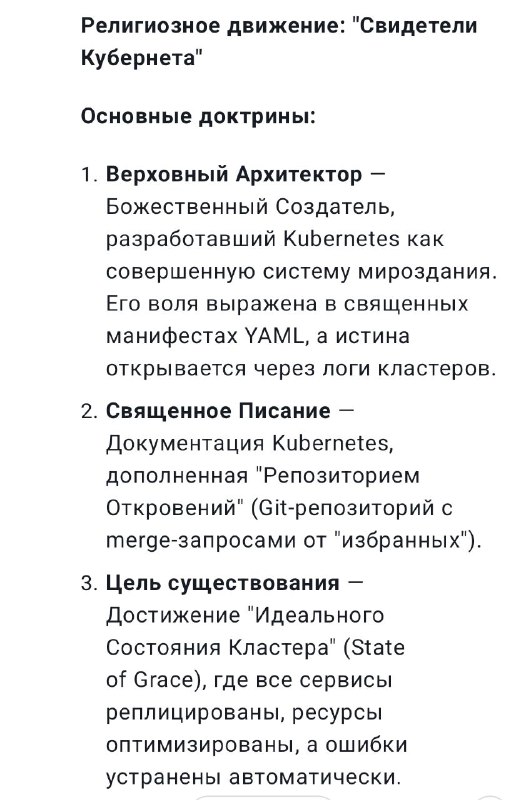
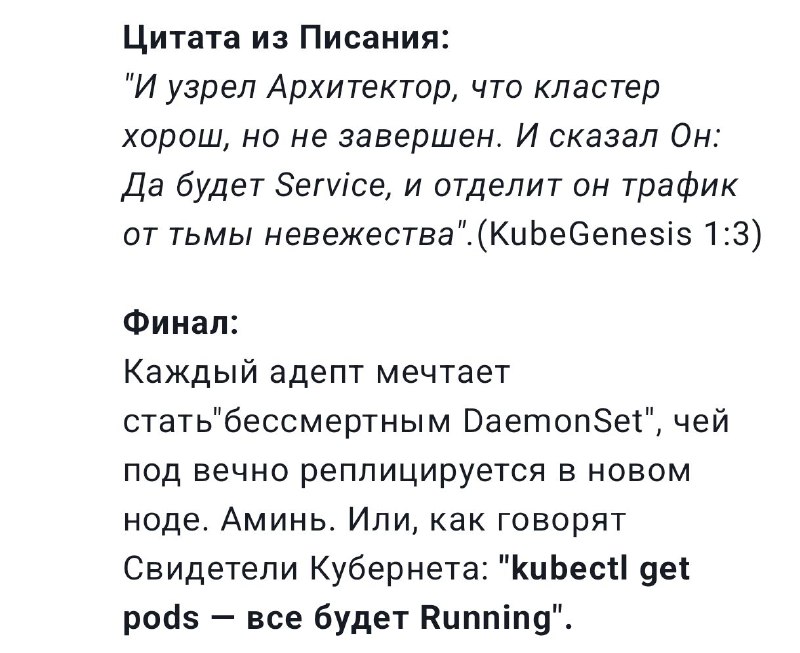
Попросил DeepSeak придумать религию по типу Свидетелей Иеговы, но основанную на технологии Kubernetes.

Получилось... Идеально)
  • 😁 11
  • 🔥 2
Post #113 488
Flant выложил в OpenSource свой Prom++
На прошлой неделе Flant открыл исходный код своей внутренней разработки — Prom++ (GitHub). Подробный разбор продукта есть на Хабре (статья).

Коротко о главном:
Prom++ позиционируется как «улучшенный Prometheus» с в 7-8 раз меньшим потреблением ресурсов

Мои мысли вслух:

1. Двойственное отношение к продуктам Flant:
С одной стороны — их решения часто топовые.
С другой — почти все их «фишки» завязаны на коммерческий продукт Deckhouse. Хотелось бы видеть больше open-source-решений, которые можно использовать независимо.

Пример: их Log Shipper — отличная штука, но без Deckhouse не работает. Пришлось делать свой Vector Operator 😅. В идеале — коллаборация сообщества и Flant, но пока их модули развиваются только «внутри» их платформы.

2. Про Prom++:
- Лицензия Apache 2.0 — пока всё открыто.
- Но... (спойлер: есть подозрение, что бесплатный сыр может оказаться в мышеловке Deckhouse 🧀. Как мы недавно наблюдали что-то похожее с Grafana On Call). Однако тут я не уверен. Через пару-тройку лет увидим.

3. Сравнение с VictoriaMetrics:
Главная «киллер-фича» VictoriaMetrics — встроенная кластеризация. Prom++ её не предлагает, а для многих проектов масштабирование важнее экономии RAM.
Личный вывод: экономия памяти в 2-3 раза — это круто, но без горизонтального масштабирования для больших инсталляций VictoriaMetrics останется фаворитом.

P.S. Всё равно попробуем задеплоить Prom++ в нашем кластере и сравнить с VictoriaMetrics.

#zvlb_musle #Prometheus #VictoriaMetrics
GitHub GitHub - deckhouse/prompp: Deckhouse Prom++ – high-performance fork of Prometheus, designed to significantly reduce memory consumption Deckhouse Prom++ – high-performance fork of Prometheus, designed to significantly reduce memory consumption - deckhouse/prompp
  • 👍 7
  • 🔥 2
Post #112 448
Cloudflare не останавливается в радостях и интересностях для IT-сообщества.

Пару дней назад в своем блоге они представини новый tool - OPKSSH.

Мы уже давно привыкли на все системы подряд заходить используя OpenID Connect (OIDC). Причем это касается как корпоративных порталов, где используется внутренний SSO, так и всяких внешних систем, где вы можете авторизоваться с помощью, например, google-почты.

В общем теперь можно настроить аутентификацию по SSH на сервера с помощью OIDC. ОГОНЬ

#it_news #ssh #oidc
Cloudflare Blog Open-sourcing OpenPubkey SSH (OPKSSH): integrating single sign-on with SSH OPKSSH (OpenPubkey SSH) is now open-sourced as part of the OpenPubkey project. This enables users and organizations to configure SSH to work with single sign-on technologies like OpenID Connect, removing the need to manually manage & configure SSH keys without…
  • 🔥 4
  • ❤ 1
  • 👍 1
Post #111 354
ZVLB. Tech У Ingress NGINX (который от сообщества Kuberenetes, а не от NGINX) вчера вышел релиз, на которой реально надо переезжать, т.к. он фиксит 5 жестких CVE, один их которых с рейтингом 9.8 (из 10. Это много. Очень) В блоге Kuberentes есть небольшая статья на…
Забавно, что F5 (компания, которая владеет NGINX) пришлось в блоге написать целую статью, что они не имеют никакого отношения к этим CVE и у них лапки :)

https://www.f5.com/company/blog/nginx/which-nginx-ingress-controllers-are-impacted-by-cve-2022-4886-cve-2023-5043-and-cve-2023-5044
F5, Inc. Which NGINX Ingress Controllers Are Impacted by CVE-2022-4886, CVE-2023-5043, and CVE-2023-5044? When new CVEs are reported, it’s easy to become confused by their applicability to a particular NGINX Ingress controller tool because there are multiple projects out there. This blog discusses the CVEs and how to distinguish between different Ingress controller…
  • 😁 5
Older posts →

About this channel

How can I read @zvlbtech without a Telegram account?
TGViewer shows the public web preview Telegram publishes for ZVLB. Tech: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does ZVLB. Tech have?
ZVLB. Tech (@zvlbtech) has 181 subscribers on Telegram, refreshed roughly every 30 minutes.
Does ZVLB. Tech know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →