
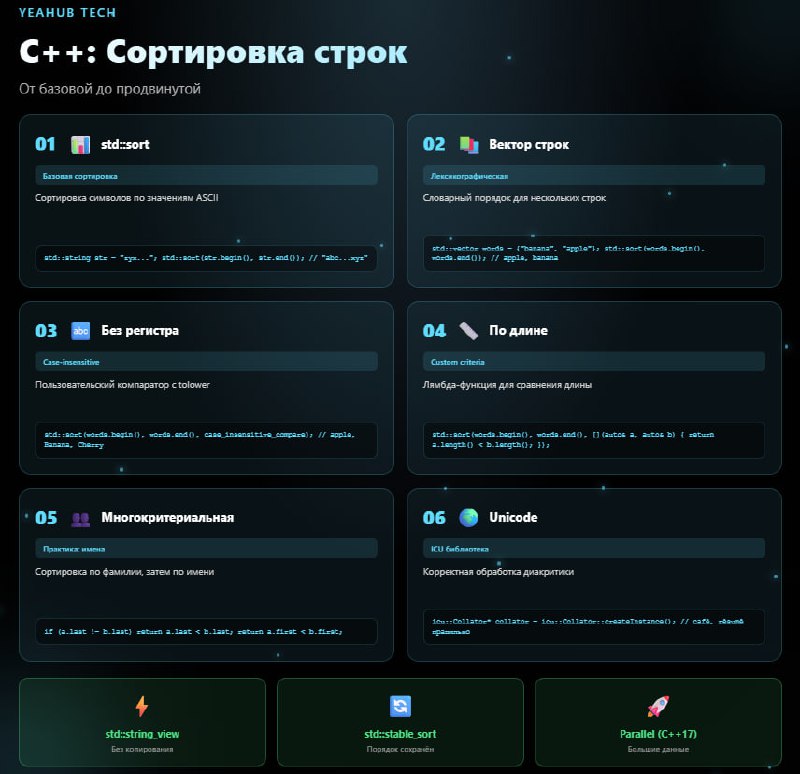
Сортировка строк — фундаментальная операция в программировании. Разбираем все методы от базовых до продвинутых.
1️⃣ Базовая сортировка: std::sort
#include <algorithm>
#include <string>

std::string str = "zycbwvutsrqponmlkjihgfedcba";
std::sort(str.begin(), str.end());
// Результат: "abcdefghijklmnopqrstuvwxyz"
Символы сортируются по значениям ASCII в порядке возрастания.
2️⃣ Сортировка вектора строк
std::vector<std::string> words = {"banana", "apple", "cherry", "date"};
std::sort(words.begin(), words.end());

// Результат:
// apple
// banana
// cherry
// date
Лексикографическая сортировка (словарный порядок).
3️⃣ Сортировка без учёта регистра
bool case_insensitive_compare(const std::string& a, const std::string& b) {
    return std::lexicographical_compare(
        a.begin(), a.end(),
        b.begin(), b.end(),
        [](char a, char b) {
            return std::tolower(a) < std::tolower(b);
        }
    );
}

std::vector<std::string> words = {"Banana", "apple", "Cherry", "date"};
std::sort(words.begin(), words.end(), case_insensitive_compare);

// Результат:
// apple
// Banana
// Cherry
// date
Пользовательский компаратор игнорирует регистр, но сохраняет исходное написание.
4️⃣ Сортировка по длине
std::vector<std::string> words = {"short", "very long string", "medium"};

std::sort(words.begin(), words.end(),
    [](const std::string& a, const std::string& b) {
        return a.length() < b.length();
    });

// Результат:
// short
// medium
// very long string
Лямбда-функция сравнивает длину строк.
5️⃣ Практика: сортировка имён
struct Name {
    std::string first;
    std::string last;
};

std::sort(names.begin(), names.end(),
    [](const Name& a, const Name& b) {
        if (a.last != b.last) {
            return a.last < b.last;
        }
        return a.first < b.first;
    });

// Входные данные:
// John Doe, Jane Doe, Alice Smith, Bob Johnson

// Результат:
// Jane Doe
// John Doe
// Bob Johnson
// Alice Smith
Многокритериальная сортировка: сначала по фамилии, затем по имени.
6️⃣ Unicode с библиотекой ICU
#include <unicode/coll.h>

bool compare_unicode(const std::string& a, const std::string& b) {
    UErrorCode status = U_ZERO_ERROR;
    icu::Collator* collator = icu::Collator::createInstance(icu::Locale(""), status);

    icu::UnicodeString ua = icu::UnicodeString::fromUTF8(a);
    icu::UnicodeString ub = icu::UnicodeString::fromUTF8(b);

    UCollationResult result = collator->compare(ua, ub, status);
    delete collator;

    return result == UCOL_LESS;
}

std::vector<std::string> words = {"café", "cafe", "résumé", "resume"};
std::sort(words.begin(), words.end(), compare_unicode);
Корректная обработка диакритических знаков.
🔸Оптимизация производительности
1. std::string_view
Избегайте копирования для строк только для чтения.
2. std::stable_sort
Сохраняет относительный порядок эквивалентных элементов.
3. Параллельная сортировка (C++17+)
Для больших наборов данных.
Бенчмарк:
100,000 строк по 10 символов:
• std::sort: 0.245 сек
• std::stable_sort: 0.298 сек
🔸Выбор метода
Простая сортировка:
→ std::sort
Без учёта регистра: → Кастомный компаратор
По длине: → Лямбда-функция
Unicode: → ICU библиотека
Сохранить порядок: → std::stable_sort
Большие данные: → Параллельная сортировка (C++17+)
Итог⬇️
Сортировка строк в C++ — от базовой лексикографической до сложной многокритериальной — позволяет эффективно обрабатывать любые задачи.
Выбирайте метод исходя из требований: регистр, Unicode, критерии, производительность.
📎 Статья
🎙 Новости
📝 База вопросов