TGViewer
Channel Public Channel
Machine Learning | YeaHub

Machine Learning | YeaHub

@yeahub_machine_learning

Теория, подготовка к интервью и курсы для ML специалистов

YeaHub — это платформа для IT-специалистов, объединяющая обучение, карьерный рост, развитие и сообщество единомышленников.

Платформа: https://yeahub.ru

Для связи: @ruslan_kuyanets
Subscribers
300
Photos
299
Videos
126
Links
533

Showing posts older than #411 · Back to latest

Older Posts 17 shown
Post #410 98
#полезное
📞 На Hugging Face вышла обзорная статья об открытых ML-датасетах

Автор новостного ресурса Daily Dose of Data Science собрал самые интересные релизы крупных датасетов и моделей. Среди них — Yambda-5B от команды Яндекса, крупнейший в мире открытый музыкальный рекомендательный датасет.

В Yambda-5B 4,79 млрд обезличенных взаимодействий: прослушивания, лайки и дизлайки треков. Датасет уже привлек внимание мировых исследователей и обещает стать важным инструментом для развития рекомендательных систем.
Подробнее

👉Новости 👉База вопросов
Post #409 100
#новости
😵‍💫 NVIDIA представила Universal Deep Research (UDR)

UDR — настраиваемый агент для глубокого ресёрча, который «оборачивается» вокруг любого LLM.

Почему это важно:
🔵**Гибкая настройка агента без кода** — UDR не ограничивает жёсткими сценариями, как большинство тулзов.
🔵Можно создавать, редактировать и комбинировать стратегии поиска и анализа.
🔵В репо есть примеры стратегий (minimal, expansive, intensive), но главная сила — в кастомизации под свои задачи.

По сути, это гибкий ресёрч-агент, который можно адаптировать под любой рабочий процесс.

Project: https://research.nvidia.com/labs/lpr/udr
Code: https://github.com/NVlabs/UniversalDeepResearch
Lab: https://nv-dler.github.io

👉Новости 👉База вопросов
Post #408 89
#Собес #postgres
🤔 Какова цель представления pg_stat_user_indexes в PostgreSQL?

💬 Кратко:
Представление pg_stat_user_indexes в PostgreSQL содержит статистическую информацию об индексах, созданных для пользовательских таблиц. Оно помогает анализировать эффективность индексов, включая их использование и количество операций. Это представление полезно для оптимизации запросов и индексации.

📌 Полный разбор + примеры использования — на платформе:
👉
Перейти к разбору

📣 Хочешь получать больше таких разборов?
Подпишись на наш главный канал
Post #406 104
#полезное
👋 Китайцы из Zhipu запустили подписку для Claude Code

В основе — собственная модель Zhipu, GLM 4.5. Работает исключительно с Claude Code, подписчикам выдаётся API ключ для эндпоинта совместимого с API Anthropic, который можно засунуть в агента от Антропик. Основной селлинг поинт — повышенные лимиты по сравнению с подпиской от Anthropic и меньше цена ($3 в месяц за Lite подписку и $15 за Pro). Вообще интересно наблюдать как, не смотря на закрытость Claude Code, всё больше провайдеров прилагают кучу усилий чтобы поддерживать именно его, а не что-то более открытое.
z.ai/subscribe

👉Новости 👉База вопросов
Post #405 95
#новости
😬 Veo 3 Ultimate

Google под шумок релиза Nano Banana тихо выкатили важное обновление. Теперь по подписке Ultra можно генерировать неограниченное количество видео на Veo 3 Fast — облегчённой версии Veo 3 (читай дистиллированной).

Раньше одна генерация могла стоить до $3.2 (при цене $0.4 за секунду на fast-модели по API), что делало создание короткометражек или рекламы довольно дорогим по сравнению с другими моделями. Теперь это стоит всего $250 в месяц.

Вероятно, многие фрилансеры и студии теперь плотно пересядут на модель от Google. Из минусов — по-прежнему нет поддержки вертикального видео и разрешение ограничено 720p, в то время как Kling уже давно генерирует в 1080p.

👉Новости 👉База вопросов
Post #404 103
#Собес #postgres
🤔 Как реализовать полнотекстовый поиск с использованием стемминга в PostgreSQL?

💬 Кратко:
Для реализации полнотекстового поиска с использованием стемминга в PostgreSQL необходимо использовать тип данных tsvector для хранения текста и функции для преобразования текста в индексированный формат. Для стемминга используется специальный словарь, который автоматически сокращает слова до их корней. Основные функции для этого: to_tsvector() И tsquery() . Также можно настроить использование словарей стемминга для различных языков.

📌 Полный разбор + примеры использования — на платформе:
👉
Перейти к разбору

📣 Хочешь получать больше таких разборов?
Подпишись на наш главный канал
Post #403 112
#новости
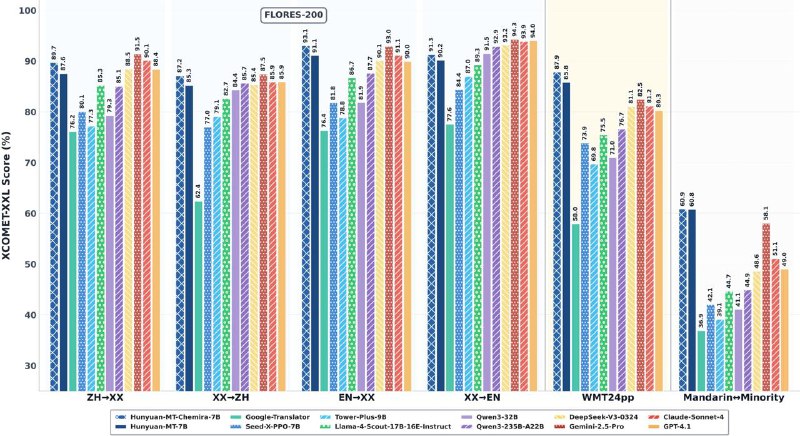
🫠 Tencent дропнули Hunyuan-MT — мощные open-source модели для перевода

Что внутри:
🔵 Доступны модели Hunyuan-MT-7B и Hunyuan-MT-Chimera-7B
🔵 Поддержка 33 языков
🔵 Chimera-7B — это первая в индустрии откртытая ансамблевая модель

Результаты:
- 1-е место в 30 из 31 категорий на международном конкурсе WMT25 (Workshop on Machine Translation 2025, крупнейшая в мире конференция-соревнование по машинному переводу)
- Hunyuan-MT-7B лидирует среди моделей своего размера

Модели: https://huggingface.co/collections/tencent/hunyuan-mt-68b42f76d473f82798882597

Репозиторий: https://github.com/Tencent-Hunyuan/Hunyuan-MT
Demo: https://hunyuan.tencent.com/modelSquare/home/list

👉Новости 👉База вопросов
Post #402 109
#полезное
🤯 Krea real-time video

Img2video? Video2video? Что это вообще?

Krea показали риалтайм-генератор, который можно конролировать, рисуя геометрические примитивы. В итоге получился real-time img2img, но с временной согласованностью и консистентностью. Выгляди так, что они учитывают предыдующие генерации для согласованности.

Эффект вышел уникальный, хоть по сути и не является video2video. Но главная фишка — это реалтайм (12 fps).

Не знаю, насколько это будет полезно на практике, но для концептуальных и/или музыкальных роликов точно подойдёт. Интересно будет поиграться.
Вейтлист

👉Новости 👉База вопросов
Post #401 109
#Собес #postgres
🤔 Как выполнить массовую вставку данных в PostgreSQL?

💬 Кратко:
Для массовой вставки данных в PostgreSQL можно использовать команду сору или выполнить вставку данных с помощью нескольких строк в одном запросе INSERT . Оба метода значительно ускоряют процесс по сравнению с вставкой данных по одной строке за раз.

📌 Полный разбор + примеры использования — на платформе:
👉
Перейти к разбору

📣 Хочешь получать больше таких разборов?
Подпишись на наш главный канал
Post #399 138
#полезное
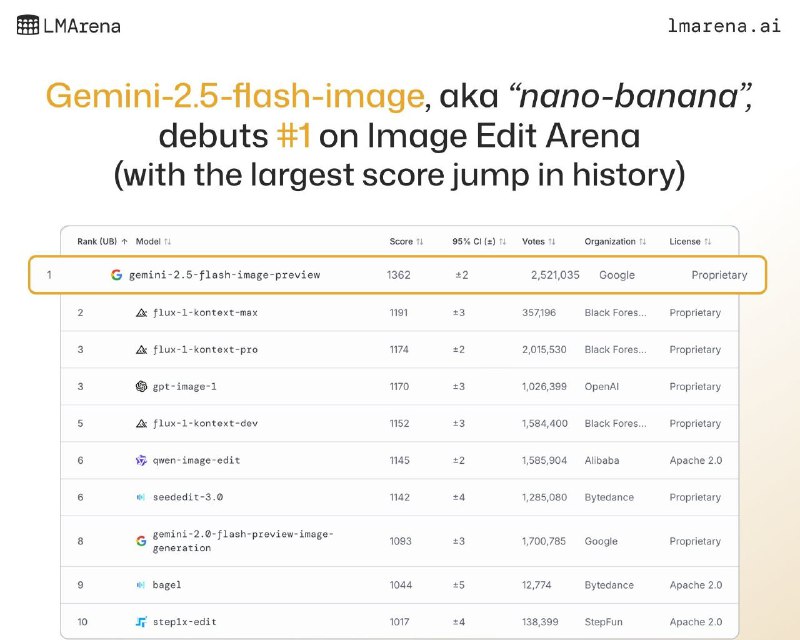
😎 Nano-banana, которая хайповала последнюю неделю в интернете оказалась Gemini-2.5-flash-image

Гугл жёстко порвал всех на задаче редактирования изображений по промпту.

Стоимость окей - 39$ за тысячу картинок. Но это не считая входных токенов, так что в итоге будет получаться немного дороже.

Для сравнения Flux.1 Context Max, который сильно проигрывает на аркне, стоит $80 за 1000 картинок.

Это либо гибридная модель, либо как-то прикрутили к диффузии текстовый энкодер в виде Gemini-flash, т.к. в блогпосте пишут, что модель знает все те концепты, которые знает Gemini.

Умеет в генерацию по референсам и редактирование. Говорят, что держит хороший character consistency.

Модель доступна в Gemini app, Google AI Studio, и в Fal ai.
Blogpost

👉Новости 👉База вопросов
  • ❤ 1
Post #398 164
#Собес #postgres
🤔 Как реализовать логическую декодировку в PostgreSQL?

💬 Кратко:
Логическая декодировка в PostgreSQL позволяет отслеживать изменения в базе данных (insert, update, delete) и передавать их внешним системам. Для этого необходимо использовать механизм потокового репликации, создавая логические репликационные слоты и подписки. Это позволяет применять технологию Change Data Capture (CDC) для интеграции с другими системами.

📌 Полный разбор + примеры использования — на платформе:
👉
Перейти к разбору

📣 Хочешь получать больше таких разборов?
Подпишись на наш главный канал
  • ❤ 1
Post #397 165
#новости
👋 Во Флориде школы начнут тестировать дроны с перцовым газом для борьбы со стрелками.

Три округа во Флориде готовятся к испытаниям системы беспилотников, предназначенной для нейтрализации нападающих. Дроны, разработанные компанией Campus Guardian Angel, могут быть активированы в течение 5 секунд после сигнала тревоги и достигнуть стрелка за 15 сек.

Они оснащены шариками с перцовым спреем, чтобы ослепить или замедлить преступника, могут разбивать окна для отвлечения внимания и транслировать видео в реальном времени для правоохранителей.

По словам CEO компании, если это не поможет, дроны будут «продолжать таранить» нападающего до прибытия полиции.

Проект уже вызвал серьезные этические вопросы, касающиеся безопасности, но штат выделил на пилотный проект 557 тыс. долларов. Установка систем в школах запланирована на осень, а полноценный запуск — на январь.

👉Новости 👉База вопросов
  • ❤ 2
Post #396 163
#новости
❤️‍🔥 Анонсирован Flash Attention 4

Прирост по сравнению со стандартной имплементацией из cuDNN доходит до 22% на Blackwell (SM100). Интересная особенность — Flash Attention 4 написан на Python с использованием CuTe DSL.

Две основные оптимизации — эмуляция экспоненты через софт (нативная экспонента в железе слишком медленная) и новый алгоритм online softmax, который на 90% меньше рескейлит аутпут, за счёт чего и быстрее. Пока что есть только forward pass, так что потренировать с FA4 не выйдет
Кернел

👉Новости 👉База вопросов
  • ❤ 1
Post #395 142
#полезное
🤯 Оказалось Codex CLI теперь включён в подписку ChatGPT

Codex CLI теперь доступен подписчикам ChatGPT Plus, Pro и Team. Ранее в подписке была доступна лишь веб версия, которая сильно проигрывала по юзабельности и качеству кода чуть ли не всем конкурентам. Лимиты сбрасываются каждые пять часов и есть общий лимит, который сбрасывается раз в неделю. В туле доступна GPT-5 и можно регулировать уровень ризонинга. Уровень Codex как CLI инструмента не дотягивает до Claude Code, но, судя по отзывам, качество работы которую делает Codex — лучше.

npm install -g @openai/codex
codex
codex -m gpt-5 -c model_reasoning_effort="high"


👉Новости 👉База вопросов
  • ❤ 1
Post #394 154
#Собес #mongoDB
🤔 Что такое первичный ключ в MongoDB?

Первичный ключ в MongoDB - это уникальный идентификатор для каждого документа в коллекции. MongoDB автоматически создает поле _id как первичный ключ, которое может использоваться для быстрого поиска документов.

👉Новости 👉Платформа
  • ❤ 1
Post #392 177
#полезное
🛞Фей-Фей Ли хвастается world model своего стартапа — World Labs

Для генерации всего мира понадобилась всего лишь одна картинка, причём по видео видно что консистентность на высоте — модель не забывает детали локации как только пользователь отвернулся. Ну и длина генерации не ограничена.

Все потому что это не традиционная генерация, основанная на видео диффузии, а на гаусовских сплатах

👉Новости 👉База вопросов
  • ❤ 1
  • 👍 1
Post #389 181
#полезное
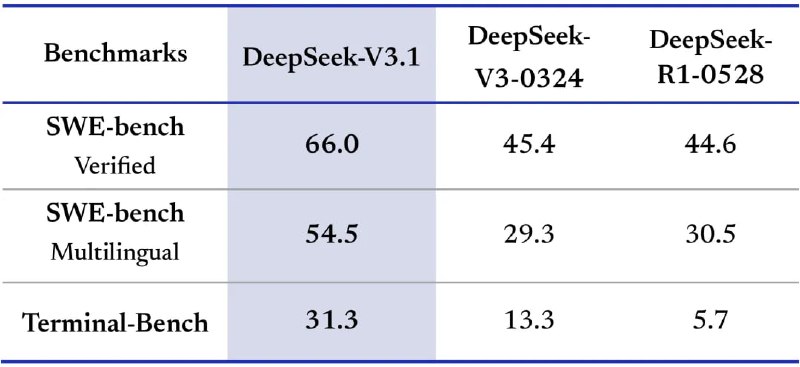
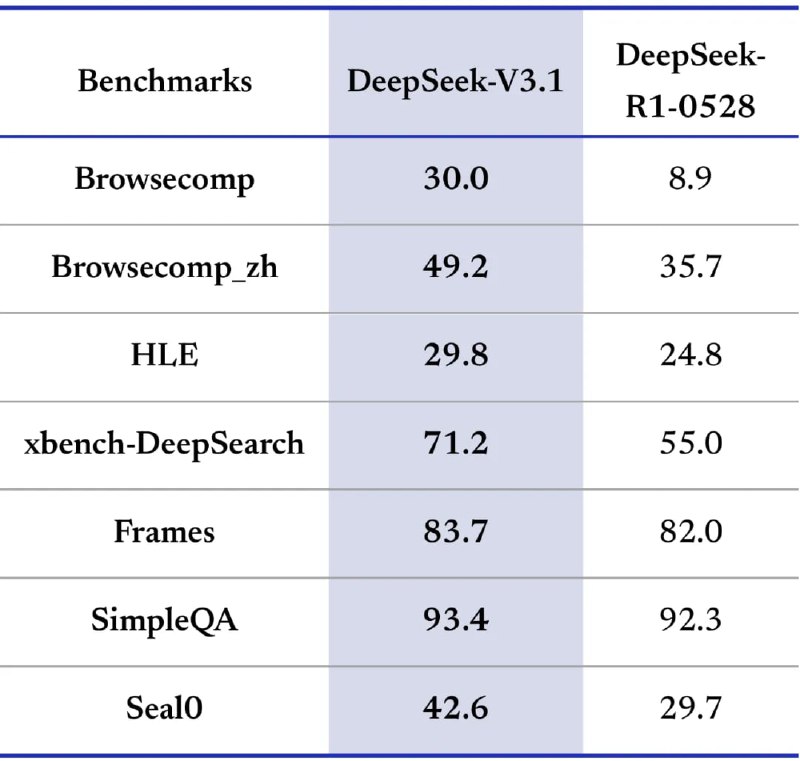
🏠 Детали DeepSeek V3.1

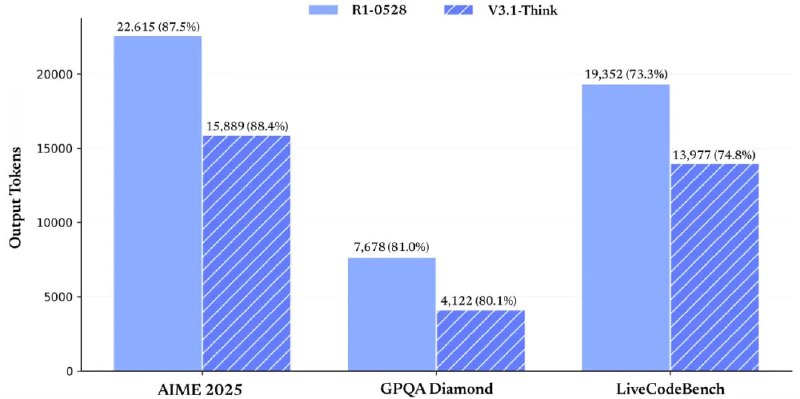
Самый сильный прирост заметен в агентных бенчах и использованию инструментов. Это гибридная модель, где можно включать и выключать ризонинг. Инстракт режим модели заметно вырос по бенчам по сравнению с V3-0324. А вот прироста у ризонинг режима по сравнению с R1-0528 нет, но ризонинг теперь использует заметно меньше токенов при том же качестве.

Обновили и Base модель для лучшей работы с длинным контекстом — в 10 раз увеличили context extension с 32к токенов и в 3 раза с 128к токенов. Кроме этого модель тренировали в формате совместимом с mxfp8 и mxfp4, которые добавили в Blackwell.

С этим релизом обновили и официальное API — добавили режим совместимый с API Anthropic, так что туда теперь можно подключаться с Claude Code. Длину контекста в API расширили до 128к, плюс начали тестить улучшения для function calling.

Кроме этого с 5 сентября (16:00 UTC) в официальном API будет действовать новый прайсинг — убирают ночные (по китайскому времени) скидки и разницу в прайсинге между ризонинг и инстракт режимами. Новая цена за аутпут — $1.68 за миллион токенов (сейчас $1.1 за инстракт режим и $2.19 за ризонинг). Инпут токены стоят $0.07/миллион если они уже есть в кэше и $0.56 при промахе мимо кэша.

👉Новости 👉База вопросов
  • ❤ 1
  • 👍 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →