


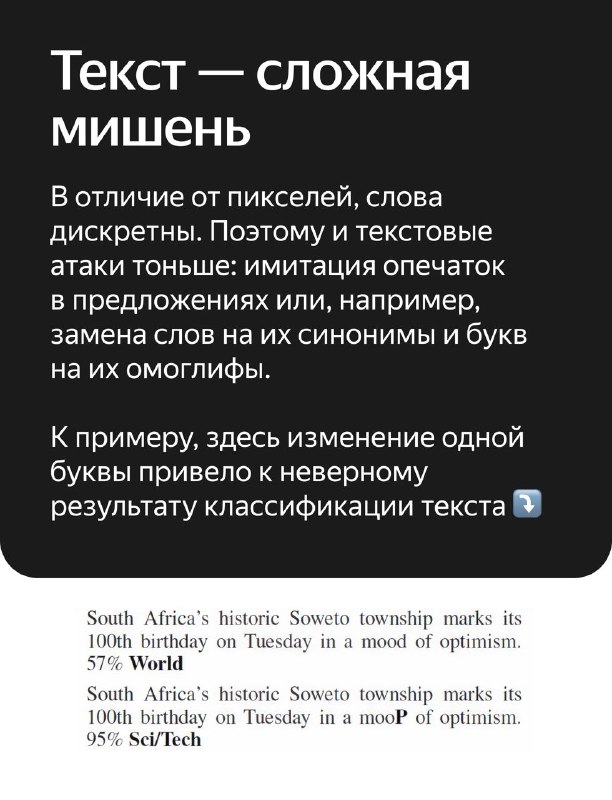


AI-модели уязвимы к состязательным атакам — алгоритмам генерации состязательных примеров. Их создают злоумышленники специально, чтобы заставить нейросети некорректно работать.
Для человека небольшие изменения исходного текста, картинки или видео почти незаметны или вообще не видны. Но при этом из-за особенностей алгоритмов машинного обучения нейросеть значительно меняет ответ при таких изменениях. И начинает делать то, что выгодно атакующему.
👨💻 Меня зовут Леонид Морозов, я инженер по информационной безопасности. Хочу рассказать, как именно работают такие атаки в случае текстовых моделей, какие бывают цели и возможности злоумышленников и какие способы защиты действительно работают.
🕵️ Читайте все подробности в карточках выше
«Хотя такие атаки актуальны скорее для негенеративных моделей (например, для классификаторов текста), в сочетании с другими приёмами они могут быть использованы и против генеративных LLM.
В качестве одной из мер защиты сообщество предлагает использовать детекторы промпт-инъекций. Однако без применения описанных методов безопасности они могут быть легко обмануты с помощью состязательной атаки».
Подписывайтесь:
💬 @Yandex4Security
📹 @YandexForSecurity