
🔎 Поиск по архивам: от расшифровки текста до расшифровки смысла
Привет, меня зовут Даша Виноградова, я руковожу универсальными применениями компьютерного зрения в Яндексе. Поиск по архивам — это сервис, который помогает людям находить сведения о родственниках и известных личностях в исторических документах.
Сейчас для пользователя всё достаточно просто: можно ввести фамилию или населённый пункт, и Поиск покажет, в каких записях упоминается человек. Пробираться через скоропись, сложный почерк и рукописные тексты не нужно, ведь их уже распознали модели.
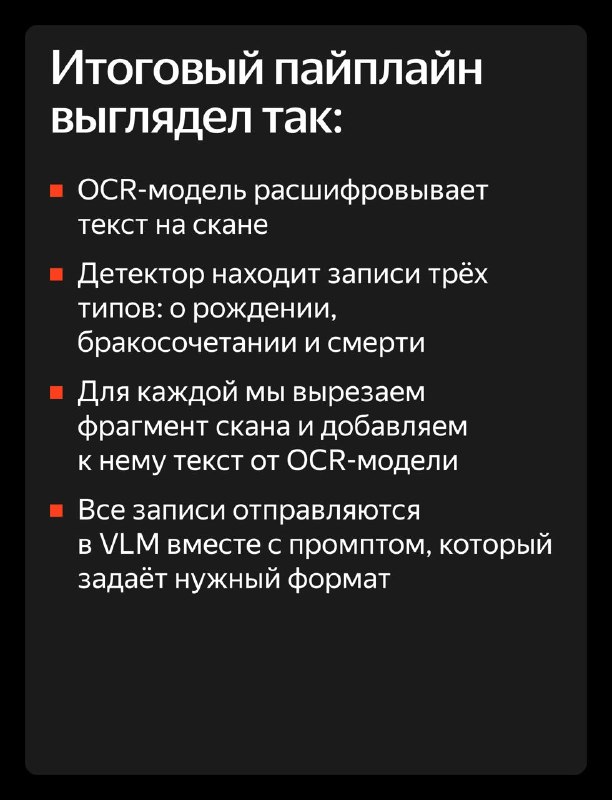
Но пришли мы к этому удобству не сразу. Даже для сильной OCR-модели расшифровка архивных документов — весьма нетривиальная задача. Да и просто видеть слова на скане недостаточно: нужно понимать, кто именно упомянут в записи, в какой роли и как связан с другими людьми.
👳♂️ В этом посте я расскажу, как мы сделали ключевой шаг в развитии сервиса: перешли от распознавания текста к извлечению структуры и смысла из архивных документов. Читайте в карточках, как мы перестраивали OCR-пайплайн и строили разметку, чтобы обучать VLM-модель.
📕 А в статье на Хабре я показываю:
🔴 Какие метрики мы использовали и к каким результатам пришли
🔴 Зачем современным OCR-моделям нужны блоки
🔴 Почему нам не подошли эвристики
Подписывайтесь:
💬 @Yandex4Developers
Post #1670
3.82K




- ❤ 8
- 🔥 7
- 🦄 4