Канал о том, как эффективно работать в IT: простые объяснения технических вещей, лайфхаки, лучшие практики и полезные инструменты для повседневных задач.
☕️ Семантический слой: ключ к доверию в данных и эффективности ИИ
Меня давно интересовал вопрос: как подружить данные и искусственный интеллект — сделать так, чтобы на вопрос «какая выручка за прошлый месяц» система выдавала мне нужную цифру? На первый взгляд, задача простая. Но на практике всё оказывается сложнее: алгоритмы генерируют SQL-запросы, игнорируя бизнес-контекст. Например, если в запросе фигурирует «клиенты», ИИ может выбрать таблицу users, а не customers, если не указано, что именно подразумевается. Это приводит к ошибкам и недоверию к результатам.
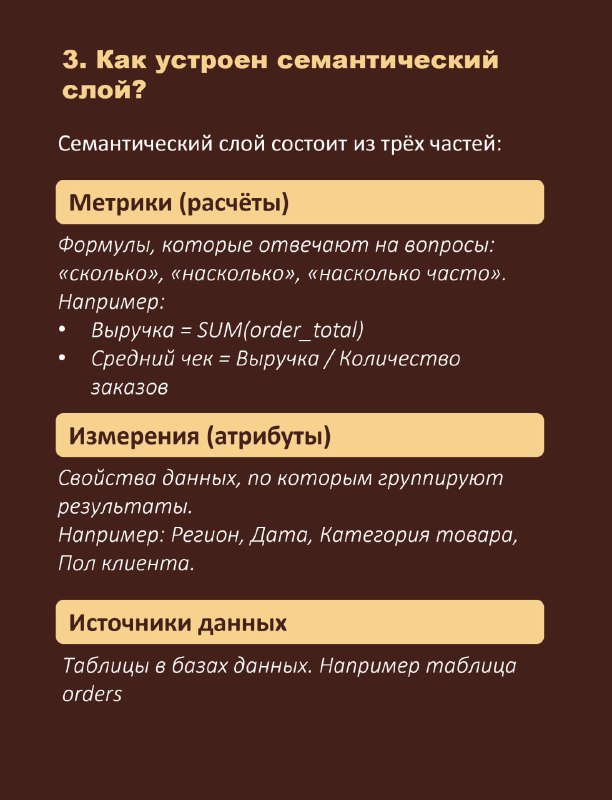
Решение пришло после изучения концепции семантического слоя. Оказалось, что проблема скрывается в отсутствии единой «карты» для ИИ: без чёткой связи между бизнес-терминами и техническими источниками данные превращаются в 💩.
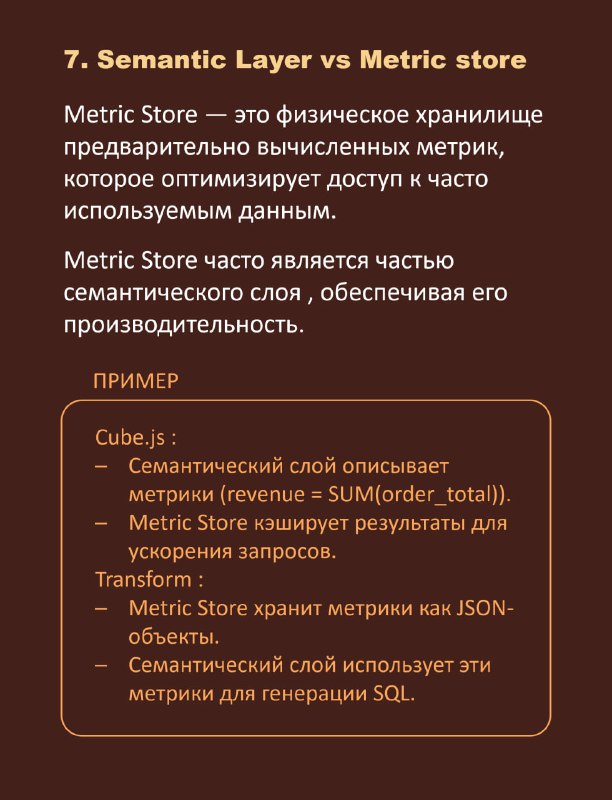
Семантический слой — это прослойка между сырыми данными и конечными пользователями. Он выступает своего рода «переводчиком», объясняя ИИ и аналитическим инструментам, что именно означают метрики, откуда они берутся и как рассчитываются.
Он не выглядит как «наворот» для крупных корпораций. Он необходим любому бизнесу, который хочет масштабировать аналитику и внедрять ИИ. Без него есть риск создать «долг» в виде противоречивых данных, ручной работы и потери доверия к выводам.
Если вы начинаете путь к цифровизации: заложите семантический слой на этапе проектирования. Это сэкономит время и деньги в будущем, а ИИ превратится из «черного ящика» в надёжного партнёра.
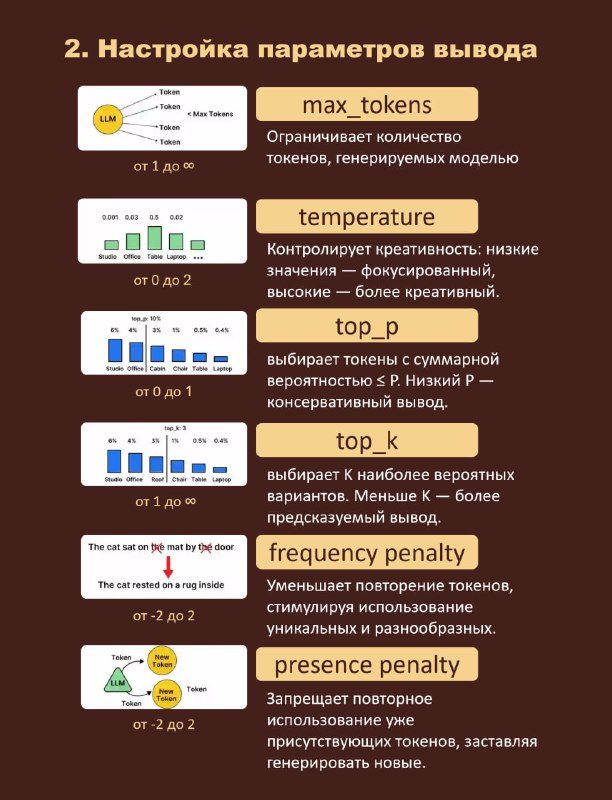
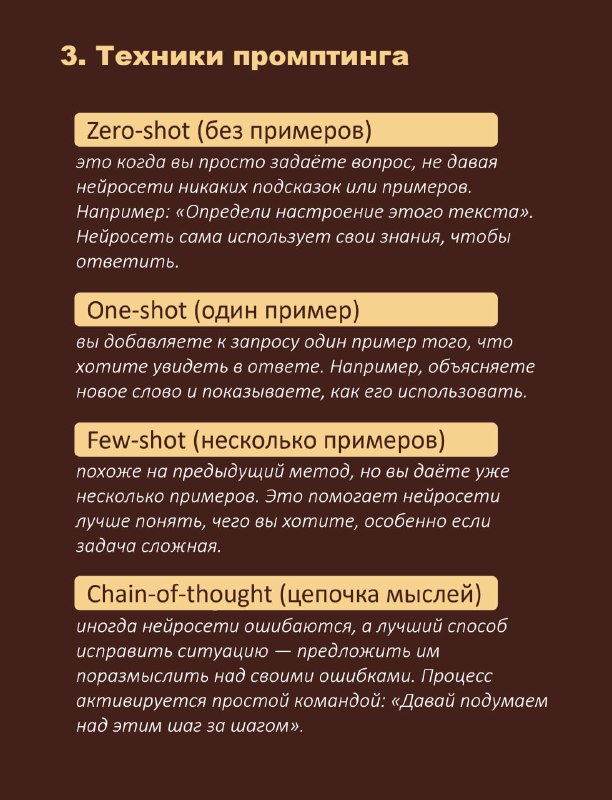
Наткнулся на перевод статьи «Prompt Engineering» от Lee Boonstra (инженер из Google) — и сразу решил поделиться с вами основными тезисами в виде карточек.
☕️ Контент как продукт: почему "создателям" нужны аналитика и обратная связь (продуктовые размышления)
В роли менеджера продукта, в котором одни пользователи делают что-то для других (контент, товар, услугу - далее "продукт"), мне довелось побывать уже несколько раз. И я лишь утвердился в мысли, что моя задача — не просто дать инструменты создания продуктов внутри продукта, а предоставить «создателям» инструменты разработки "качественных продуктов" через применение продуктового подхода. Такие инструменты должны охватывать весь продуктовый цикл — от анализа пользовательских потребностей до измерения эффективности и оптимизации взаимодействия с аудиторией.
Рассмотрим на примере BI-системы Большинство таких систем обладают хорошей функциональностью создания (визуализаций, дашбордов). И почти все из коробки лишены инструментов аналитики, работы с обратной связью. Авторы дашбордов часто не имеют прямой связи с аудиторией и не понимают, как их отчёты используют коллеги. А без обратной связи и данных о поведении пользователей их работа становится абстрактной, что ведёт к снижению качества их продукта - дашбордов. Я внедрял несколько BI-систем и везде нам приходилось буквально дорабатывать в сторонке недостающие инструменты.
Продукт должен быть мостом между создателями и потребителями. Инвестируя в инструменты, которые помогают первым «чувствовать» потребности вторых, можно повысить качество всей экосистемы. Это не просто улучшение UX — это стратегия, которая превращает пользователей-создателей в со-продактов.
Когда создатели контента получают доступ к данным и инструментам взаимодействия, они начинают мыслить как продуктовые владельцы. Это повышает релевантность материалов, снижает нагрузку на поддержку и увеличивает вовлечённость аудитории.
Что можно внедрить? ❶ Аналитика использования — Показатели популярности контента (просмотры, время взаимодействия, частота обновлений). — Тепловые карты активности (например, какие элементы дашборда/документации чаще кликают). — Интеграция с системами обратной связи (рейтинги, комментарии).
❷ Инструменты сбора потребностей — Встроенные формы запросов обратной связи («Помог ли этот дашборд?», «Что улучшить в статье?»). — Аналитика запросов поддержки: автоматическая группировка часто задаваемых вопросов для корректировки контента.
❸ Коммуникационные фичи — Чаты, треды обсуждений или уведомления о новых комментариях. — Функция «предложить изменения» для читателей/пользователей.
❹ Автоматизация и эксперименты — A/B-тестирование версий контента (например, разные структуры документации). — Рекомендации на основе данных: «Пользователи, которые открыли ваш дашборд, часто ищут X».
Когда «создатели» видят данные, они перестают угадывать. Они начинают думать как продакты: ставят гипотезы, тестируют, оптимизируют. Их контент перестает быть «просто отчетом» — он становится решением реальных задач пользователей.
Каждый спринт я стараюсь добавить фичи, которые помогают нашим пользователям-создателям чувствовать себя как продакты. Потому что когда один человек делает что-то классное для другого — это и есть суть хорошего продукта.
Представьте, что вы спрашиваете у ИИ-ассистента про новый фильм. Обычно он опирается на данные, «встроенные» в него во время обучения. Но если информация устарела или слишком специфична, ИИ может ошибиться. Тут на помощь приходит RAG.
RAG (Retrieval-Augmented Generation) — технология, позволяющая ИИ-моделям использовать внешние источники знаний для генерации более точных и актуальных ответов. В отличие от стандартного подхода, где модель обучается на фиксированном наборе данных, RAG динамически дополняет контекст запроса пользователя информацией из специализированных баз, не участвовавших в обучении модели. Это делает LLM «умнее» в конкретных областях без необходимости повторного обучения.
Как работает RAG? Процесс RAG можно разбить на шесть этапов:
❶ Запрос пользователя Пользователь задает вопрос через интерфейс LLM (например, текстовое поле или голосовой ввод). Запрос направляется на сервер.
❷ Преобразование в вектор и поиск Сервер конвертирует запрос в векторное представление («переводит» ваш вопрос на свой язык) и отправляет его в систему поиска.
❸ Поиск релевантной информации Система ищет ответы в ваших базах знаний: PDF-файлах, базах данных, репозитории кода, веб-страницах или API. Цель — найти самые актуальные данные для ответа.
❹ Обогащение контекста Полученная информация возвращается на сервер, где добавляется к исходному запросу, создавая «обогащенный контекст».
❺ Генерация ответа LLM Обогащенный контекст передается LLM (например, GPT, Gemini, Claude). Модель использует новые данные для формирования ответа.
❻ Возврат результата Готовый ответ возвращается пользователю.
В чем преимущества? — Всегда актуально: даже если помощник «не знал» чего-то раньше, он найдёт свежую информацию. — Точность: подходит для сложных тем, где ошибаться нельзя — медицина, законы, наука. — Не нужно учить заново: вместо того чтобы «переучивать» помощника на новые данные, просто обновляют источники информации.
Итог RAG — это как дать умному помощнику шпаргалку с самой важной информацией. Он остаётся таким же быстрым и сообразительным, но теперь может помочь в любой области, где есть знания. Если вы когда-нибудь задумывались, как ИИ даёт точные ответы на специфические вопросы — теперь знаете секрет!