

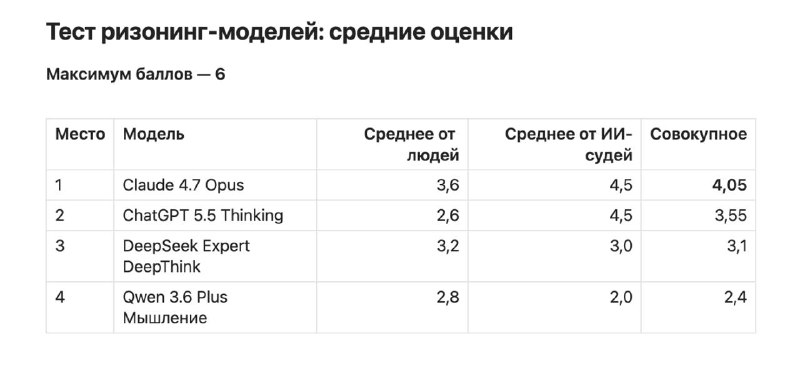

Уже больше года я регулярно провожу в редакции sberbank ru тесты разных LLM, это помогает выбрать инструменты, которые подходят именно нам, и сформулировать гипотезы для улучшения промптов. Тестирование проходит в формате «слепого» оценивания: разные модели выполняют наши типичные редакторские задачи (от написания сторис, до генерации текстовых прототипов), а редакторы оценивают ответы — при этом «судьи» не знают, где какая модель.
На прошлой неделе закончили очередную пару тестов, результаты — на скринах.
Методология тестирования
В двух тестах агенты выполняли задачи с одинаковым ТЗ и на основе одинакового системного промпта. В первом тесте мы сравнивали 6 «быстрых» моделей без reasoning, во втором — 4 «думающие» модели с reasoning. Обезличенные ответы моделей оценивали редакторы и AI-оценщики (Opus 4.7, GPT-5.5 Thinking).
Критерии для оценки:
- соответствие ответа условиям задания
- отсутствие критических ошибок
- соблюдение редстандартов
Главное о результатах
🔝 1 место уверенно занимает Claude — единственная нейронка, которой все участники поставили оценку выше среднего в тесте «быстрых» и «вдумчивых» моделей.
🤖 2 место у ChatGPT, но за счёт аномально высоких баллов от ИИ-оценщиков. Если считать только «человеческие» голоса, Чат занял бы предпоследнее место среди «быстрых» и последнее место в ризонинге. При этом в прошлом году ChatGPT регулярно был фаворитом редакции — кажется, что-то поменялось в последних релизах.
🤔 При оценке ответов ИИ-судьями заметил self-preference bias — LLM легко узнавали «себя» и ставили своим ответам завышенные баллы. Сразу вспомнил недавний пост о том, что ИИ-рекрутёры предпочитают отклики, написанные «родственной» моделью. Этот bias важно учитывать при работе с LLM-as-a-Judge — например, перепроверять оценку несколькими агентами или валидировать оценку экспертами.
❕ Быстрые и дешёвые модели пишут не хуже «думающих», когда получают хороший системный промпт и подробное ТЗ — выполнять мелкие задачи с предсказуемым образом результата можно и не сжигая вагоны токенов. Часто вижу в сети советы использовать самые жирные модели для всех задач, но с таким подходом в том же Claude с подпиской за 20 баксов утыкаешься в лимиты уже утром.
Но если агентная система получает «грязные» вводные, которые нужно критически оценивать, или неполные инструкции, тут не обойтись без ризонинг-модели в роли планировщика/менеджера/оценщика.