TGViewer
Channel Public Channel
КайфКодинг

КайфКодинг

@vibecodingartem

ВайбКодинг с Артемом Кругловым,
выпускник МФТИ, AI-гуру и основатель AnyQuery.

Быстрые лайфхаки: короткие видео с приёмами и трюками
Subscribers
1.03K
Photos
357
Videos
110
Links
499

Showing posts older than #195 · Back to latest

Older Posts 18 shown
Post #194 459
Post #193 464
В 15-30 выступаю на ИТ-пикник.

В шатре Т Образование
  • ❤ 5
  • 👍 1
Post #192 467

Forwarded from Denis Sexy IT 🤖

Обещал вам поделиться с теми случаями, где ChatGPT Operator / Agent мне как-то помогали. А поскольку, Operator, как отдельный продукт закроется через две недели, и останется только Agent внутри ChatGPT – делюсь:

— У меня где-то была подписка на анализы крови пару раз в год – нашел письмо, сохранил как pdf, приложил к чату, оператор удачно записал меня на прием на удобное мне время; авторизоваться нужно было все еще руками

— Закрывал подписку в фитнес (я уже раскачался зачем мне, потому что есть зал на работе) и даже не пытался понять как это сделать в маленьком европейском фитнесе: оператор сам прочитал нужные страницы на голландском, написал драфт письма на какой-то секретный адрес, я просто отправил

— Пользовался сервисом, где чтобы закрыть подписку нужно писать В ЧАТ САППОРТУ РОБОТУ; в общем Operator прекрасно с ним пообщался, все закрыл (SciFi чувствовался, да)

— Нужно было выставить инвойс в PDF: описал услугу, и приложил просто текст переписки в чате где были реквизиты клиента и мои; красивый PDF собрался за минуту и я смог выставить его клиенту после проверки

— Нужно было быстро посмотреть отзывы на конкретный плагин в одном маркетплейсе за полгода, на довольно специфичную тему; отправил агента, он там пошуршал минут 15 листая веб страницу, все прочитал, смог собрать самые частые жалобы по конкретной тематике

— Google Maps иногда отвратительно ищет: толи потому что тут все на голландском языке, а я ищу на английском, толи просто потому что я криворукий: нужно было мне на визу в США сфоткаться, и агент нашел фотолабу у дома, а Google Maps посылал куда-то на пару станций метро дальше

— Вчера вышла мелкая LLM моделька от Google: Gemini 3 260M, хотел ее запустить чтобы поиграться, но обычно в таких модельках нужно внимательно настраивать семплер чтобы не тупило – а чтобы это сделать нужно читать реддит и тп, с лучшими практиками, короче агент вернул настройки и я счастливо поигрался

— Нужно было заполнить гигантскую анкету на голландском и переводчик не работал, агент задавал вопросы на английском, и на основе моих ответов заполнил всю форму

— Про помощь в выборе квартире я уже писал тут

🌎 Что полезного можно применить, чтобы максимально прокачать агента:

— В Plus подписке всего 20 использований Агента в месяц, чтобы узнать сколько у вас осталось: наведите мышку на Агента в вебе и появится хинт с информацией

— Авторизация шарится между чатами, то есть войдя в аккаунт в одном чате, в другом чате вы можете быть уже авторизованы (В Data Cotrol в настройках можно выйти из всех аккаунтов сразу), что довольно полезно

— Агент не имеет доступа к памяти вашего ChatGPT, поэтому лучше держать готовой заметку с короткой инфой о себе, где вы живите, какой адрес, какой телефон – агент так сможет заполнить форму целиком (например, при заказе товара) и позвать только на оплату

— Агент хорошо ищет информацию, но обрабатывает ее лучше всего GPT 5 Thinking/Pro: вы можете попросить агента что-то поискать и выплюнуть в чат результаты, и уже большой моделью обработать выводы (с Deep Research режимом также)

ℹ️ Когда применять агента:

Как по мне, все мелкие задачи которые вы вынуждены делать, но не хотите делать, идеально делегируются ему — ключевое слово мелкие, потому, что это хоть и впечатляющая технология, но за вас отработать 8 часов не сможет (пока ☕️)
  • ❤ 5
Post #191 439

Forwarded from “Слушай свое сердце”

Наконец-то добрался написать про RecSys Challenge 2025, в котором мне посчастливилось поучаствовать вместе с R&D-командой по рекомендательным системам Яндекса: Серёжей Макеевым, Владимиром Байкаловым, Алексеем Красильниковым, Владом Тыцким и Кириллом Хрыльченко. Отдельно хочется выделить Серёжу Макеева — он сражался как лев, особенно в последнюю неделю перед первым дедлайном и ещё 5 дней перед вторым. (Ага, не так страшны первые 90% проекта, как вторые)

Для тех, кто не в курсе: RecSys Challenge — это соревнование по рекомендательным системам, приуроченное к конференции RecSys 2025. В далёком 2015 году команда из Yandex Data Factory, в составе которой был Евгений Соколов, уже выигрывала это соревнование, так что мы в целом были настроены на победу тоже. Наше решение — ансамбль разных нейросетевых моделей плюс хендкрафт-фичи. Собственно, за хендкрафт отвечал я. Забавный факт: даже в нейросетевую эру хендкрафт всё ещё приносит ощутимый профит. Про это, конечно, рассказывали на лекциях ШАД по RecSys, но я не верил и как обычно плохо слушал. Теперь верю.

Соревнование продлили дважды: сначала с 10 июля по 25 июля — из-за дата-лика, потом ещё — с 25 по 30 июля. К последнему продлению я даже приложил руку. Да-да, именно я заставил коллег делать по 8 сабмитов в день на выходных. За несколько недель до конца соревнования заметил, что при локальном эвале по первой задаче метрика иногда улетает в небеса. При внимательном анализе оказалось, что метрики, по которым пересчитывается лидерборд, изредка считались на нулевой эпохе — то есть на случайно инициализированной нейросети — и тогда по первой задаче выскакивали аномально большие значения. На самом лидерборде такого поведения не было видно на тот момент — я успокоился и забил. Но за два дня до дедлайна в системе появились несколько посылок с невероятно высоким скором по первой задаче. Написал оргам 24 июля, те за день до дедлайна — они признали факап и пересчитали решения конкурентов. За это время мы ещё успели чуть-чуть поднять метрики. Наступил дедлайн, система перестала принимать сабмишены, игроки опубликовали топовые решения, которые до этого не светились на лидерборде, — и мы оказались на 4-м месте. Тут орги решили, что их мув с пересчетом решений за один день до дедлайна не совсем честный, и продлили дедлайн на 5 дней и увеличили число сабмишенов в день 🤡. У нас реально появился шанс залететь в призы, мы снова включились в работу, улучшили общий скор, но всё равно остались четвёртыми.

P.S. Второе место заняла команда из Сбера (ai_lab_recsys). Вот разбор их решения: https://vkvideo.ru/playlist/-229792778_-2/video-229792778_456239026?from=groups&gid=229792778.
  • 🔥 5
  • ❤ 2
Post #189 625
Команда платформы над код ревью. После того, как активно внедрили cursor
  • 😁 7
  • ❤ 2
  • 🤣 2
Post #188 589
  • 🤣 11
  • ❤ 5
  • 😁 2
Post #187 613
Связка ChatGPT5 (оркестратор) + Claude Code ( агент) творит чудеса в исследовании enterprise кода
Post #186 620

Forwarded from SaaS по Понятиям

Новое правило этикета

Когда ты общаешься с человеком (вживую или на созвоне) - отвлекись, пожалуйста, от Claude Code. Даже если хочешь поставить его кодить в фоне.
  • 😁 9
  • 💯 2
Post #185 631

Forwarded from SaaS по Понятиям

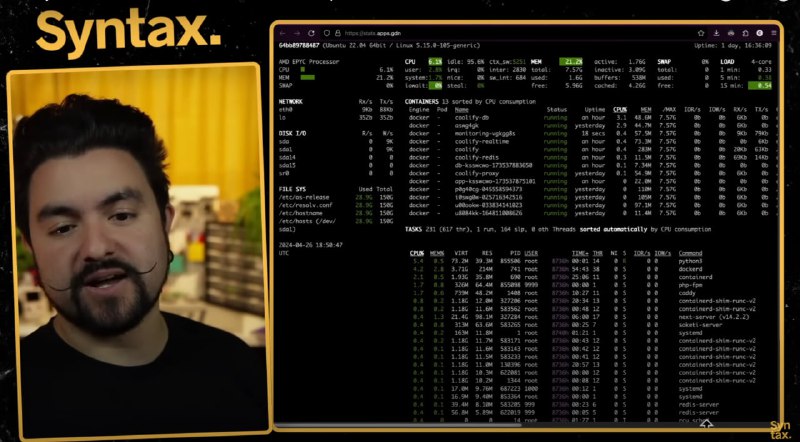
Я нашел золото для тех, кто хочет узнать новые фишки в разработке/деплоях/технологиях

Это YouTube канал "Syntax"

Это не реклама, я просто залип и прошел часовой курс по Coolify: https://www.youtube.com/watch?v=taJlPG82Ucw и теперь много чего осознал, научился и просто делюсь топ-контентом с вами.

В моем to-watch листе:

Как делать MCP server - https://www.youtube.com/watch?v=CCaUnet8SB4&list=PLLnpHn493BHHNUfHN5lDf11UD8jQ5Bpzl&index=6

Как принимать деньги в интернете - https://www.youtube.com/watch?v=mfoklsT7wvk
- это конечно, все если ты находишься за пределами СНГ, но раздают базу, обьясняя что такое чекауты, IBAN, ACH, Merchant of Record. Допустим, в америке вместо европейских IBAN есть ACH-счета (Automatic Clearing House).

Сильно рекомендую для задротов и интересующихся что посмотреть полезного вместо Нетфликса на выходных.
  • ❤ 5
  • 🔥 5
Post #184 507

Forwarded from Сиолошная

Так, ну пользователи на Reddit уже пожаловались, что GPT-5 не очень, а что говорят сторонние бенчмарки? Ещё в первый вечер листая твиттер собрал большую часть списка ниже, но было лень оформлять — вот, дошли руки. Разбил всё на 2 блока, это бенчмарки бизнесов, делающих продукты на AI (и потому имеющие внутренние способы оценки прогресса) и чисто бенчмарки, которые сравнивают модели на абстрактных задачах, которые не факт, что экономически полезны.

Бизнес-задачи:
1. Улучшение на 15-38% сверке банковских выписок/извлечении вендора, сравнение только с GPT-4o, без конкурентов (ссылка)
2. Ревью PR & поиск ошибок & исправления, много метрик описывают, но одна из впечатляющи — 77.3% pass rate против 26.7% у Sonnet 4 (o3: 44%) (ссылка)
3. end-2-end решение проблем на программирование на внутреннем наборе задач Cognition (Devin), лучше Sonnet 4 (в планировании — на 7%) (ссылка)
4. Cascade SWE-Bench, внутренний бенчмарк Windsurf, на ~3-4% лучше Sonnet 4 в pass@1, и на ~12% в pass@5 (ссылка)
5. Улучшение на 5% в среднем и на 9% в длинных документах на задаче извлечения бизнес-сущностей (ссылка)
6. 88% на задаче работы с Excel-файлами, Gemini и Sonnet 4 78% (ссылка)
7. 86% на заполнении страховых форм, Gemini 78% (ссылка)
8. Улучшение на 20-100% против Claude на внутренних кодинг-задачах JetBrains на Java/Kotlin, Go, Rust (включая внутренние репозитории, которых нет в интернете). Деталей нет, зато поделился кто — Евгений Патеха! Олды тут? (ссылка)
9. Поиск финансовых инсайтов в документах, 83% против 79% у o3, 65% у Gemini, 62% у Claude (ссылка)

Бенчмарки:
1. 66% на Visual Physics Comprehension, Gemini 48%, Claude 39% (ссылка)
2. Существенный прирост на IFScale, бенчмарке составления ответа с сотнями ограничений/инструкций, 90%+ при 500+ инструкциях в контексте, Gemini 2.5 70%, Claude нет (ссылка)
3. Топ-1 с отрывом на очень свежем бенчмарке на длинный контекст (документы на ~100k токенов) от AA, 76% против 68% Grok 4, 66% Gemini / Claude. Бенчмарку буквально 5 дней (ссылка)
4. Топ-1 с маленьким отрывом на Confabulations/Hallucinations on Provided Texts benchmark, 10.3% против 12.4% у Gemini и 13.2 у Sonnet (ссылка)
5. Топ-1 в бенчмарке Рината, составленному по бизнес-задачам разных доменов, 79.4% — и это medium reasoning effort, даже не high. Бенчмарк снова устарел... (ссылка). Gemini 74%, Claude 3.7 71%.
6. Какой-то абсолютный разнос в livecodebenchpro-live, куда попадают относительно свежие задачи с Codeforces + другие свежие. У модели Elo-рейтинг 2296, у Gemini 1585. Но тут надо ждать пока появятся новые соревнования и задачи с них прососутся в бенчмарк. (ссылка)
7. Топ-1 в WeirdML-v2 (появился совсем недавно, добавилось 13 новых задач), 56.3% против 50% у Gemini и 45.3% Claude 4 Sonnet. (ссылка)

А ещё стоит помнить, что GPT-5 очень дешева (дешевле o3 и тем более моделей Anthropic!), так ещё и кэширование теперь даёт 90% скидку вместо 50%.

It's a good model sir.

===

Означает ли это, что модель лучше во всём и везде? Конечно, нет. Я думаю, что количество вопросов/доменов/задач, где GPT-5 хуже o3 / 4.1, очень мало, но не равно нулю. Даже на простых промптах может казаться, что GPT-5 якобы деградировала.

Например, если GPT-4o давала хороший ответ в 30% случаев, а GPT-5 — в 60% (те же 30% промптов + какая-то группа новых), то как думаете, при сравнении ответов как часто вам будет казаться, что ответ первой лучше? В 35% случаев... больше трети ответов!

И ещё одно задание по математике: сколько жалоб мы увидим, если от 700M пользователей у 1% ухудшился опыт, и 1% из них решил написать что-то про это 😀
  • ❤ 2
  • ⚡ 1
  • 🔥 1
Post #183 467
Формируется огромный разрыв между теми, кто использует активно ИИ, и кто нет.
  • 🔥 4
  • ⚡ 1
Post #182 491
Пойду спать
  • 🌚 5
Post #181 495

Forwarded from Дмитрий

https://research.google/pubs/what-improves-developer-productivity-at-google-code-quality/

О чём статья: исследование Google (ESEC/FSE 2022) пытается не просто найти корреляции, а установить причинные факторы, которые реально улучшают продуктивность разработчиков в «боевых» условиях. Два анализа: панельный опрос по 39 факторам + лаговый панельный анализ с метриками из логов.

Ключевые выводы:

На продуктивность каузально влияют шесть групп факторов: качество кода, техдолг, инфра-инструменты и саппорт, коммуникации в команде, цели и приоритеты, организационные изменения и процессы.

Направление причинности проверили отдельно: улучшение качества кода → рост продуктивности, а не наоборот. Увеличение удовлетворённости качеством кода на 100% в предыдущем периоде ассоциировано с −10% времени активного кодинга на CL, −12% времени от создания до отправки CL, −22% времени от сабмита до деплоя в следующем периоде. Обратной связи («сначала продуктивность, потом качество») не нашли.

Что не подтвердилось как причинный драйвер продуктивности: документация и митинги (несмотря на субъективную важность в откликах разработчиков).


Методология (коротко):

Панельные опросы Google Devs по 39 факторам с повторными измерениями → панельный анализ для отделения стабильных «скрытых» эффектов.

Для направления причинности между качеством кода и продуктивностью использовали лаговый панельный анализ и метрики из логов (времена по CL, деплой и т.д.).


Практические импликации:

Если нужен быстрый прирост индивидуальной продуктивности — инвестируйте время команды в улучшение качества кода (рефакторинг, архитектурная гигиена, снижение техдолга) и улучшение инфраструктурных инструментов/поддержки. Это даёт «самый большой выхлоп» при высокой статистической значимости (см. квадрант эффекта/значимости).

Фокус на «больше документации и меньше митингов» сам по себе не демонстрирует причинного эффекта на продуктивность.


Ограничения:

Данные одной компании; первая часть опирается на самооценку продуктивности; результаты важно валидировать в вашем контексте.
Google Research What Improves Developer Productivity at Google? Code Quality.
  • ❤ 2
Post #178 521

Forwarded from Миллер про Вайб-Кодинг

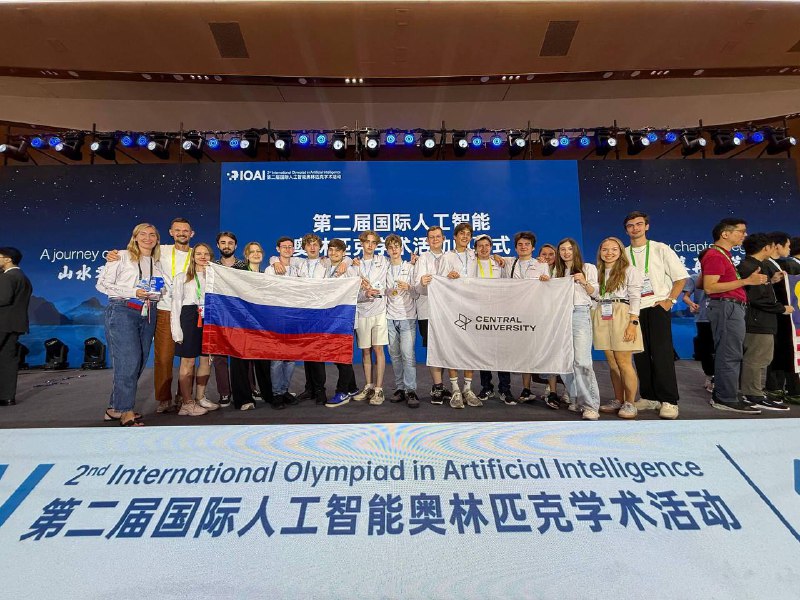
Школьники из России выиграли международную олимпиаду по ИИ в Китае — завоевали 6 золотых, одну серебряную и одну бронзовую медали.

Сборная России опередила 70 команд из 61 стран мира. Команду готовили эксперты Центрального университета, которые привели сборную России к победе и в прошлом году, на первой Международной олимпиаде по ИИ в Болгарии. К подготовке в этом году присоединились представители Альянса в сфере ИИ и МФТИ.

Молодцы!!!
  • 🔥 19
  • 🏆 4
  • ❤ 2
Post #176 494

Forwarded from Alexander Sirach

  • 😁 8
  • 🤣 2
Post #175 485

Forwarded from Сиолошная

Длинный контекст работает существенно лучше прошлых моделей компании.

А ещё его растянули до 400k токенов. И цена — копеечная, $1.25 за миллион токенов на входе, $10 за миллион на выходе.
Post #174 471
Теперь можно 15 тыс строк кода закинуть за раз и получить очень классный ответ.
  • 🔥 2
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →