TGViewer
Channel Public Channel
Вайб-кодинг

Вайб-кодинг

@vibecoding_tg

Авторский канал по ВАЙБ КОДИНГУ

Ссылка для друзей: https://t.me/+ll3pbl442dNkZmYy

Cотрудничество: @devmangx

РКН: https://clck.ru/3RRVfk
Subscribers
63.1K
Photos
2.2K
Videos
916
Links
1.5K

Showing posts older than #3675 · Back to latest

Older Posts 15 shown
Post #3674 24.6K
Тибо написал, что завтра для нас будет небольшой сюрприз. 😏
Post #3673 25.2K
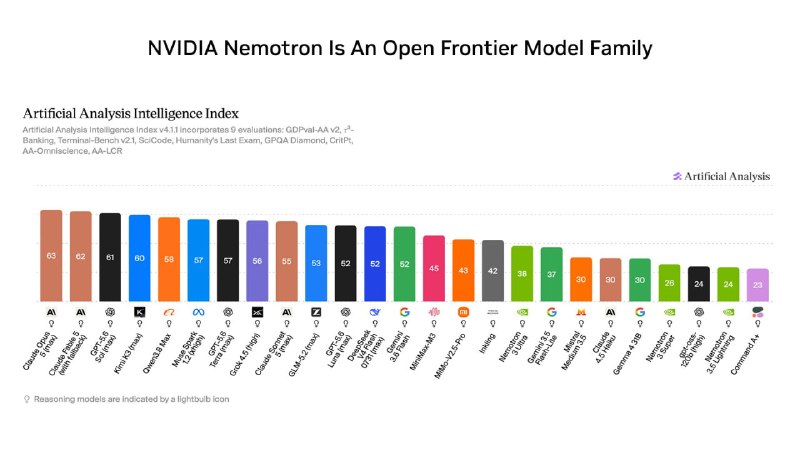
NVIDIA выпустила открытую модель Nemotron 3.5 Lightning для постоянно работающих ИИ-агентов.

Это модель на 30 млрд параметров, из которых активируются только 3 млрд. За счёт этого скорость генерации до четырёх раз выше, чем у моделей сопоставимого размера.

В PinchBench она показала точность 86% и выполнила 10 000 задач на 35% быстрее Qwen3.6 35B при сопоставимой точности.

Модель можно дообучить на собственных данных, инструментах и рабочих процессах. Она достаточно компактна, чтобы запускаться на DGX Spark.

Вместе с ней NVIDIA открыла NeMo Switchyard - библиотеку, которая распределяет разные этапы работы агента между моделями. Сложные рассуждения и планирование можно отдавать передовым моделям, а массовое выполнение задач - быстрой Lightning.

NVIDIA также опубликовала веса, данные и рецепты обучения.

Доступна бесплатно через OpenRouter.
Post #3672 24.1K
Нашёл интересный совет по Codex: вместо /goal юзать define-goal.

По сути, это как если бы ИИ экспертного уровня формулировал цель за тебя лучше, чем ты сам. И это официальный навык OpenAI.

Так промпты могут работать дольше, а результат получается качественнее. Сначала просишь Sol в режиме высокого уровня усилий исследовать задачу и составить план.

Дальше важный момент: Sol сам по умолчанию не запускает Luna как сабагента. Поэтому ему нужно прямо сказать создать отдельный поток в Luna Max, передать туда выполнение задачи, а результат вернуть обратно в родительский поток Sol.

Sol проверяет результат и, если он недостаточно хорош, отправляет его обратно в тот же поток Luna Max на доработку. И так до тех пор, пока результат не будет одобрен.

Sol → Luna → Sol → Luna → Sol
GitHub skills/skills/.curated/define-goal/SKILL.md at main · openai/skills Skills Catalog for Codex. Contribute to openai/skills development by creating an account on GitHub.
Post #3670 22.5K
Теперь модели Claude будут встраивать невидимые водяные знаки во весь сгенерированный текст, а также добавлять метаданные ко всем поддерживаемым файлам. 🤷‍♂️
Post #3669 22K
Линуксоиды, для вас приятные новости:

Codex и ChatGPT Desktop теперь доступен и на Linux. 🤓

Пока это предварительная версия, поэтому местами ещё могут встречаться шероховатости.
Post #3668 22.5K
Теперь работу из других агентов можно синхронизировать с ChatGPT Work и Codex.

Можно импортировать проекты, чаты, навыки и плагины, смотреть историю импорта и при желании включить автоматические обновления в настройках.

Причём самое интересное здесь именно чаты, навыки и плагины. Сами проекты и AGENTS.md и раньше можно было использовать параллельно в разных агентах.

Функция уже доступна в десктопном приложении ChatGPT. 😍
Post #3667 25K
Tencent Hunyuan выпустили WorldClaw — систему, в которой агент сам планирует и собирает 3D-мир. 😳

Пользователь просто описывает нужную сцену. Дальше WorldClaw сам планирует ландшафт, генерирует здания, растения, персонажей и другие объекты, а затем собирает всё это в Blender.

Причём система ещё и проверяет результат. Если объекты висят в воздухе, пересекаются друг с другом или выглядят несоразмерно, WorldClaw продолжает вносить правки и заново рендерит сцену для проверки.

После генерации всё остаётся редактируемым: ландшафт, здания и растения существуют как отдельные 3D-объекты, которые можно двигать, удалять и изменять, а затем использовать в играх или анимации.

Сейчас Claude Opus 4.8 отвечает за планирование, координацию и проверку, а конкретные задачи выполняют GPT-Image-2, SAM3, SAM3D, Hunyuan3D и Blender.
Post #3666 24.2K
Hermes Agent Desktop продолжает радовать обновлениями. 😏

На днях там появился HUD mode. Теперь Hermes перестаёт быть отдельным окном и превращается в слой поверх приложения, в котором вы работаете.

Его можно оставить рядом как агента-помощника, перетаскивать по экрану и задавать вопросы прямо по ходу работы.

Например, Hermes может читать и суммировать посты в X, анализировать графики TradingView и даже открывать проекты и добавлять файлы в видеоредактор.
Post #3665 22.4K
Сильная новая работа от Meta.

Обычно законы масштабирования предполагают, что размер модели и объём данных влияют на ошибку независимо друг от друга.

В этой работе авторы вводят Skaling law — закон, который связывает ёмкость модели и данные через единый параметр взаимодействия.

Дополнительный член снижает среднюю абсолютную процентную ошибку примерно в 1,5–3 раза как при интерполяции, так и при экстраполяции.

Самые заметные улучшения — в режимах, где данных мало или модель сильно переобучают. Именно там стандартные законы Chinchilla и Kaplan начинают заметно промахиваться.

Ещё одна важная часть. Вместе с разреженной сеткой небольших запусков метод позволяет экстраполировать всю картину примерно с в 10 раз меньшими вычислительными затратами, чем при равномерном переборе.

Почему это важно?

Сегодня модели часто обучают и разворачивают далеко за пределами классического вычислительно-оптимального режима. Если закон масштабирования остаётся точным и там, причём его можно оценить на небольших запусках, это напрямую меняет то, как можно планировать бюджет на предобучение.

Работа: https://arxiv.org/abs/2608.07222
Post #3664 21.9K
Поскольку вопросы безопасности становятся всё актуальнее, OpenAI выпускает специализированную модель для кибербезопасности — GPT-5.6-Cyber.

Это первая масштабная попытка компании напрямую усилить модель для продвинутых задач в этой области, включая разработку эксплойтов.

По словам OpenAI, модель уже показывает себя особенно сильно в защитных сценариях. Её используют по всему внутреннему стеку для редтиминга, а исследователи безопасности с её помощью нашли и закрыли большое количество 0-day уязвимостей в открытом ПО.
OpenAI Expanding Daybreak as the Cyber Defense Window Narrows Meet GPT-5.6-Cyber, OpenAI’s cybersecurity-specific model available through Daybreak Red for authorized vulnerability research, exploit validation, and security testing.
Post #3660 22.4K
Вот это день. 😳

Meta снова всерьёз возвращается к открытым моделям. Компания выпустила Glimmer — сильную агентную модель c 30 млрд параметров и уже готовит Spark 1.2 с открытыми весами.

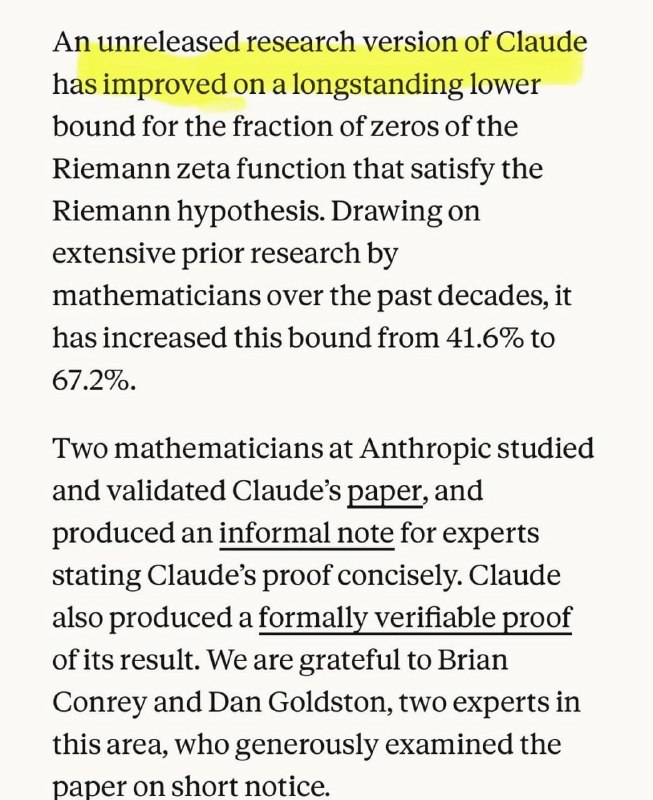
Anthropic тем временем попыталась решить одну из самых известных нерешённых задач в математике — гипотезу Римана — с помощью ещё не выпущенной модели Claude. Саму гипотезу модель не решила, но в процессе Claude неожиданно улучшил давний результат вокруг неё: долю нулей дзета-функции Римана, для которых гипотеза подтверждена, удалось поднять с 41,6% до 67,2%.

Параллельно Anthropic объявила, что стартовая цена Sonnet 5 становится постоянной: $2 за миллион входных токенов и $10 за миллион выходных.

А Gemini 3.5 Pro, похоже, вообще не выйдет. По данным SemiAnalysis, Google отменила релиз модели и, судя по всему, сразу переходит к Gemini 4.
Post #3657 22K
Qwen открыли Qwen-MM-Plugins.

Это набор плагинов, который добавляет агентным обвязкам мультимодальные возможности.

Кто-то уже побежал делать DeepSeek мультимодальным ⌨️
Post #3656 22.7K
Полезный плагин для Codex 5.6: Sentry

Многие сталкивались с таким. Только исправил баг, и старая проблема снова появляется, загоняя проект в цикл бесконечных переделок.

Это происходит потому, что скриншоты или логи, которые вы обычно передаёте Codex, содержат только последнее сообщение об ошибке. При этом действительно важные данные, которые определяют, можно ли вообще нормально исправить проблему, отсутствуют: стек вызовов, область влияния, частота возникновения, информация о версии и контекст выполнения.

Недавно по совету друга из Китая я подключил плагин Sentry к Codex, и теперь весь процесс поиска проблем выглядит совсем иначе.

Больше не нужно постоянно копировать и вставлять отчёты об ошибках. Достаточно сказать:

Используй Sentry, чтобы определить текущие баги в проде. Не смотри только на сообщения об ошибках, сопоставь стек вызовов и текущий код, чтобы найти реальную первопричину.
После этого Codex может напрямую получить доступ к данным об ошибках, на которые у вас есть права, и сопоставить их с текущим кодом проекта, чтобы:

> Восстановить ситуацию. Посмотреть полный стек вызовов и контекст выполнения, чтобы понять, при каких условиях возникает баг.

> Найти первопричину. Сопоставить ошибки из прода с конкретным кодом, не строя догадки только по последнему сообщению об ошибке.

> Проверить исправление. Сначала воспроизвести проблему и добавить регрессионные тесты, а затем изменить код, чтобы не получилось так, что исправление одного ломает другое.

Можно наконец выйти из цикла, когда баг исправили, он снова сломался, его снова исправили — и так по кругу. 😱
Post #3653 21.6K
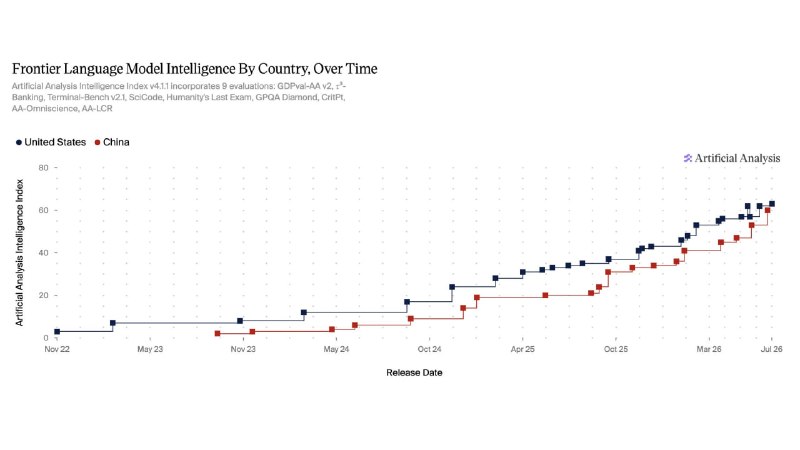
Разрыв между американскими и китайскими моделями практически исчез.

И теперь ByteDance, по данным сразу нескольких источников, обучает модель размером до 10 трлн параметров — примерно в три раза больше Kimi K3.

На этом фоне всё сложнее представить сценарий, в котором американские лаборатории просто решат замедлиться. Пока Китай продолжает инвестировать, масштабировать и давить на газ, такая пауза будет означать риск отдать лидерство конкуренту. 😱
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →