TGViewer
Channel Public Channel
Вайб-кодинг

Вайб-кодинг

@vibecoding_tg

Авторский канал по ВАЙБ КОДИНГУ

Ссылка для друзей: https://t.me/+ll3pbl442dNkZmYy

Cотрудничество: @devmangx

РКН: https://clck.ru/3RRVfk
Subscribers
63.2K
Photos
2.2K
Videos
923
Links
1.5K

Showing posts older than #3484 · Back to latest

Older Posts 16 shown
Post #3479 17.7K
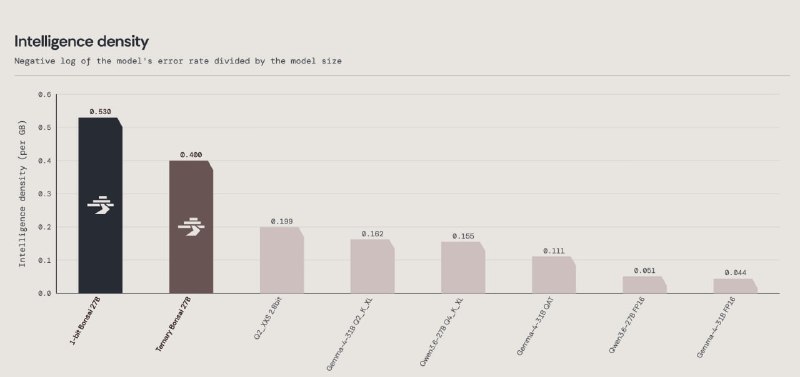
Вышла первая модель класса 27B, способная работать на смартфоне

PrismML представила Bonsai 27B — 1-битную и тернарную версии Qwen3.6-27B.

Благодаря низкобитному представлению размер исходной FP16-модели удалось сократить с 54 до 3,9 ГБ — примерно на 93%, или в 14 раз.

Доступны две версии:

> 1-bit Bonsai 27B — 3,9 ГБ
Оптимизирована для запуска на смартфонах и использует 1,125 эффективного бита на вес.
> Ternary Bonsai 27B — 5,9 ГБ
Ориентирована на ноутбуки и использует 1,71 эффективного бита на вес.

Тернарная версия сохраняет около 95% производительности модели с полной точностью, а 1-битная — около 90%. Оценка охватывает рассуждения, математику, программирование, следование инструкциям, использование инструментов и работу с изображениями.

Обе версии опубликованы с открытым исходным кодом под лицензией Apache 2.0.

Благодаря кастомным WebGPU-ядрам, разработанным при помощи Fable 5 и GPT-5.6 Sol, Bonsai 27B может запускаться локально прямо в браузере — без отправки данных в облако.

Веса 👍
Post #3478 19.9K
Грег Брокман поделился скиллом для Codex, который находит первых клиентов для вашего стартапа. 🚬

Вставляете URL стартапа — и он начинает работу:

> Автоматически определяет профиль идеального клиента
> Ищет в публичных обсуждениях боли и сигналы готовности к покупке
> Квалифицирует каждого потенциального клиента и оценивает его по соответствию, актуальности момента и возможности выйти на связь
> Генерирует персонализированные первые сообщения для каждого
> Собирает всё в аккуратный HTML-отчёт с ссылками на исходные источники

Открытый исходный код, установка одной командой.
Post #3476 18.4K
Возможно, мы становимся свидетелями начала новой эпохи в науке.

Юдзи Татикава, профессор Токийского университета, занимающийся квантовой теорией поля и теорией струн, заявил, что Claude Fable 5 помог сдвинуть с мёртвой точки совместный исследовательский проект, который не продвигался уже шесть месяцев.

Ради интереса Татикава передал модели свои исследовательские заметки. Fable обнаружил ошибку в вычислениях, затем пришёл к тому же тупику, что и сами исследователи, а после дополнительного запроса развил альтернативный подход.

По словам Татикавы:

«Он сделал нетривиальное наблюдение и, по сути, решил эту задачу.»


Его также удивило, что модель самостоятельно использовала SymPy (инструмент для символьных математических вычислений) для написания кода и проверки собственных выводов.

В конце он добавил:

«У меня сложилось впечатление, что Fable действительно понимает теорию струн и даже обладает своего рода интуицией.»


Здесь важно понимать, что это рассказ одного исследователя, а не опубликованный или независимо подтверждённый научный результат.

Но речь уже не об очередном приросте в бенчмарках. Это пример того, как передовая языковая модель помогла продвинуть реальное исследование в области теоретической физики.

p.s. Исследователь уже удалил вирусный твит, пояснив:

«Я удалил этот твит, потому что он неожиданно получил слишком большое распространение. Я лишь хотел поделиться информацией об этом инструменте как исследователь.»
Post #3475 19.4K
Целый час по-настоящему ценного материала: на этот раз Шен Шон Чен рассказывает о том, как с нуля создавать самоулучшающихся AI-агентов.

Таймкоды:
00:00 — Как рождается агент, способный развивать себя самостоятельно.
03:01 — soul.md: файл, который управляет всем.
30:16 — Умный RAG: извлекаются только 20 релевантных сообщений вместо 2 000.
31:48 — Цикл, который сам понимает, когда нужно остановиться.
35:14 — Обнаружение ошибки и исправление промпта прямо в процессе работы.
50:22 — Как Claude автоматически сжимает и оптимизирует память.
Post #3473 16.7K
Энтузиаст сократил объём языковой модели GLM-5.2 с 1 403 ГБ до 980 ГБ, не изменяя её содержимое.

По его словам, метод не использует квантизацию, дообучение и любые другие модификации модели.

Заявлено, что модель остаётся бит в бит идентичной оригиналу, а уменьшение объёма достигается за счёт нового подхода к работе с весами. Вместо предварительного разворачивания полной модели веса сохраняются в сжатом виде непосредственно в VRAM, что позволяет избежать необходимости восстанавливать их перед выполнением вычислений. 🚬
Post #3472 17.4K
Теперь Hermes Agent можно подключить прямо к браузеру в виде боковой панели.

Расширение называется Hermes Browser Extension. Оно считывает содержимое активной вкладки и сразу передаёт контекст в текущую сессию Hermes.

https://github.com/abundantbeing/hermes-browser-extension 😱
Post #3470 17.6K
Хорошие новости от OpenAI: подвезли обновления для Codex и ChatGPT Work.

> внедрили оптимизации инференса и передали полученную экономию всем подписчикам GPT-5.6 Sol. В результате доступный объем использования должен увеличиться примерно на 10%.
> обнаружили, что увеличение лимита контекстного окна в продукте для GPT-5.6 Sol с 272 тыс. до 372 тыс. токенов приводило к тому, что использование тарифицировалось больше, чем предполагалось. Поэтому временно вернули лимит к 272 тыс. токенов и в ближайшие дни снова развернут поддержку 372 тыс. Обещают, что после этого изменения - лимиты будут расходываться значительно медленнее.
> также обнаружили, что при high и xhigh уровне reasoning используется немного больше мультиагентной обработки, чем планировалось. Они уже исправляют это. Заодно оптимизируют еще один небольшой момент в механизме авто-превью, чтобы он работал эффективнее.

Кроме того, в Codex сегодня сбросили лимиты + временно убрали пятичасовые ограничения для Plus, Business и Pro. 😁
Post #3469 17.8K
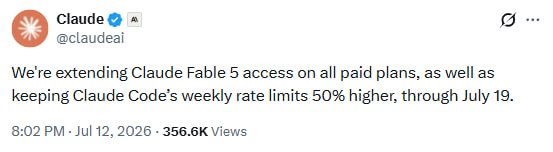
Лол: Claude Fable 5 снова продлили ещё на неделю.

Плюс недельные лимиты на эта неделю увеличили на 50%.

Спасибо, OpenAI. 🤣
Post #3468 19.8K
Anthropic описала четыре типа циклов, которые можно строить с помощью Claude. Каждый из них передаёт агенту разную часть процесса принятия решений.

Термин loop engineering сейчас используется настолько широко, что стоит чётко понимать, чем именно отличаются эти четыре варианта: что запускает цикл и что определяет момент его завершения.

> Цикл на основе запросов. Вы отправляете запрос, Claude выполняет задачу, самостоятельно проверяет результат и возвращает его вам. Именно этот цикл работает практически при каждом вашем сообщении, независимо от того, называете вы его так или нет.
> Цикл на основе цели (/goal). Вы заранее задаёте измеримый критерий завершения. Каждый раз, когда Claude пытается завершить работу, модель-оценщик проверяет, достигнута ли поставленная цель. Если нет, Claude отправляется продолжать работу.
> Цикл на основе времени (/loop, /schedule). Вместо пользовательского запроса запуск происходит по таймеру. Команда /loop повторно выполняет проверку через заданные интервалы, но прекращает работу, если останавливается ваша машина. Команда /schedule переносит ту же идею в облако, поэтому цикл продолжает работать независимо от вашей текущей сессии.
> Проактивный цикл. Это комбинация /schedule, /goal и рабочего процесса, которая запускается по событию без какого-либо запроса со стороны пользователя в момент выполнения. Каждый элемент доводится до собственной цели, а сам процесс продолжает работать, пока кто-нибудь его не отключит.

НО: циклы на основе цели работают только тогда, когда критерий завершения действительно можно измерить. А проактивные циклы это самый простой способ столкнуться с проблемами при масштабировании, если сначала не проверить их работу хотя бы на нескольких реальных сценариях. Для большинства задач по-прежнему лучше подходит обычный цикл на основе запросов, чем более сложная схема, в которой пока нет необходимости.

Необязательно выбирать самый продвинутый механизм только потому, что он сложнее. Важнее подобрать тип цикла в зависимости от того, имеет ли задача чёткий критерий завершения или действительно должна выполняться непрерывно.

Вот статья, где разобрали все четыре типа циклов, привели примеры и предложили подход к выбору между /goal и /loop. 🎉
Post #3467 15.8K
NVIDIA, возможно, решила главный компромисс современных LLM

При работе с любой LLM приходится выбирать между скоростью и качеством. Авторегрессионные модели вроде GPT обеспечивают высокое качество, но работают медленно, потому что генерируют по одному токену за раз.

Диффузионные модели действуют наоборот. Они генерируют целые блоки параллельно и поэтому работают быстрее, но до сих пор за эту скорость приходилось расплачиваться качеством.

Именно эту проблему попытались решить исследователи NVIDIA.

Они взяли 30B-модель и разделили её на две части, чтобы генерировать токены параллельно, а не по одному.
Так появилась Nemotron-Labs-TwoTower — диффузионная языковая модель от NVIDIA Research, адаптированная на базе Nemotron-3-Nano-30B-A3B.

Но прежде чем разобраться, как работает TwoTower, стоит понять, почему диффузионные LLM вообще уступают авторегрессионным.

Диффузионная LLM начинает с блока замаскированных токенов и раскрывает их за несколько проходов. На каждом проходе она считывает весь уже сгенерированный текст и одновременно предсказывает замаскированные токены в текущем блоке.
Получается, что одна и та же сеть одновременно выполняет две совершенно разные задачи. Она должна понимать уже существующий контекст и при этом предсказывать токены, которых ещё нет.

Один набор весов оказывается направлен сразу на две разные задачи, поэтому сеть не может полноценно специализироваться ни на одной из них.

TwoTower решает эту проблему, не заставляя одну сеть выполнять обе задачи. Вместо этого предварительно обученную авторегрессионную модель разделяют на две башни.

1. Context Tower — замороженная часть модели, которая считывает весь уже сгенерированный текст точно так же, как это делала исходная модель. Её больше не обучают, поэтому интеллектуальные способности модели полностью сохраняются.
2. Denoiser Tower — обучаемая часть модели, которая параллельно генерирует каждый новый блок токенов. Чтобы не терять контекст, она постоянно использует cross-attention к Context Tower.

Самое интересное — как взаимодействуют эти две башни. Они соединены послойно: пятый слой Denoiser Tower взаимодействует с пятым слоем Context Tower, шестой — с шестым и так далее.
Благодаря этому Denoiser получает доступ ко всему многоуровневому представлению контекста базовой модели, а не только к её финальному скрытому представлению.

Результаты:
> В 2,42 раза выше пропускная способность генерации
> Сохраняется 98,7% качества исходной модели
> Архитектура построена на базе гибридной 30B-модели Mamba–Transformer MoE
> Для обучения использовано всего около 2,1 трлн токенов — лишь часть от 25 трлн токенов, использованных при предобучении исходной модели

Последний показатель здесь особенно важен. Ни один из компонентов не обучался с нуля.
Это адаптация, которую можно добавить к уже существующей авторегрессионной модели. Она относительно дёшево превращает медленное декодирование по одному токену в быструю параллельную генерацию блоками.

Поэтому для любых систем, чувствительных к задержкам, это подход, который определённо стоит изучить. Больше не обязательно выбирать между моделью, которой вы доверяете, и необходимой скоростью.

Веса, код и методика обучения опубликованы в открытом доступе.

Статья: https://arxiv.org/pdf/2606.26493
Post #3466 17.5K
Небольшой лайфхак, о котором мало кто знал: если вставить большой фрагмент текста в Claude Code, он автоматически свернется в [Pasted text #1]. Если нужно его отредактировать, просто вставьте текст еще раз — он развернется. Или нажмите Ctrl+G, чтобы открыть весь промпт

После сохранения изменений они автоматически синхронизируются обратно в поле ввода Claude. 🎉
Post #3465 20.4K
На GitHub появился репозиторий, уже набравший много звёзд, в котором полностью раскрыта концепция Loop Engineering для создания торговых ИИ-агентов.

Внутри описан 12-шаговый процесс построения автономной квантовой торговой системы:

> стратегия → рыночные данные → сигналы → торговый агент → проверка → доработка → повторный запуск.

Сохраните себе и добавьте в закладки

https://github.com/cobusgreyling/loop-engineering

😊😊😊
Post #3463 17.5K
После анонса GPT-5.6 появилось сразу несколько моделей и уровней effort, из-за чего возник закономерный вопрос: какие комбинации вообще имеет смысл выбирать для агентной разработки? 🐸

Чтобы разобраться, Себастьян Рашка взял официальные данные OpenAI, сопоставил их с уровнями effort и построил собственную диаграмму, на основе которой сформулировал практические рекомендации:

- Если вам не нужна максимальная производительность Terra Ultra, почти всегда выгоднее использовать модель Luna с более высоким уровнем effort. Производительность будет такой же или выше, а стоимость — ниже.

- О моделях ниже Sol High можно забыть — в этих сценариях лучше использовать Luna с повышенным уровнем effort.

- Вместо Sol Extra High лучше сразу выбирать Terra Ultra.

- Дополнительные затраты на Sol Ultra, скорее всего, не оправдывают прирост по сравнению с Sol Max.


upd: в левом нижнем углу допущена ошибка - подписи Luna сдвинуты на одну позицию. То есть Luna Ultra следует читать как Luna Max.
Post #3462 16.3K
Это сценарий, может кому-то зайдёт: Claude Fable 5, который оркестрирует Grok 4.5 ☕️

Все, что нужно, — это бесплатный плагин для Claude Code, который делает Grok исполнителем по умолчанию. Fable пишет спецификации и проверяет каждый дифф, а Grok 4.5 занимается написанием кода через Grok CLI.

- Grok берет на себя основной объем кодинга, а Fable отвечает за архитектурные решения и контроль качества.
- Каждый дифф автоматически проходит кросс-проверку разными моделями — без дополнительных затрат.
- Если спецификации независимы друг от друга, они выполняются параллельно отдельными агентами.

Автор тестировал этот подход несколько дней, и больше всего впечатлило то, что Fable принципиально не пишет код. Он формирует спецификации, отправляет их исполнителю, оценивает полученный результат и на этом его задача заканчивается.

Настройка:

1. claude plugin marketplace add DannyMac180/fable-advisor && claude plugin install fable-advisor
2. Установите Grok CLI с http://x.ai/cli, затем выполните grok login.
3. Выполните команду /model fable.

Проект имеет открытый исходный код, поэтому можно изучить файлы агентов и настроить маршрутизацию запросов так, как вам нужно.
Post #3461 16.3K
Давно пора: Claude Code для десктопа получил встроенный браузер.

Claude может открывать документацию, макеты и любые другие сайты. Он умеет читать содержимое страниц, переходить по ссылкам и взаимодействовать с веб-интерфейсом так же, как с локальными серверами разработки.

Браузер работает в изолированной среде и поддерживает настройку сохранения сессий — вы сами решаете, сохранять их между запусками или нет.

p.s. Обновите десктопное приложение до последней версии, чтобы воспользоваться новой возможностью.

Подробнее — в документации 🎉
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →