TGViewer
Channel Public Channel
VF | Science

VF | Science

@vf_science

Генерацией музыки и всем, что связано с аудио ML я занимаюсь, а всем остальным ML интересуюсь)

Делюсь знаниями, мыслями, событиями по своей карье, делаю анонсы своих онлайн/офлайн мероприятий.

Автор: @varfolomeefff
Subscribers
1.13K
Photos
225
Videos
23
Links
92

Showing posts older than #256 · Back to latest

Older Posts 10 shown
Post #255 2.19K
👀 Случайно нашел весьма полезную статью - обзор на foundtion модели в музыке. Она прямо таки новая, от 3го сентября. Нашел ее пока смотрел цитирования другой статьи) Совет - смотрите цитирования статей, которые вам понравились.

В статье и про музыкальные репрезентации, и про понимание музыки моделями, и про датасеты, и про подходы для обработки/генерации музыки и их проблемы. Также отдельно рассматриваются состовляющие музыки: вокал, аккомпонемент, ноты. Надеюсь прочтение поможет придумать ту самую идею для ризерча.

#audio #papers
  • 🔥 8
  • 👍 6
  • ❤ 1
Post #254 978
9го ноября прилечу в Уфу рассказывать про экстракцию миди из аудио)) Есть апдейты

Как минмум я просто хочу сгонять в Уфу :)

https://dc.ufacoder.com/#program
  • ⚡ 12
  • ❤‍🔥 5
  • 🏆 1
Post #244 1.08K
👀 Ревью по выходным 14-15 сентября.

За выходные отлично провел время с коллегами. Мне не хватает слов, сколько положительных эмоций я испытал!

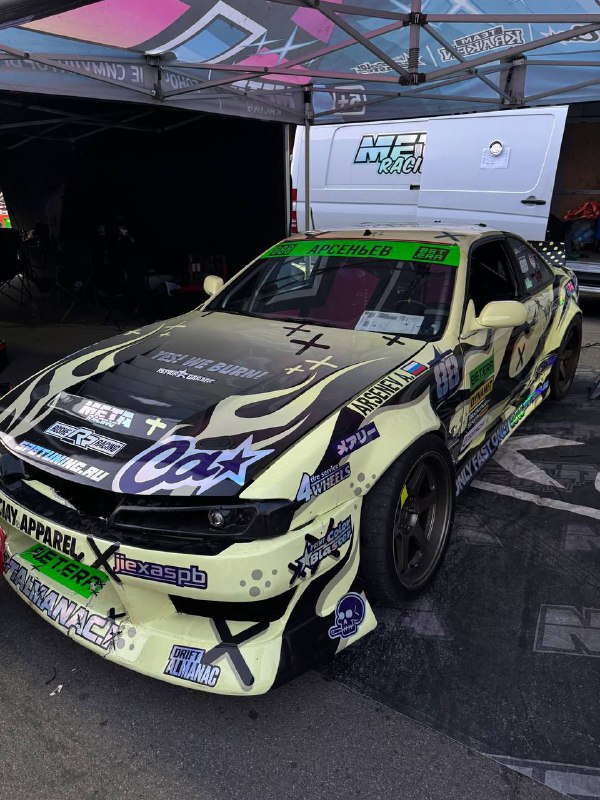
Начнем с того, что я работаю в X-Labs AI. Yeap bro, our boss is Ilon Mask. У нас есть много крутых ребят и проектов. Один из них это беспилотный гоночный автомобиль, который умеет дрифтить! На 6 видео именно такая машина, этот результат был достигнут за очень короткое время, коллеги не спали сутками, но ребята решили выйти на свет (смотрите конец обязательно). Также есть не менее инновационный проект Jggl, над которым я работаю в аудио команде. Jggl это соцсеть, с кучей нейронок для создания визуального и аудио контента. Позже расскажу ещё. Но факт — после вчерашнего я максимально зарядился перформить этот проект.

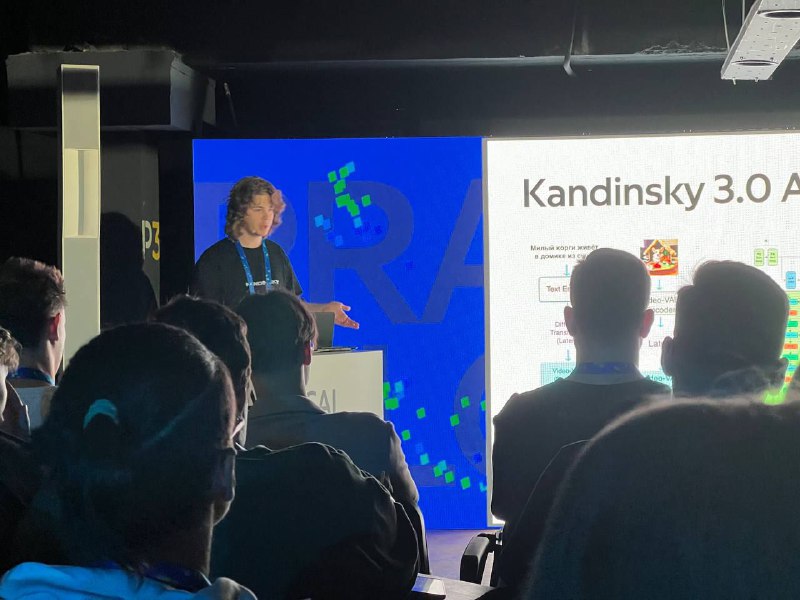
Теперь про день рождения. Его я отметил на конференции Яндекса и вообще не пожалел) Увиделся с теми, кого давно не видел и меня поздравили много людей, получил очень теплые слова, миу. Послушал доклад про аудио и дифузионки в кандинском. Отличная работа от спикеров! Было много вопросов на докладе про диффузионки, я слушал до конца и уже забыл почти все...)))) Но у меня есть заметки в избранном, фух. Доклад про аудио я бы еще обсудил здесь, скоро.

На следующий день я улетел в Минск на финал гонок по дрифту. Гонки спонсировала компания и мне выпала честь сгонять в командировку, это стал мой самый крутой день в жизни)))

В общем я еще 100 лет могу писать как я рад! Но теперь пора учиться, работать и делать полезный контент по аудио и др. темам DL.
  • ❤‍🔥 12
  • ❤ 4
  • 👍 3
  • 🔥 2
  • 😎 1
Post #243 835
Сегодня у меня др и я еду на practical ml conf :)

Нынче в свои годы мне очень повезло получить большие возможности, во всем, что для меня важно. Спасибо мама, за все, знаю что ты читаешь. Спасибо бабуля, знаю ты тоже читаешь) Бабуля купила мой первый ноутбук, мама оплатила занятия с ментором. Миша научил меня учиться и дальше все, что я изучал, было изучено самостоятельно. Выступления, работа, стартап, все это не было бы без фундамента, который мне создал ODS Moscow, спасибо Даниель. Список благодарностей весьма большой и дальше я пойду в лс) В прочем, сегодня можем увидеться на конференции.

Эффективно используя интернет можно достичь очень многое. Дальше больше, намного больше (надеюсь и постараюсь). Хорошего дня, моя лучшая часть человечества 🙂
  • ❤‍🔥 26
  • ❤ 2
  • 👍 2
Post #240 819
😬 Забыл выделить одну деталь. Размер кодовой книги напрямую влияет на качество реконструкции. С одной стороны это очевидно, с другой стороны об этом не всегда думают.

Хороший кодбук содержит элементы, которые будут максимально близки по евклидовому расстоянию к данным на входе модели. Размер кластеров напрямую влияет на точность реконструкции (скрин 1). Тут также стоит отметить, что мы получаем не 1 токен после энкодера, а несколько и затем свертками проходимся по ним. Посмотрите на оригинальную картинку VQ-VAE (скрин 2). Там идет тензор и каждый его элемент отдельно квантуется через кодбук. Мы просто даем больше информации декодеру и поэтому можем генерить более разнообразные данные.

Теперь, когда всем понятно насколько важно подобрать правильный размер кодбука, я напомню про совсем непопулярную статью: RAQ-VAE, здесь разработан подход для адаптивного под скорость размера кодбука. В целом, размер кодбука можно подбирать и по другим показателям используя идеи представленные в RAQ-VAE. Других критериев для адаптации кодбука никто не пробовал - возможно это будет неплохой темой для ресерча, думойте.

#papers #thoughts
  • 👍 5
Post #239 690
👀 WavTokenizer - новый сота аудио кодек с 1 кодовой книгой, лучшим качеством реконструкции и сжатием до 40-75 токенов на секунду аудио. Аудио кодек, объеденивший множество преимуществ из остальных кодеков.

Многие современные аудио кодеки используют остаточное векторное квантование (RVQ), и кроме этого хороших идей как будто бы нет... Сейчас речь пойдет про аудио кодек, в котором только 1 кодовая книга (кодбук) и типа... Стоп, мы же отказались от 1 кодбука и перешли на RVQ, зачем делать шаг назад?

Отказались от 1 кодбука, потому что для хорошего качества реконструкции он должен быть очень большой, типа 2^40... Это число привели авторы SoundStream - первого аудио кодека на основе RVQ.

Остаточное векторное квантование использует несколько кодбуков и в результате мы получаем несколько латентов из каждого кодбука. Чтобы обработать все латенты, модели на основе RVQ используют иерархические архитектуры: в моделях VALL-E это AR/NAR архитектура, в MusicGen это slanted autoregression, в UniAudio это LT и GT архитектура. Также есть идеи, позволяющие уменьшить количество кодовых книг с 8 до 4, как в Hifi-Codec.

Получается такой баланс:
1) Экономим на размере кодбука, но вынуждены использоать иерархические архитекуры в моделях, а это увеличивает размер последовательности с которой придется работать трансформерам.
2) Не экономим на размере кодбука, но будем долго сранивать элементы кодбука с латентом из энкодера. При этом будем экономить на длине последовательности.

⭐️ НОООО авторы WavTokenizer все же работают с 1 кодбуком и достигли лучшего качества реконструкции, как? Честно говоря я сам не понял, в статье написано, мол мы взяли 200 центроидов из LibriTTS и сопоставили их с текстовым вокабом... Поэтому я даже решил спросить у авторов подробностей и щас жду ответа. В итоге размер кодбука составил всего-лишь 2^12 и количество токенов в секунду всего 40-75. Вау, теперь и кодбук мелкий и размер последовательности тоже. Число 2^12 получилось не просто так, при этом размере элементы кодбука наиболее эффективно используются. Для того, чтобы в кодбуке было меньше "неактивных" элементов применяется метод random awaking, как в JukeBox. Мы просто периодически будем заменять неиспользуемые элементы на рандомные векторы из текущего батча.

Теперь про качество реконструкции. В декодер был добавлен механизм внимания, расширенное контекстное окно, STFT и ConvNeXt блоки. Также итоговый лосс состоит из 4 лоссов: потеря квантования (евклидово расстояние), L1 между мел-спектрограмами, состязательный хиндж лосс, L1 фичермапов между субдискриминаторами.

Основные идеи закончились, дальше советую почитать папиру) На последок скажу, что сейчас доступна лишь small модель и модельки побольше стоят на обучении. В статье вы не найдете некоторых деталей экспериментов, поэтому почитайте ишьюсы в их репе. Каких-то особых проблем в их китайском коде не наблюдается) Очень интересная работа, спасибо 👋

#papers #audio
  • 👍 7
  • 🔥 4
Post #238 593
  • 😁 20
  • ❤ 2
  • 🐳 1
  • 🌚 1
Post #237
Live stream finished (1 hour)
Post #236
Live stream started
Post #235
Live stream scheduled for Sep 6, 2024 at 13:00
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →