

И вот снова работа стоющая внимания от alibaba group. Нынче LLM в аудио широко применяются и хорошо себя показывают. Чтобы использовать LLM для обработки аудио нам нужно составить словарь аудио токенов, окей, это мы знаем. Словарик составляется путем остаточного векторного квантования (RVQ), потом мы обучаем LLM на токенизированом аудио и все хорошо, но можно лучше 😏
Допустим у нас есть несколько очень похожих аудио, которые мы не отличим на слух. Так вот, раз уж они очень похожи, ожидается, что и дискретные токены для этих аудио будут одинаковыми или около того, но токены разные. Даже если мы возьмем одно аудио, выделим из него часть и получим для нее токены, то они будут отличаться от тех, что были в полном аудио (рис. 1)! Все дело в контексте. Аудио сильно зависит от контекста, потому что сверточные ядра в энкодере перекрываются, то есть их размер больше 1х1 и делать его меньше = ухудшить качество реконструкции ))
Вот с текстом все проще, но аудио, друзья мои, это аудио. Одна секунда аудио содержит десятки тысяч семплов и чтобы эффективно сжать его существуют аудио кодеки типа EnCodec. Аудио кодеки активно используют RVQ, а RVQ становится лучше с большим колличеством слоев. Небольшое изменение в начале ведет к большим изменениям последовательности, то есть чем глубже слой RVQ, тем сильнее будут различия в токенах между неотличимыми на слух аудио. За десятки слоев много всего может произойти) Это не взять да сопоставить слово с токеном. Кстати странно, что все это заметили и исправили только сейчас, хотя кто бы говорил... 😱
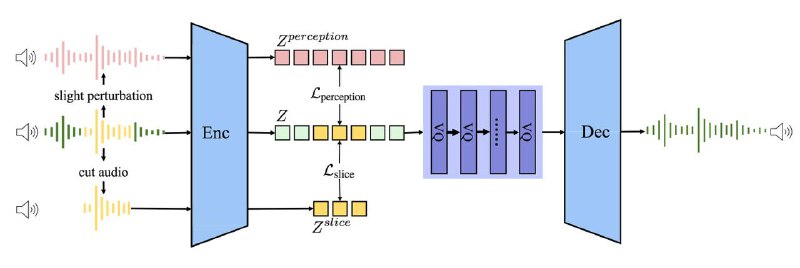
Распределение, на основе которого будет предсказываться следующий токен, будет усложняться и модели будет сложнее обучиться. Штош, это проблема энкодера и чтобы ее решить авторы добавляют 2 новых лосса (рис. 2). Первый считает MSE между токенами аудио на основе контекста и без него. Второй считает MSE между исходным аудио и аудио с неуловимыми на слух изменениями. А чтобы понять сходство токенов после обучения авторы создали метрику сходства, в которой просто смотрят на равенство соотвествующих токенов аудио с контекстом и без.
Вот и все, данная идея применимма ко всем аудио кодекам и был проведен большой анализ со всеми популярными кодеками. Результаты
#papers #audio