
😬 New foundation models for audio understanding and generation.
На днях вышла интересная работа с открытым кодом — FunAudioLLM. За недельку-две репозиторий набрал 2,8к звезд. Конечно, сейчас все что foundation довольно значимо.
FunAudioLLM это семейство foundation моделей, которое состоит из двух моделей:
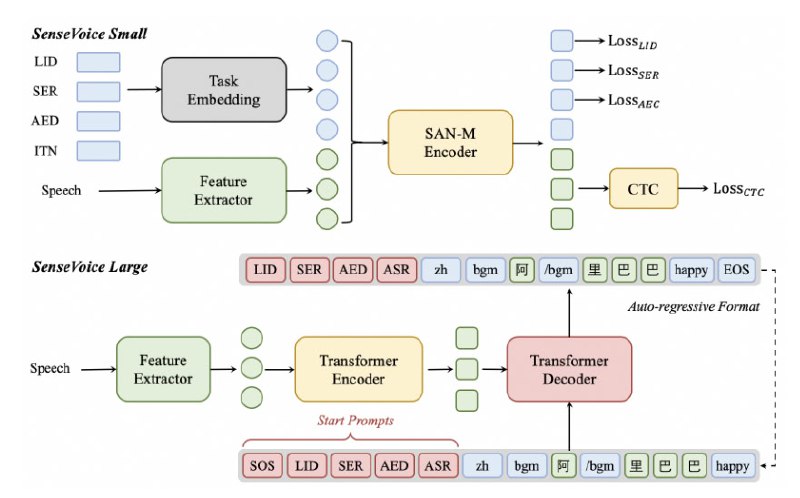
➡️ SenceVoice — для распознавания речи (рис. 1).
➡️ CosyVoise — для синтеза речи (рис. 2).
Особенности SenceVoice:
🔷Поддерживает многоязычное распознавание речи, модель обучена на более 300к часов.
🔷Есть 2 варианта модели. SenseVoice-Small быстр на инференсе, задержка распознавания составляет менее 80 мс и более чем в 5 и 15 раз быстрее, чем Whisper Small и Whisper-large, соответственно, а SenseVoice-Large поддерживает высокоточный ASR для более чем 50 языков.
🔷Кроме того, Sense Voice поддерживает расширенную транскрипцию, включая современное распознавание эмоций, обнаружение звуковых событий, обратную нормализацию текста и пунктуацию.
Особенности CosyVoice:
🔷Поддерживает 5 языков и был обучен на 170к часов аудио.
🔷Сэмплы, сгенерированные Cosy Voice, могут быть сгенерированы менее чем на 2% и более чем на 75% похожи на говорящих, что позволяет достичь уровня качества, равного человеческому.
🔷Поддерживает zero-shot контекстное обучение, которое позволяет клонировать голос за 3 секунды речи.
🔷Тембр, эмоции, просодия и стиль могут быть воспроизведены как на одном, так и на разных языках.
🔷Есть модель инструкций, которая может управлять личностью говорящего, стилем речи (например, эмоциями) и другими тонкими паралингвистическими особенностями с помощью текстовых инструкций.
Но также есть ограничения, о которых советую почитать в статье и гитхабе 😏
Говоря в общем, кажется, что траснформерами, в которые напихать кучу аудио модальностей мы далеко не уйдем) Это касается генерации аудио. Хотя, если вычислительные мощности будут типа квантовых компов, то... Думаю сейчас не хватает именно вычислительных ресурсов, причем не только для обучения, но и для инференса на устройствах юзеров. А вероятность, что изобретут супер оптимальный и репрезентативынй подход для генерации аудио мала.
#audio #foundation_models #stt #tts
Post #185
665

- 🔥 4
- 👍 3
- ❤ 1