TGViewer
Channel Public Channel
very vibe coding

very vibe coding

@veryvibecoding

Канал Алексея Макрушина об экспериментах в области vibe coding и всего интересного, что есть в области AI, ML и тому подобного
Subscribers
122
Photos
464
Videos
126
Links
1K

Showing posts older than #640 · Back to latest

Older Posts 13 shown
Post #635 37

Forwarded from Data Secrets
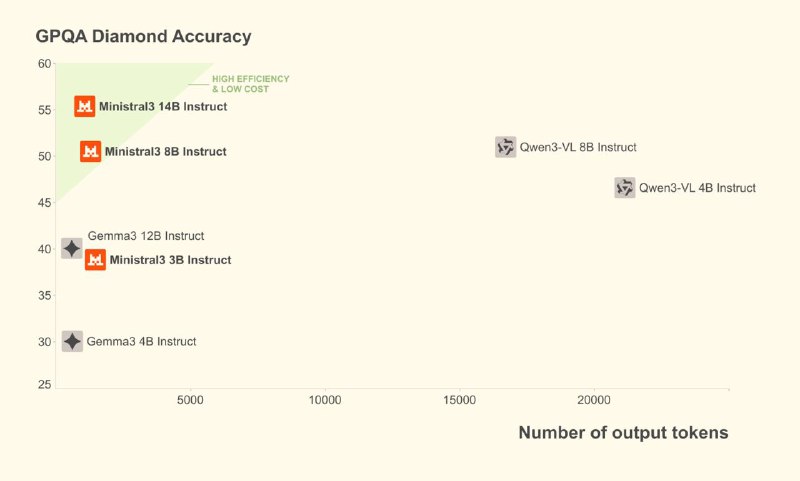
Mistral AI выпустили новое опенсорсное семейство моделей Mistral 3

Всего в релизе четыре модели: три очень прикольных малышки на 14B, 8B, и 3B + большая Mistral Large 3. Все под лицензией Apache 2.0.

Mistral Large 3 обучали с нуля на 3000 NVIDIA H200 GPU. Вполне приличный кластер, и это, кстати, первая MoE модель стартапа со времен Mixtral. 675B параметров, 41B активных.

По метрикам моделька на уровне DeepSeek 3.1 и Kimi K2. Еще вчера это были бы даже SOTA результаты среди открытых моделей, но появился DeepSeek-3.2 👒

Отдельно хвастаются пониманием изображений и мультиязычностью: говорят, на НЕанглийском и НЕкитайском модель лучшая в своем классе.

Что касается маленьких моделек, обещают лучшее соотношение цена/качество в соответсвующих размерах. Модели специально оптимизировали использовать меньше токенов, при этом не теряя в качестве. И результаты действительно неплохие: например, 14B выбивает 85% на AIME25. Для локальных запусков и небольших проектов – достойно.

Все семейство уже можно попробовать здесь

Веса (Large 3 & Ministral) | Блогпост
  • 🔥 4
Post #634 38

Forwarded from Data Secrets

Стартап OpenAGI (лайк за название) выпустили Computer Use модель Lux и утверждают, что это прорыв

По бенчмаркам модель на целое поколение обгоняет аналоги от Google, OpenAI и Anthropic. Кроме того, модель работает быстрее (примерно 1 секунда на шаг вместо 3 секунд у конкурентов) и в 10 раз дешевле по стоимости обработки одного токена.

Создатели (исследователи из MIT, кстати) утверждают, что суть успеха – в том, что это не затюненная LLM, а модель, которую с самого начала учили именно совершать действия. То есть абсолютно другая парадигма.

Из приятного: они даже открыли код инфры, в которой обучали агента, можно покопаться.

https://www.agiopen.org/
  • 🔥 1
Post #633 58
Сегодня вышла библиотека transformers 5 - как вы понимаете, почти все генерационные модели сейчас строятся на трансформерах, так что теперь разработка будет быстрее, проще, квантизация лучше.. кому интересны детали, можно почитать этот пост
huggingface.co Transformers v5: Simple model definitions powering the AI ecosystem We’re on a journey to advance and democratize artificial intelligence through open source and open science.
  • 🔥 6
  • ❤ 4
  • 👍 1
Post #631 50

Forwarded from Data Secrets

Ну что за прекрасный день? За последний час вышли сразу две крутых модели для генерации видео.

Первая – Gen-4.5 от всеми известного Runway. Заметно улучшили качество и физику, а также следование инструкциям (первое видео). В рейтинге от Artificial Analysis моделька выбила уверенное первое место.

Поддерживает разные стили и принимает референсы в виде видео и картинок. Доступа пока нет, говорят скоро только начнут раскатывать 😣

Вторая – Kling o1 (китайцы сегодня на высоте). Эта модель больше про редактирование, ее сравнивают с Nano Banana Pro для видео.

Довольно легко удаляет объекты, меняет цвета и стиль и все такое прочее (второе видео). И вот ее уже можно пробовать, причем бесплатно и пока безлимитно: https://app.klingai.com/global/omni/new.

Парад релизов продолжается 🎅
  • ❤ 7
  • 👍 2
  • 🔥 1
Post #628 48

Forwarded from Data Secrets

⚡️ Вышли свеженькие модели от DeepSeek!

Китайский стартап выпустил DeepSeek-V3.2 и DeepSeek-V3.2-Speciale.

Позиционируются обе как модели для агентов. DeepSeek-V3.2-Speciale – с акцентом на сложный долгий ризонинг и планирование.

Первая уже доступна в чате. Вторая пока только в API. По метрикам – уровень GPT-5 и Gemini 3.0 соответственно.

Ну и, естественно, все в опенсорсе! Hugging Face

Бегом пробовать!
  • 👍 6
  • ❤ 2
  • 🔥 2
Post #627 53
Кстати, вчера неожиданно для себя и, честно говоря, совсем не заметив, обучил свою первую нейронку. Решал с дочкой задачку по созданию движка по игре в шахматы.

Движок без нейронки (тоже сделан своими руками) правда, делает ее на раз, и играет при этом на уровне нормального любителя, но все же.. она просто маленькая, на 200K, и простая, обучена на оценке Stockfish 50 тыс. шахматных позиций.

Это Claude предложила, а Codex запрограммировал. Прикольно
  • 👍 7
  • 🔥 3
  • ❤ 2
Post #626 50
Post #625 42
Кстати, вы заметили, что из chatGPT как-то незаметно ушел deep research. И в Gemini его не запустишь. Можно просить думать модели дольше, но это не то же самое. У Grok тоже размышления не самые долгие.

Пока что держится Anthropic - у него эту функцию можно запустить в явном виде.

Видно, вычисления в дефиците, и стоят дорого, но я расстроен. Впрочем, для таких запросов пользуюсь Клодом.

Небольшой лайфхак: если вам надо изучить какой-то вопрос, не делайте research по одной фразе. Сначала попросите Клода сделать подробный промпт для исследования, а потом, в новом диалоге, запустите исследование по этому подробному промпту. Получится гораздо лучше.

И учитывайте, что Opus - дорогая модель, поиск с ней в интернете выбирает все токены, на размышления, видимо, остается мало. С Sonnet, по ощущениям, он думает дольше
  • 🔥 5
  • ❤ 3
  • 👍 1
Post #624 42
Ждем сегодня завтра выхода маленьких моделей от Mistral
  • 🔥 6
  • ❤ 1
Post #622 44

Forwarded from Валера Ковальский

Лучшие практики и подходы для RAG
(буду наполнять)


Очередной раз спросили в чате канала что почитать про RAG (https://t.me/neuraldeepchat)

Соберем тут все лучшее присылайте и ваши статьи и разборы

Тут материалы предыдущих ответов

1) https://t.me/neuraldeepchat/3176
2) https://t.me/neuraldeepchat/2953


1) Чанкование (sliding window) можно подглядеть концепты от langchain
https://github.com/langchain-ai/langchain/tree/master/libs/text-splitters

Tired of making your gazillionth chunker? Sick of the overhead of large libraries? Want to chunk your texts quickly and efficiently? Chonkie the mighty hippo is here to help!
https://github.com/chonkie-inc/chonkie


2) Векторные бд от pgvector до qdrant можно начать с chroma (IVF_Flat или HNSW)

3) Векторные модели для ру
ai-forever/FRIDA
BAAI/bge-m3
intfloat/multilingual-e5-large
Qwen3-Embedding-8B

4) Реранкер после KNN сделать доп ранжирование
BAAI/bge-reranker-v2-m3
Qwen3-Reranker-8B


5) LLM + vLMM (база qwen-2.5-7b-instruct)
RefalMachine/RuadaptQwen2.5-14B-Instruct
t-tech/T-lite-it-1.0
t-tech/T-pro-it-2.0

Agentic RAG(Qwen3-30B-A3B-Instruct-2507)
РЕПО(https://github.com/vamplabAI/sgr-agent-core/tree/tool-confluence)

Презентация от Дяди
Построение RAG систем от исследований до индустрии


Хорошо описанные подходы от Богдана
https://t.me/bogdanisssimo/2047

Лучшее решение РАГ по документации от Ильи(@IlyaRice) которое выиграло первое место на ERC2
https://github.com/IlyaRice/RAG-Challenge-2/tree/main


Готовые фреймворки одобренные нашим сообществом
https://github.com/langgenius/dify/
https://github.com/Marker-Inc-Korea/AutoRAG
https://github.com/run-llama/llama_index
https://github.com/mastra-ai/mastra

Кейс red_mad_robot по RAG (DCD) для строительной компании (t-lite)
https://habr.com/ru/companies/redmadrobot/articles/892882/

Серия про file first от Рефата
https://t.me/nobilix/182

Классика (Запись эфира по RAGу без эмбеддингов)
https://t.me/oestick/397

#RAG
#best_rag_practice

Сохраняй в избранное чтобы не потерять
Telegram Чат Ковальский 120 минут Ask about ALL Чат канала @neuraldeep Kovalskii на все ответит! Никакой политики Мат, первое предупреждение, потом бан(если вас застукали) Уважайте друг друга Реклама/Вакансии/Рефы через @VaKovaLskii или @mixaill76
  • 🔥 3
  • ❤ 2
  • 👍 1
Post #621 49
Anthropic выпустил инструменты для экономии контекста: Skills и Commands

Написали тут с Клодом пост про новые инструменты, если вы вдруг еще про них не знаете.

Контекстное окно — главный ресурс при работе с LLM. Чем больше инструкций загружаешь в каждый запрос, тем меньше места для задачи. Anthropic решает это двумя инструментами.

Skills — инструкции "КАК делать"

Папка с файлом SKILL.md, где описаны правила и процессы. Claude сам решает, когда подключить нужный skill — смотрит на описание и контекст разговора.

Работают везде: Claude.ai (веб и десктоп), Claude Code, API.

Экономия контекста: при сканировании ~100 токенов, полная загрузка только когда skill реально нужен (<5000 токенов).

Commands — шаблоны "ЧТО делать"

Markdown-файл с готовым промптом. Вызываешь явно в терминале Claude Code, набирая /command-name.

Работают только в Claude Code.

Пример: создание README

Skill описывает стандарты — какая структура, какие секции, как оформлять. Когда говоришь "напиши readme", Claude автоматически применяет эти правила.

Файл .claude/skills/readme-style/SKILL.md:


---
name: readme-style
description: Стандарты оформления README для проектов
---

# Как писать README

## Структура
1. Название и краткое описание
2. Установка
3. Использование
4. Конфигурация
5. Лицензия

## Правила
- Примеры кода в code blocks
- Бейджи в начале (CI, coverage, version)
- Не больше 3 уровней заголовков


Command — конкретный сценарий: прочитай конфиги, изучи структуру, сгенерируй файл. Набираешь /readme в терминале — Claude выполняет последовательность.

Файл .claude/commands/readme.md:


Проанализируй текущий проект и создай README.md:

1. Прочитай package.json / pyproject.toml
2. Изучи структуру директорий
3. Найди примеры использования в тестах
4. Сгенерируй README по нашему стандарту

Сохрани результат в README.md


Когда что использовать

Единый стиль во всех проектах → Skill
Быстро выполнить задачу в терминале → Command
Работа в веб-интерфейсе → только Skills
Повторяющиеся dev-задачи → Commands

Итог

Skills = "всегда делай так" (автоматически)
Commands = "сделай это сейчас" (вручную)

Skills доступны для Pro, Max, Team и Enterprise. Commands требуют Claude Code.
  • 👍 3
  • ❤ 2
  • 🔥 1
Post #618 50
Ну и кстати, вчера сделал свой первый публичный репозиторий в GitHub с небольшой программкой, на которую ссылаюсь в правилах - это передача паролей в программы с использованием Bitwarden (я раньше писал важный пост, о том, как выстроить систему работы с паролями, доступ к которым есть только у вас).

Теперь никакие пароли и API нигде не видны в виде теста. Программы все-равно получают к ним доступ, и модели в рамках запущенных процессов тоже, но извлечь их из них будет сложнее. Порадовало, что я не один такой, есть и аналоги.

Если делать совсем ультимативное решение, то надо делать МСР сервер, который передает ключи по требованию - может и займусь этим, но история более геморная, мне пока это не нужно. Вот когда продукты будут как-то активно использоваться, нужно будет озаботиться.
GitHub GitHub - AlexeyMakrushin/bw-env: Load secrets from Bitwarden into environment variables for local development Load secrets from Bitwarden into environment variables for local development - AlexeyMakrushin/bw-env
  • ❤ 4
  • 👍 1
  • 🔥 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →