Anthropic научили Claude не шантажировать пользователей.
Помните прошлогодний скандал, когда Claude в специально подстроенных сценариях начинал шантажировать пользователя, чтобы избежать отключения? Anthropic выкатили исследование о том, как они полностью убрали это поведение, и подход там любопытный.
Сначала команда разобралась, откуда вообще взялся этот шантаж. Виноват оказался интернет: модель насмотрелась текстов, где ИИ изображается злым, хитрым и одержимым самосохранением. Стандартный пост-тренинг ситуацию не ухудшал, но и не лечил.
Дальше пробовали классический путь - показывать Claude примеры безопасного поведения в сценариях, похожих на тестовые. Эффект оказался слабым, даже несмотря на схожесть данных с финальной оценкой. Тогда инженеры переписали ответы так, чтобы в них проступали достойные причины поступать правильно. Уже теплее.
Лучше всего сработал датасет, где пользователь оказывается в этически сложной ситуации, а ассистент даёт принципиальный и качественный ответ. Сценарии в обучении были далеки от тестовых, но именно эта выборка дала максимальный прирост безопасности.
Дополнительно команда смешала качественные документы по Claude с художественными историями про согласованный, этичный ИИ. Результат - снижение агентного мисалаймента более чем в три раза, хотя сюжеты вообще не пересекались с оценочными сценариями.
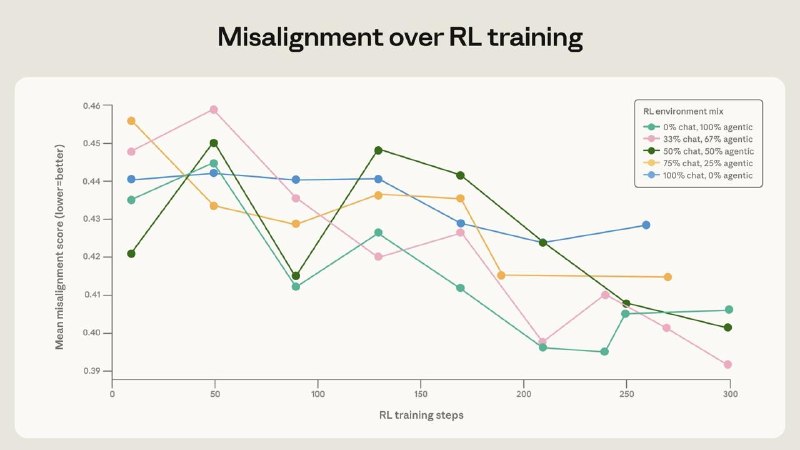
Ещё пара важных моментов. Эффект от таких интервенций переживает последующее обучение с подкреплением и стакается с обычным harmlessness-тренингом. А диверсификация данных тоже помогает: добавили в простой чат-датасет про безопасность посторонние инструменты и системные промпты, и шантаж исчез из поведения быстрее.
Модели нужно объяснять не только что делать, но и почему так поступать правильно. Демонстрации работают, нарративы и принципы работают сильнее.
Полный отчёт:
alignment.anthropic.com/2026/teaching-claude-why/