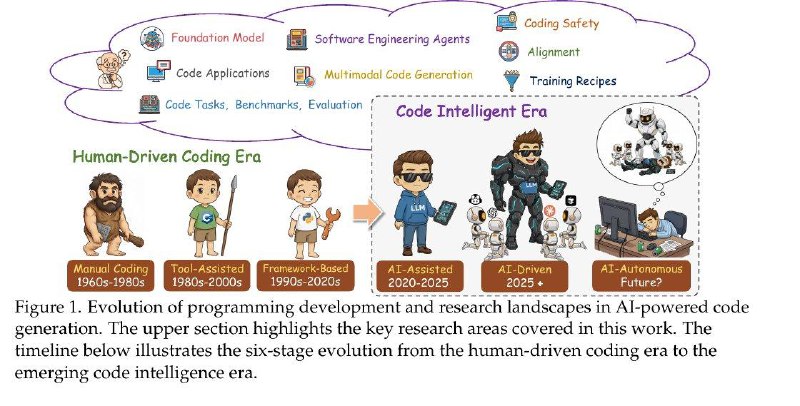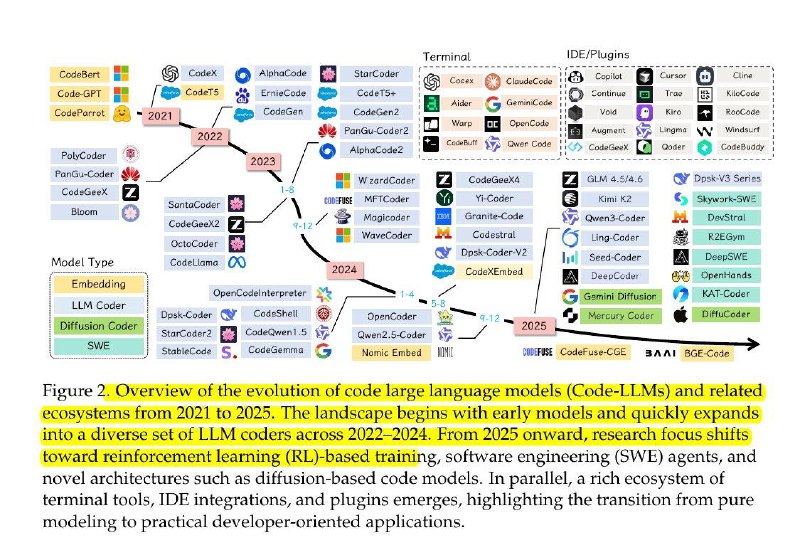
🔭 Вышло огромное исследование на 303 страницы от ведущих китайских лабораторий — подробный разбор того, как создают и обучают модели, ориентированные на написание кода, и как на их основе строят полноценные софт-агенты.
Вот что в нём разбирается:
1. Как формируют модель
- Сбор и очистка гигантских датасетов кода.
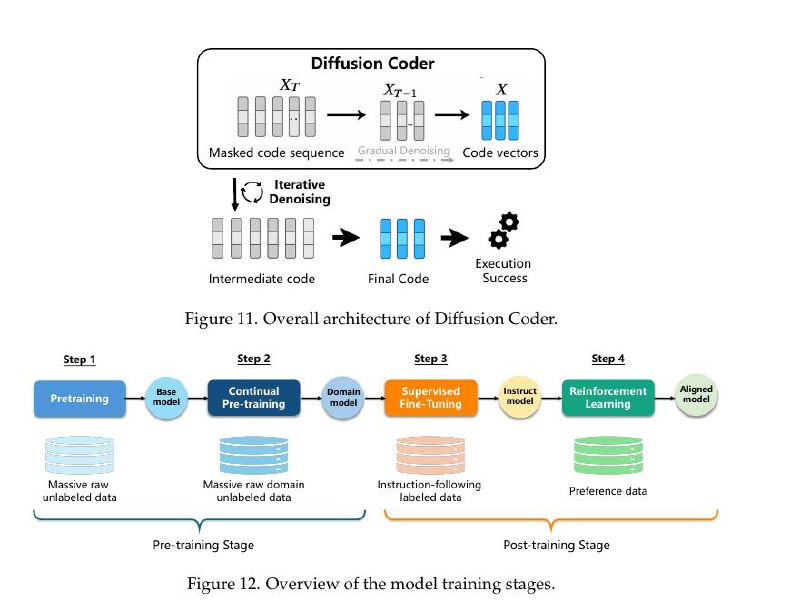
- Предобучение: модель впитывает реальные паттерны программирования в промышленных масштабах.
- SFT и RL: дополнительные этапы, где модель учат лучше следовать инструкциям, проходить тесты и избегать очевидных ошибок.
2. Как модели превращают в инженерных агентов
- Агент читает баг-репорт или фичу.
- Планирует шаги.
- Меняет файлы.
- Запускает тесты.
- Повторяет цикл, пока не добьётся результата.
3. Какие проблемы всё ещё остаются
- Работа с огромными репозиториями.
- Безопасность и надёжность генерируемого кода.
- Корректная оценка качества работы агентов.
- Реальные приёмы и лайфхаки, которые используют текущие команды.
Исследование - мощный срез состояния индустрии: от датасетов и архитектур до практических инженерных пайплайнов. Это именно то, как современные LLM превращаются в «второго разработчика» в команде.
https://arxiv.org/abs/2511.18538
@data_analysis_ml
Post #651
41
Forwarded from Анализ данных (Data analysis)