


⚡️ Вышел DeepSeek-Math-V2
С релиза первой версии прошло почти два года. Новую уже никто и не ждал, но релиз, как это часто бывает в случае с DeepSeek, наступил внезапно.
Сразу кратко о результатах:
– Уровень золотой медали на IMO 2025 и CMO 2024 (Chinese Mathematical Olympiad).
– Почти идеальный результат 118/120 на Putnam 2024. Это сверхсложная математическая олимпиада для студентов университетов США и Канады.
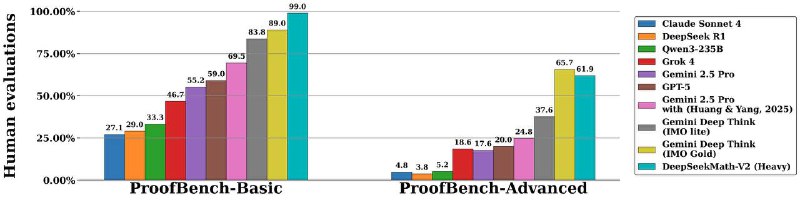
– Бенчмарков мало, нет ни MATH, ни GSM8K, ни AIME, вообще почти ничего. Это странновато, но можно пока посмотреть на сравнения с другими моделями на IMO-ProofBench. Видно, что модель довольно уверенно бьет GPT-5 и на сложных задачах выходит на уровень с Gemini 2.5 Pro. Опять же, интересно, что там с Gemini 3, Grok 4 и GPT-5.1.
Теперь заглянем под капот.
Система основана на DeepSeek-V3.2-Exp-Base. Пайплайн состоит из генератора и верификатора.
Доказательство или решение формируется не за раз, а в результате нескольких проходов и улучшений: большая модель генерирует решение -> оно отправляется в модель-верификатор, где тщательно проверяется каждый шаг и ищутся ошибки -> обратная связь от верификатора возвращается генератору -> так доказательство переписывается и улучшается до 16 раз.
При этом в каждой итерации используются и проверяются сразу несколько (до 64) гипотез и вариантов решения. Получается сотни прогонов для одной задачи. Такое вот умное структурированное масштабирование test-time компьюта.
Сколько стоило решение олимпиады – не раскрывают, но видимо немало. Судя по всему, поэтому результатов по бенчмаркам и нет: денег не хватило 😭
Веса | Статья | Репозиторий
Post #606
43