📌Скорость решает все: обзор эффективных архитектур для LLM.
Ландшафт архитектур LLM превратился в настоящий зоопарк. Почти каждую неделю появляются новые методы, обещающие меньший расход памяти и более быстрый инференс. Разобраться в этом становится все сложнее.
Большая группа исследователей выпустила подробный обзор Speed Always Wins, чтобы систематизировать все ключевые инновации в области эффективных архитектур для LLM.
Это не просто очередная статья, а попытка упорядочить и структурировать актуальные подходы, которые решают главную проблему классического трансформера - его квадратичную вычислительную сложность.
Обзор описывает 7 основных направлений.
🟡Линейное моделирование последовательностей.
Здесь авторы разбирают все подходы, которые так или иначе сводят сложность самовнимания к линейной. В эту категорию попадают 3 большие ветви: линейное внимание; линейные RNN, вроде и, конечно, модели на основе пространства состояний (SSM).
🟡Второе и третье направления посвящены идее разреженности.
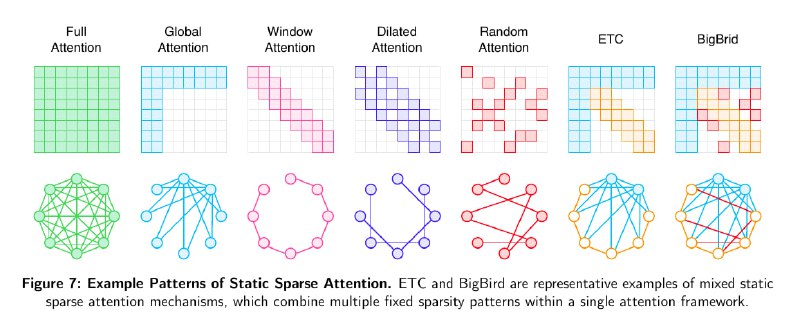
Разреженное моделирование последовательностей основано на простом принципе: не каждый токен должен общаться с каждым. Здесь выделяются статические подходы (как в Longformer), где паттерны внимания заданы заранее, и динамические, где они определяются на лету в зависимости от контента.
🟡MoE.
Методика, которая уже стала мейнстримом. В МоЕ разреженность применяется не в механизме внимания, а в FFN-слоях, где для каждого токена активируется лишь небольшая часть экспертов, что позволяет наращивать число параметров без пропорционального роста вычислений.
🟡Четвёртый раздел - эффективное полное внимание.
В нем речь идет не об изменении асимптотической сложности, а об ее аппаратной оптимизации. Флагман - FlashAttention.
Есть детальный разбор, как за счет оптимизации обращений к памяти GPU удается кардинально ускорить вычисления, не прибегая к аппроксимациям. Сюда же относятся и групповые механизмы внимания: GQA и MQA.
🟡Гибридные архитектуры.
Это, пожалуй, самый горячий тренд. Его идея в том, чтобы стратегически комбинировать быстрые слои с линейной сложностью и медленные, но мощные слои с полным вниманием.
В обзоре выделяют два типа гибридизации: межслойную, как в Jamba, где разные типы слоев чередуются, и внутрислойную, где в одном слое разные головы могут использовать разные механизмы внимания.
🟡Диффузионные LLM (DLLM)
Это неавторегрессионные модели, которые генерируют текст, постепенно восстанавливая его из шума. Их главная фишка в параллельном декодировании, что дает ощутимое ускорение инференса.
В конце обзора есть анализ применения всех этих архитектур в разных модальностях - CV и аудио.
Так что, если хотите быстро разобраться в базовых методах, которые будут двигать дизайн LLM в ближайшее время, а двигаться он будет в сторону микширования алгоритмов, систем и железа, этот обзор - мастрид.
🟡Arxiv
🖥GitHub
@ai_machinelearning_big_data
#AI #ML #LLM #Architectures
Post #281
31
Forwarded from Machinelearning