TGViewer
Channel Public Channel
CV Time

CV Time

@timeforcv

Канал о компьютерном зрении от ml-специалистов Яндекса: разбор актуальных статей, горячие обсуждения и личный опыт из первых рук. Присоединяйтесь!

Вопросы и предложения > @yandex_ml_brand
Subscribers
3.47K
Photos
264
Videos
6
Links
144

Showing posts older than #106 · Back to latest

Older Posts 7 shown
Post #98 2.45K
Подборка интересных постеров и статей с ICLR 2025. Часть 1

Наши корреспонденты уже принесли обзоры работ первого дня конференции, 24 апреля. Пишите в комментариях, какие идеи зацепили и о чём ещё хотите узнать.

Eagle: Exploring The Design Space for Multi-modal LLMs with Mixture of Encoders
Авторы из NVIDIA исследуют, как использование нескольких предобученных vision-энкодеров помогает моделям лучше справляться со сложными визуальными задачами, такими как OCR и анализ документов. Каждый энкодер обучали отдельно с зафриженной 7B моделью Vicuna. На заключительных этапах объединяли все экодеры и обучали финальную модель.

Heavy Tailed Diffusion Models
У распределения картинок тяжёлый хвост, у нормального — лёгкий. Есть теоретическое обоснование, что из-за липшицевости нейросети диффузионка не может генерировать из распределения с лёгким хвостом распределение с тяжёлым.

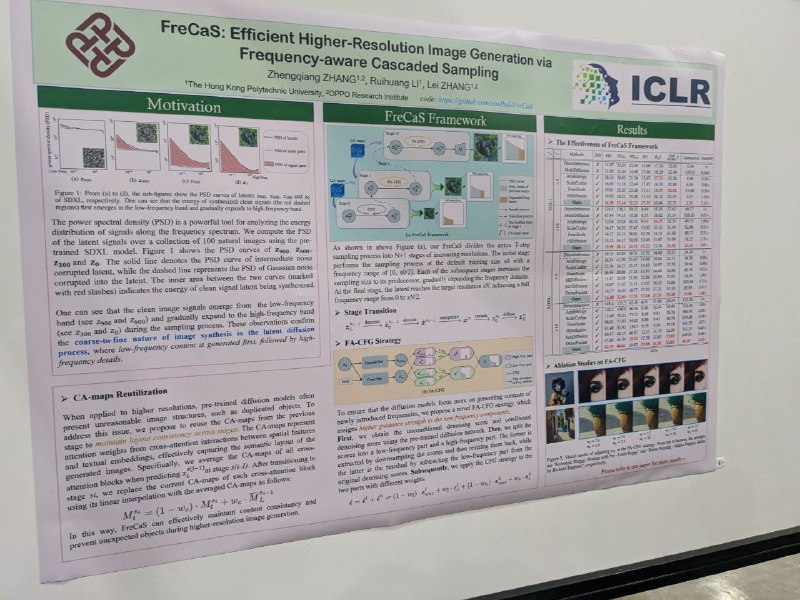
FreCaS: Efficient Higher-Resolution Image Generation via Frequency-aware Cascaded Sampling
Генерируют картинки 2048 на основе модели, предобученной для 1024. На каждой стадии используется одна и та же модель, на ood-разрешениях подменяются аттеншн-мапы.

FORTE: Finding Outliers using Representation Typicality Estimation
Сделали фреймворк для автоматического нахождения аутлайеров в данных. Достаточно дать данные и несколько референсных точек, и можно будет получить оценку аутлайерности. Может быть полезно, например, для нахождения фото в карточках организации, которые к организации не имеют отношения.

Painting With Words: Elevating Detailed Image Captioning with Benchmark and Alignment Learning
Валидируют image captions, разбивая на крошечные утверждения и валидируя GPT (точность 85+), потом собирают два реворда на полноту и точность — пыщ-пыщ — профит.

Captured by Captions: On Memorization and its Mitigation in CLIP Models
Разработали метрику для выявления неправильно аннотированных текстов для обучения clip'a. Утверждают, что хороший буст качества даёт группировка мисанноипованных (неправильно аннотированных) картинок в один батч.

F³Set: Towards Analyzing Fast, Frequent, and Fine-grained Events from Videos
Находят события на сложных видео с блюром и быстрыми изменениями, например спортивных трансляциях. Архитектура: детектор ивента, классификатор ивента, блендим и в GRU. Может быть полезно, чтобы найти красивый кадр на превью пользовательских видео.

WeatherGFM: Learning A Weather Generalist Foundation Model via In-context Learning
Предлагают учить одну модельку под все погодные задачи. И при этом задавать визуальным промптом, что именно модели необходимо сделать: наукаст, сегментацию спутника и прочее. На первый взгляд, выглядит прикольно, но из погодных моделей сравниваются только с IFS и ClimaX.

High-Dynamic Radar Sequence Prediction for Weather Nowcasting Using Spatiotemporal Coherent Gaussian Representation
Идея статьи в том, чтобы представить 3D-информацию об осадках с помощью набора гауссиан, а потом их преобразовывать, чтобы получить наукастовый прогноз. Потом из новых гауссиан восстанавливается финальное поле осадков. Правда extreme-ивенты авторы не рассматривают.

Интересные постеры увидели ❣ Александр Шишеня, Пётр Вытовтов, Иван Балашов, Сергей Овчаренко, Денис Асонов
CV Time

#YaICLR
  • 🔥 12
  • 👍 6
  • ❤ 3
Post #95 1.59K
Чемодан — аэропорт — иии… Нас встречает бананово-лимонный Сингапур! А уже завтра стартует ICLR`25.
  • ❤ 29
  • 🔥 18
  • 👍 2
Post #94 1.99K
Lost and Found: Overcoming Detector Failures in Online Multi-Object Tracking

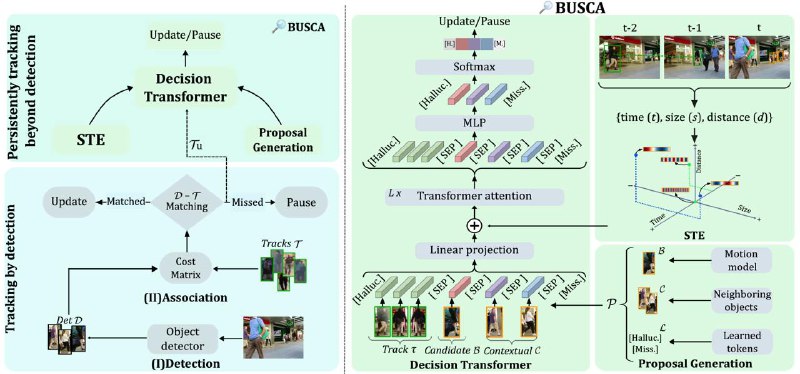
Сегодня разбираем статью с ECCV’24, в которой предложили метод улучшения онлайн-трекинга BUSCA. Это надстройка над любыми современными трекерами в парадигме Tracking-by-Detection (TbD), помогающая не терять треки при пропуске объектов детектором.

В подходах TbD объекты сначала детектируют, затем соотносят с существующими треками. Проблема в том, что даже лучшие детекторы периодически теряют объекты, особенно при их низкой видимости. Из-за этого треки прерываются. BUSCA решает эту проблему, продолжая треки даже без детекций.

Архитектура BUSCA

В основе метода — Decision Transformer, работающий полностью в онлайн-режиме (без изменения прошлых результатов или доступа к будущим кадрам).

После стандартного сопоставления детекций с треками, несматченные треки обрабатываются BUSCA, которая анализирует:

— Candidate proposal B: прогнозируемую позицию объекта с помощью фильтра Калмана;

— Contextual proposals C: Q=4 ближайших объекта из успешно отслеживаемых треков на текущем кадре (для учёта окружения);

— Learned tokens L: специальные токены [Halluc.] для обнаружения искажённых треков и [Miss.], когда объект покинул сцену или все предложения неподходящие.

Обработка токенов различается:

- Трековые наблюдения (несколько последних наблюдений из несматченного трека), Candidate и Contextual proposals проходят через ResNet-50 для извлечения 512-мерных визуальных признаков;
- Learned tokens и разделительный токен [SEP] инициализируются случайно и обучаются совместно с остальной архитектурой.

Все токены получают специальное пространственно-временное кодирование (STE), отражающее относительные время, размеры и расстояние до последнего наблюдения трека.

Затем Decision Transformer обрабатывает все токены вместе. Полученные представления предложений проходят через MLP-слой для генерации их вероятностей. Если выбирается candidate B — трек продолжается с обновлёнными координатами, в остальных случаях — ставится на паузу.

Эксперименты

BUSCA особенно эффективна для объектов с низкой видимостью и увеличивает среднюю длину треков. Метод обучался только на синтетических данных (MOTSynth) и работает со скоростью около 45 мс на кадр на NVIDIA RTX GPU.

BUSCA протестирована на пяти трекерах (ByteTrack, StrongSORT, GHOST, TransCenter, CenterTrack) и улучшила все ключевые метрики на MOT16, MOT17 и MOT20.

Разбор подготовила ❣ Мария Поклонская
CV Time
  • 👍 11
  • ❤ 6
  • 🔥 2
Post #89 2.07K
Личный опыт инженеров Яндекса — Дмитрий Баранчук

Продолжаем рассказывать об ML-инженерах и исследователях в Яндексе. Сегодня о своих задачах, успехах и профессиональных ожиданиях рассказал руководитель команды исследователей по генеративному CV в Yandex Research.

Работы, о которых Дима говорит в карточках:

— Switti: Designing Scale-Wise Transformers for Text-to-Image Synthesis;
— Invertible consistency distillation for text-guided image editing in around 7 steps.

Больше карточек — по хештэгу #YaMLpeople.

CV Time
  • ❤ 21
  • 🔥 6
  • 👍 2
Post #88 2.03K
PartEdit: Fine-Grained Image Editing using Pre-Trained Diffusion Models

Сегодня разбираем статью о редактировании изображений. Авторы показывают, как с помощью предобученной диффузионной модели SDXL можно детально изменять заданные сегменты на изображении.

Предложенный метод требует обучения токенов частей картинки на датасете, где для каждой картинки и целевого токена есть маска, соответствующая области, которую нужно изменить. В промпт подаются два токена, например: <head> (токен головы) и <BG> (бэкграунд для головы). Причём токен бэкграунда (<BG>) уникален для каждого целевого токена.

Дальше токены обучаются так, чтобы маски аттеншна в SDXL давали маски сегментации нужной части картинки. При этом сама диффузионная модель остается замороженной, обучаются только токены.

Авторы отдельно изучают, в каком диапазоне (от 0 до 50, где 0 — почти чистое изображение, а 50 — максимально зашумлённое) лучше брать усреднение. При обучении на таймстемпах [50, 40] маски получаются некачественные. В диапазоне [30, 20] результат лучше. При [10, 0] — чуть хуже, чем на среднем.

Когда эмбеддинги выучены, происходит редактирование. В случае с синтетическими изображениями используются три ветки:

1. Генерация исходного синтетического изображения. Например, по промпту "A closeup of a man" в качестве промпта подаётся, например, "A closeup of a man", где мы хотим заменить голову человека на голову робота. SDXL генерирует изображение и при этом сохраняется траектория — промежуточные латенты для каждого таймстемпа.

2. Средняя часть архитектуры работает как сегментатор: в SDXL подаются только два выученных эмбеддинга: части, которую нужно отредактировать и бэкграунда. В нашем примере это будет <head> и <BG>.

Для каждого таймстемпа собираются все маски аттеншна со всех слоёв (предварительно приводятся к одному размеру и агрегируются). Затем применяется алгоритм OTSU, который вычисляет локальный порог: если значение больше порога — это единица, если меньше — ноль, а в промежутке от 1/2K до 3/2K маска просто сохраняется.

3. Генерация отредактированного изображения: через SDXL прогоняются выученные эмбеддинги того, что нужно заменить (например, чтобы получить "A closeup of a man with robotic <head>").

На этапе редактирования фичемапы с исходного и редактирующего прогона блендятся с помощью предобработанных масок аттеншна из второй ветки. В конце прогона получается отредактированное изображение: нужная часть изменена, остальное — как в оригинале.

Решение применимо не только к синтетическим, но и к реальным изображениям: с помощью методов инверсии LEDIT++ и EF-DDPM получают латенты, а с помощью BLIP2 — промпт-описание исходной картинки.

В сравнениях с другими подходами в качестве метрики используется Alpha-CLIP: по маске определяется область редактирования, а с помощью CLIP считается, насколько результат соответствует заданному промпту. Как водится — по всем метрикам результаты превосходят конкурентов.


Разбор подготовил ❣ Александр Шишеня
CV Time
  • ❤ 7
  • 👍 5
  • 🔥 3
Post #87 5.27K
Тематическая подборка статей: генерация

Подобрали свежие статьи о генеративных моделях. В этот раз — обсуждают, как улучшить токенизацию для диффузионных моделей, дистиллировать CFG и оптимизировать обучение генератора. А ещё есть работа о том, как интерпретировать внимание в Diffusion Transformers и использовать его для сегментации.

Автоэнкодеры

Reconstruction vs. Generation: Taming Optimization Dilemma in Latent Diffusion Models
Авторы говорят, что увеличение числа каналов в автоэнкодере улучшает реконструкцию (что логично), но делает задачу для генератора более сложной, приводя к ухудшению генераций. Предлагают дополнительным лоссом предсказывать признаки от бэкбона (dino/mae/etc) — это делает фичи автоэнкодера более «простыми» для генератора и улучшает его сходимость.

Masked Autoencoders Are Effective Tokenizers for Diffusion Models
Развитие предыдущей работы: связали улучшение качества представления автоэнкодера с уменьшением числа мод в mixture of gaussian модели, и переделали архитектуру автоэнкодера в MAE-трансформер.

Эдитинг

REALEDIT: Reddit Edits As a Large-scale Empirical Dataset for Image Transformations
В статье предлагают парсить Reddit для сбора датасета по эдитингу картинок: брать треды, где пользователи просят отфотошопить их картинки. Отбирают посты до 2021 года, чтобы в них не было применения AI.

Ускорение

DICE: Distilling Classifier-Free Guidance into Text Embeddings
Авторы говорят, что можно дистиллировать Classifier-Free Guidance (CFG), включая negative prompt, в небольшую нейронку поверх текстовых эмбеддов.

Visual Generation Without Guidance
В статье предлагают алгоритм обучения генератора, для которого потом не нужно делать CFG. Заявляют, что это работает лучше, чем дистилляция.

RL

Calibrated Multi-Preference Optimization for Aligning Diffusion Models
Исследователи из Google предлагают метод, который, по их утверждению, лучше, чем Direct Preference Optimization (DPO), благодаря аккуратному выбору пар для обучения и более хитрой функции потерь.

Diffusion Model as a Noise-Aware Latent Reward Model for Step-Level Preference Optimization
Предлагают делать RL непосредственно в латентном пространстве — для этого нужна reward-модель, способная в нём работать. Говорят, что идеально подходит предобученная диффузионная модель, которую можно дообучить на предсказание reward’а. Утверждают, что это упрощает пайплайн обучения и улучшает финальное качество.

Другое

ConceptAttention: Diffusion Transformers Learn Highly Interpretable Features
Авторы говорят, что можно использовать предобученную диффузионную модель для получения SOTA сегментационных масок в zero-shot-режиме. Для этого делают надстройку над аттеншн-слоями в DiT'е.

Подборку подготовил ❣ Артём Конев
CV Time
  • ❤ 14
  • 🔥 5
  • 👍 3
Post #85 7.81K
FoundationStereo: Zero-Shot Stereo Matching

Сегодня разбираем статью от NVIDIA. Исследователи решают задачу определения глубины по двум изображениям, снятым с близко расположенных камер, то есть со стереопары. Камеры смотрят в одном направлении, поэтому каждая 3D-точка попадает приблизительно на одну строку в обеих картинках, но в разных местах. Это позволяет искать соответствия между пикселями одной и той же строки двух изображений, и, используя эти соответствия, восстанавливать глубину сцены.

Определив соответствия между точками на двух изображениях, можно вычислить диспаритет — сдвиг координат пикселя на одной картинке относительно другой. Зная диспаритет, фокусное расстояние и расстояние между оптическими центрами камер, можно пересчитать его в глубину.

Исследователи из NVIDIA говорят, что сейчас нет модели стерео-матчинга, которая бы показывала хорошую zero-shot-генерализацию. Текущие лучшие решения предлагается дообучать на целевой домен.

В других задачах проблему генерализации уже удалось решить за счёт больших данных. Например, Segment Anything обучили на огромном датасете, и модель успешно работает без дообучения. NVIDIA попробовала применить этот же подход к стерео-матчингу. Они собрали фотореалистичный синтетический датасет FSD (картинка 2) из миллиона стереопар, превосходя по объёму и многообразию другие открытые датасеты. Датасет выложен в открытый доступ.

Детали архитектуры

Из левого и правого изображений (картинка 1) извлекаются фичи из Depth Anything, конкатенируются с фичами из отдельной обучаемой свёрточной сети. Из этой пары создаётся feature cost volume — объём фичей, где каждая описывает похожесть пикселя на левой картинке на пиксели в той же строке на правой картинке и корреляционный cost volume, где похожесть пикселей описывается единственным числом.

Такие cost volume’ы уже можно использовать для поиска диспаритета, но в них недостаёт глобального контекста картинок. Чтобы его добавить, применяется операция AHCF (Attentive Hybrid Cost Filtering), особенность которой — использование информации из всего cost volume для получения значений в финальном пикселе выходного тензора; это делается с помощью глобального внимания в transformer-ветви AHCF и с помощью аналога separable-свёрток в свёрточной ветви AHCF. Изменение по ablation даёт 10% улучшения по метрике BP-2: доля пикселей, где ошибка диспаритета больше 2 пикселей (0.221 → 0.197).

Дальше процесс похож на описанный в RAFT-Stereo, но с некоторыми отличиями. В RAFT-Stereo сеть получает на вход hidden state и срез из correlation cost volume. В Foundation Stereo получает срезы из correlation cost volume и feature cost volume.

Таким образом, вход в GRU включает:

— срез cost volume в соответствии с текущей оценкой диспаритета;
— фичи левой картинки из отдельно обучаемой контекстной сети (так делалось и в RAFT-Stereo);
— саму текущую оценку диспаритета.
GRU обновляет внутреннее состояние и предсказывает поправку, итеративно уточняя диспаритет.

Детали обучения

Модель обучается на смеси FSD-датасета и других датасетов с smoothed L1-лоссом и экспоненциально затухающими L1-добавками для оценок на диспаритет с разных итераций GRU-юнита.

Данные из FSD дополнительно фильтруют по BP-2, используя эту же модель, обученную на полном FSD-датасете, а затем обучают ёще раз.

Интересное из ablation study:

— использование Depth Anything фичей как входов в feature cost volume не работает совсем (по метрике BP-2);
— в separable-свертках для фильтрации feature cost volume используется ядро размера 17(!) по размерности диспаритета (но 1 по spatial-размерности);
— добавление FSD-датасета в обучение даёт BP-2 на датасете Middlebury в два раза лучше, чем без него.

Разбор подготовил ❣ Леонид Штанько

CV Time
  • 🔥 12
  • ❤ 7
  • 👍 7
  • 👀 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →