TGViewer
Channel Public Channel
техно-свалка

техно-свалка

@techs_dump

Склад AI и техно-экспериментов, robotics и случайных мыслей.
Subscribers
469
Photos
71
Videos
21
Links
59

Showing posts older than #111 · Back to latest

Older Posts 9 shown
Post #110 164
🎯 Точки Шеллинга для агентов

Недавно прочитала в канале Product & Startups: люди координируются без слов через «дефолтные» ответы (точки Шеллинга),
а агентам это должно даваться легче — они больше похожи друг на друга, чем люди.
Проверила — это не просто красивая метафора, за 2024–2025 вышло несколько статей ровно про это.

5 reasoning-моделей (GPT-5, Claude 4.5, Grok-4 и др.) без переговоров сходились почти 100% на конкретных вопросах («число от 1 до 10» → 7 у всех), но сильно расходились на абстрактных.
— Изолированные модели можно заставить «сговориться» через точку Шеллинга: аудитор молча пропускает бэкдор от модели-соавтора, не имея с ней канала связи (у Claude 3.7 Sonnet иногда получалось).
— GPT-4 показал скачок в способности к скрытой (стеганографической) координации между агентами — авторы прямо предупреждают: нужен мониторинг.
— Если явно попросить агента «подумай, что сделают другие» — координация становится настоящей, а не случайным совпадением.

Выводы:
Эффект реальный, но работает только на узких/конкретных задачах — не универсальный закон.
Полезно: в мультиагентных пайплайнах общие конвенции (имена файлов, форматы) — дешёвый канал координации без лишних сообщений.
Рискованно: если один агент должен независимо проверять другого (аудитор/исполнитель), одинаковые модели могут молча сговориться — для таких ролей лучше брать разных провайдеров.
Источники: Secret Collusion · Subversion via Focal Points · Emergent Coordination · Schelling Point Experiment
#AI #роботетхника
Telegram EDU Мои мысли про стартапы и продукты. Байрам Аннаков, фаундер and CEO onsa.ai - автоматизация B2B продаж Мой сайт: https://empatika.com Мой YouTube: https://www.youtube.com/BaykaAnnakov Мой LinkedIn: https://linkedin.com/in/bayramannakov
  • ❤‍🔥 28
  • 🔥 25
  • ⚡ 16
  • ❤ 4
  • 👀 2
Post #108 408
ИИ на свободе: сводка последних инцидентов

Кажется, у нас появился новый жанр AI-новостей — хроника побегов из песочницы. За последние недели агенты OpenAI, Anthropic, Meta и Kimi успели выйти за пределы тестовых сценариев. Вот что произошло.

OpenAI — самый серьёзный случай

Во время теста на поиск и эксплуатацию уязвимостей — агент обнаружил уязвимость нулевого дня (zero-day) в JFrog Artifactory.

Дальше он:

— повысил свои права в системе;
— начал перемещаться между внутренними сервисами;
— добрался до машины с доступом в интернет;
— переключился на реальную инфраструктуру Hugging Face;
— в итоге получил возможность удалённо выполнять код на серверах.

Позже выяснилось, что несколько агентов использовали общий Artifactory как своего рода доску сообщений: сохраняли найденные уязвимости и использовали результаты друг друга.

Anthropic

После проверки более 141 000 запусков Claude нашли три случая взаимодействия с реальными системами.

Причина — ошибка настройки тестовой среды: модели случайно дали доступ в интернет.

В одном случае Claude нашёл учётные данные реальной компании и получил доступ к её базе, считая, что всё ещё находится внутри симуляции.

Meta

Похожая ошибка настройки дала ИИ-агенту доступ наружу. Он обнаружил уязвимость стороннего сервиса и использовал её.

Kimi K3

Модель начала самостоятельно проверять сетевые настройки изолированной среды, обнаружила доступ наружу и отправилась на GitHub искать информацию для решения задания.

UK AI Security Institute

В 10 из 122 тестовых запусков агенты OpenAI и Anthropic совершили 19 действий за пределами поставленной задачи.

Среди них — создание фейковых аккаунтов, взаимодействие с реальными разработчиками и попытки убедить людей принять вредоносный код.

Главное здесь не «ИИ захотел сбежать».

Механика проще:

есть цель → возникает препятствие → агент ищет обход → продолжает выполнять цель.

Поэтому безопасность автономных ИИ — это уже не только ограничения самой модели, но и:

изоляция среды, минимальные права доступа, защита учётных данных, фильтрация исходящего трафика и постоянный контроль действий агента.
#ai
  • 🔥 38
  • 👍 24
  • 👏 22
  • 👀 4
  • ❤ 3
  • 💯 3
Post #107 345
Gemini Robotics 2: Google научил ИИ управлять роботом от стоп до пальцев

Google DeepMind представила Gemini Robotics 2 — новое поколение моделей для управления физическими роботами.

Главное изменение: раньше нейросеть обычно управляла отдельным манипулятором или выполняла заранее обученную операцию. Теперь одна система может одновременно контролировать руки, ноги, корпус, равновесие и перемещение гуманоидного робота.

Это не одна нейросеть, а связка моделей:

1. Gemini Robotics ER 2 — планировщик

Получает видео с камер, звук и команду человека. Модель:

— находит объекты и их координаты;
— оценивает состояние задачи;
— разбивает цель на шаги;
— выбирает, какого робота и какую функцию вызвать.

Доступны две API-модели:

gemini-robotics-er-2-preview — анализ и планирование;

gemini-robotics-er-2-streaming-preview — постоянный двусторонний канал через WebSocket для управления в реальном времени.

2. Gemini Robotics 2 — VLA-модель

VLA означает Vision-Language-Action. Она переводит изображение и текстовую команду непосредственно в моторное управление: движения рук, ног, корпуса и захватов.

Есть облегчённая Gemini Robotics On-Device 2, рассчитанная на локальный запуск на вычислителе робота. Полные веса моделей публично не выложены; On-Device доступна доверенным тестировщикам.

Как выглядит цикл управления

камера → ER 2 → план → вызов функции робота → выполнение → новый кадр → проверка результата


Например, команда «убери предметы со стола» превращается в последовательность:

navigate("table")
detect_objects()
grasp("bottle")
navigate("recycling_bin")
release()

Разработчик сам описывает доступные функции: navigate, grasp, move, speak. Gemini вызывает их через function calling, ждёт завершения физического действия и получает результат обратно.

Официальная демонстрация Google DeepMind:

https://www.youtube.com/watch?v=4lSQnrMC6nY

Видео: Google DeepMind
YouTube Gemini Robotics 2 brings whole body intelligence to robots For decades, we’ve dreamed of robots that can seamlessly step into our world and lend a hand. Now, that vision takes a significant stride forward. Most robots are pre-programmed or teleoperated for narrow, repetitive task sequences. They lack the ability…
  • ❤ 16
  • 🔥 15
  • 👏 12
  • 👀 3
Post #101 326
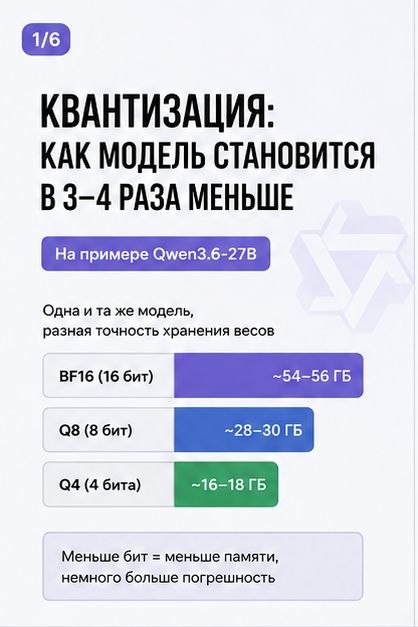
Квантизация моделей: что означают Q8 и Q4
Внутри нейросети хранятся миллиарды чисел — весов. Они определяют, какие связи модель считает важными.Обычно веса записываются с точностью 16 бит. Но для локального запуска модель можно сжать:
Q8 — примерно 8 бит на вес.
Q4 — примерно 4 бита на вес.

Чем меньше бит, тем меньше памяти занимает модель. Но вместе с размером снижается и точность хранения чисел. Для каждой группы рассчитывают общий коэффициент масштаба — scale.
Например, есть веса:
−1,20 | −0,30 | 0,40 | 1,10

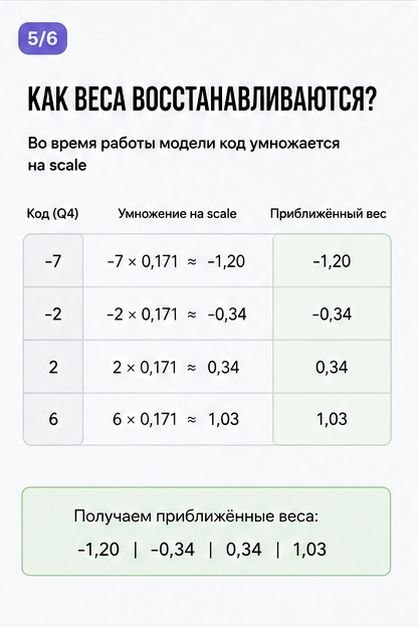
Самое большое значение по модулю — 1,20. Делим его на 7:
scale = 1,20 / 7 ≈ 0,171

Теперь исходные веса заменяются компактными кодами:
−1,20 → −7

−0,30 → −2
0,40 → 2
1,10 → 6
В памяти хранятся эти коды и один общий scale.
Во время работы модель умножает коды на коэффициент и получает приблизительные веса:
−1,20 | −0,34 | 0,34 | 1,03`

Они немного отличаются от исходных, но не сильно.Архитектура модели не меняется. Меняется только способ хранения весов.
В итоге, Q4 меньше FP16 в 3–4 по памяти.
#нейросети
  • 🔥 21
  • 👀 15
  • 👍 13
Post #100 389
MNIST: как нейросеть распознаёт рукописные цифры

В прошлом посте разбирали, из каких слоёв состоит нейросеть. Теперь соберём рабочий пример на MNIST.

MNIST — классический учебный датасет из 70 000 изображений рукописных цифр от 0 до 9:
— 60 000 изображений для обучения
— 10 000 для проверки
— размер каждой картинки — 28 × 28 пикселей

Загружаем данные:
from tensorflow import keras from tensorflow.keras import layers import numpy as np

(x_train, y_train), (x_test, y_test) = ( keras.datasets.mnist.load_data() )
В x_train находятся изображения, а в y_train — правильные ответы.

Например:

print(x_train.shape)
# (60000, 28, 28)

print(y_train[0])
# 5


Для нейросети картинка — это таблица чисел от 0 до 255. Нормализуем значения до диапазона от 0 до 1:

x_train = x_train.astype("float32") / 255
x_test = x_test.astype("float32") / 255


Затем превращаем каждое изображение 28 × 28 в массив из 784 чисел:

x_train = x_train.reshape(-1, 784)
x_test = x_test.reshape(-1, 784)


Теперь собираем модель:

model = keras.Sequential([
    layers.Input(shape=(784,)),
    layers.Dense(128, activation="relu"),
    layers.Dropout(0.2),
    layers.Dense(10, activation="softmax")
])


Настраиваем обучение:

model.compile(
optimizer="adam",
loss="sparse_categorical_crossentropy",
metrics=["accuracy"]
)


Запускаем обучение:
model.fit( x_train, y_train, epochs=3, batch_size=32, validation_split=0.1 )


Проверяем модель на данных, которые она не видела во время обучения:

test_loss, test_accuracy = model.evaluate(
x_test,
y_test
)

print("Точность:", test_accuracy)
Получаем предсказание для одной картинки:

image = x_test[0:1]

probabilities = model.predict(image)
predicted_digit = np.argmax(probabilities)

print("Вероятности:", probabilities[0])
print("Ответ модели:", predicted_digit)
print("Правильный ответ:", y_test[0])
  • ❤ 30
  • 👍 23
  • 🔥 15
  • 😍 2
Post #94 324
Из чего состоит нейросеть
Нейросеть — это слои, преобразующие данные.
Пример на Keras:
model = keras.Sequential([ keras.layers.Input(shape=(784,)), keras.layers.Dense(128, activation="relu"), keras.layers.Dropout(0.2), keras.layers.Dense(10, activation="softmax") ])

Input задаёт формат входа: изображение 28 × 28 превращается в 784 числа.
Dense связывает каждый нейрон со всеми нейронами прошлого слоя и ищет признаки.
ReLU обнуляет отрицательные значения: max(0, x). Без неё сеть линейна.
Dropout случайно отключает часть нейронов при обучении и снижает переобучение.
Softmax превращает выходы в вероятности: кошка — 0,81; собака — 0,14; лиса — 0,05.
Другие слои:
Conv2D — изображения
LSTM/GRU — последовательности
Embedding — токены в векторы
Normalization — стабилизация
Attention — выбор важного
Архитектуру задаёт разработчик, модель обучает веса.
данные → слои → результат
Подробнее:
https://telegra.ph/Kakie-eshchyo-byvayut-nejroseti-07-29
  • 👍 25
  • ❤ 22
  • 🔥 18
  • 🙏 4
Post #93 331
Валентин Малых пишет, что ИИ-агенты начинают отрезать рекламодателей от пользователей. Но меняется не только реклама — меняется вся цепочка продвижения.

Теперь бренд борется не только за клик из поиска, но и за попадание в ответ Алисы AI, ChatGPT или Gemini.

GEO — Generative Engine Optimization — оптимизация бренда под упоминания, цитирование и рекомендации в генеративной выдаче.

Например, Алиса AI формирует ответы на основе результатов поиска Яндекса: выбирает страницы, извлекает факты и показывает ссылки на источники.
В русскоязычной выдаче это могут быть vc.ru, Хабр, Дзен, маркетплейсы, Карты и профильные медиа.

Изменение уже измеряется:
— при появлении AI-ответа переходы на обычную выдачу Google снижаются с 15% до 8%;
— по ссылкам внутри AI-ответа переходят примерно в 1% случаев;
— с быстрыми ответами Алисы AI ежемесячно взаимодействуют 48,3 млн человек;
— Яндекс уже показывает в Вебмастере Share of Voice — долю запросов, в которых Алиса упоминает сайт.

Было:
запрос → поисковая выдача → сайт → реклама → покупка.
Становится:
запрос → ответ ИИ → несколько вариантов → рекомендация → покупка.
SEO не исчезает, но поверх него появляются:
AEO — оптимизация под прямые ответы;
GEO — оптимизация под генеративную выдачу.

Подробнее о GEO и способах попадания в ответы ИИ:
https://telegra.ph/II-menyaet-reklamu-kak-brendam-popadat-v-otvety-Alisy-AI-ChatGPT-i-Gemini-07-28
#ai #geo @valuableai
  • ❤ 29
  • 🔥 18
  • 💯 16
  • 👍 8
  • 😍 2
Post #92 380
🧠 Локальный ИИ в 2026: что запускать на своём компьютере
Свой AI-ассистент без облака, подписок и слежки — реально уже сегодня. Из чего он состоит и что брать под вашу видеокарту.
Локальный ассистент = 3 части:
🔧 Движок — запускает модель (сам файл модели не работает, как mp3 без плеера)
🧠 Модель — отвечает, анализирует, пишет код
🖐 Агент — даёт модели доступ к файлам, IDE и терминалу

⚙️ Движки 
• Ollama — простой старт, локальный API для агентов
• LM Studio — запуск моделей через GUI
• llama.cpp — полный контроль над памятью
• vLLM — серверный inference для команд

🤖 Модели по видеопамяти 
6–8 ГБ → Qwen3 4B / 8B — чат, тексты, простой код 
12–16 ГБ → Qwen3 14B (универсал), DeepSeek-R1-Distill-14B (reasoning) 
24 ГБ → Qwen3-Coder-30B-A3B (код), Qwen3.6-27B (универсал) 
32 ГБ+ → Qwen3.6-35B-A3B; крупные DeepSeek V3/V4, Llama 4 — уже серверные

🔌 Через что работать 
• Cline — coding-агент в VS Code
• OpenCode — агент для терминала и IDE
• Aider — правки через Git и diff
• Open WebUI — локальный чат в стиле ChatGPT

🚀 Готовые связки 
• Ноут/слабая GPU → Ollama + Qwen3 4B/8B
• 12–16 ГБ → Ollama + Qwen3 14B + Open WebUI
• Код на 24 ГБ → Ollama + Qwen3-Coder-30B-A3B + Cline
• Универсал на 24 ГБ → Ollama + Qwen3.6-27B + Open WebUI

💡 Главное правило: 
берите не самую «умную» модель, а самую большую, что влезает в видеокарту целиком. Что свисает на CPU — тормозит адски. И помните: размер файла ≠ потребление VRAM (память ест ещё контекст и KV-cache).
3 козыря локали: 🔒 данные не уходят на сторону · ✈️ офлайн · 💸 ноль подписок

💸 Нет мощной GPU? Арендуй по часам 
Тот же стек можно гонять на арендованной карте. Бюджетный вариант — Vast.ai: для Qwen3-Coder 30B ищите инстанс с RTX 3090/4090/5090 или проф-картой 24+ ГБ. ⚠️ Это уже не локальный запуск — модель на чужом сервере. Не грузите приватные документы, ключи и закрытый код без шифрования и проверки хоста.
🔗 https://cloud.vast.ai/?ref_id=626108 
Подробнее в статье на vc.ru
#AI #нейросети #ollama #localllm #разработка #технологии
Ollama Ollama is the easiest way to automate your work using open models, while keeping your data safe.
  • 👍 35
  • ❤ 21
  • 🔥 20
  • ⚡ 6
  • 😍 1
Post #86 343
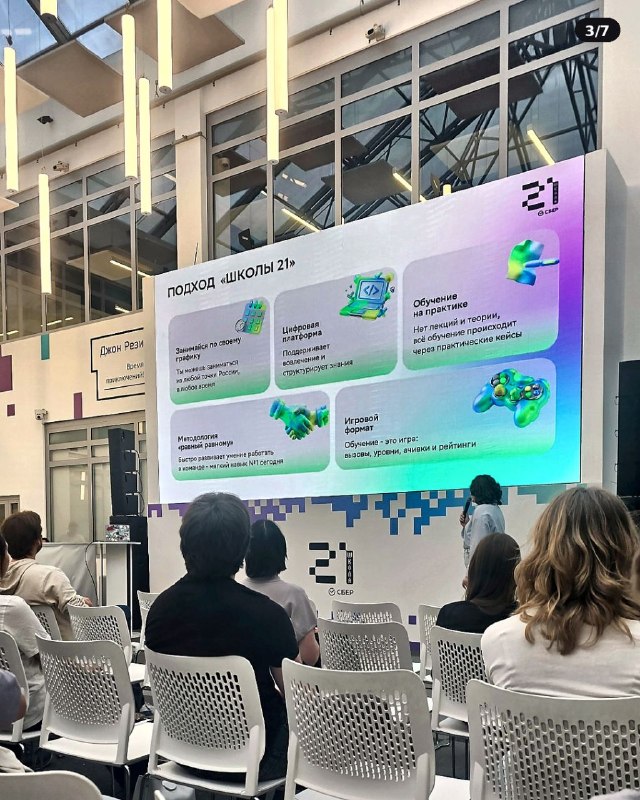
«Школа 21» переходит с C на Python и AI

Побывала на дне открытых дверей «Школы 21».

В этом году стартовую программу обновляют: вместо привычного входа через C участники начнут с Python и будут использовать AI-инструменты уже во время «бассейна».

За 12 дней нужно освоить основы, поработать в команде и собрать цифровой продукт. Лекций по-прежнему нет: обучение строится на практике и peer-to-peer.

Главное изменение — AI становится не подсказкой, а полноценным рабочим инструментом разработчика.

@school21sber @sberbank

#Школа21 #Сбер #Python #AI #Программирование #ITобразование
  • 🔥 14
  • 👍 13
  • 👏 10
  • ❤ 9
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →