


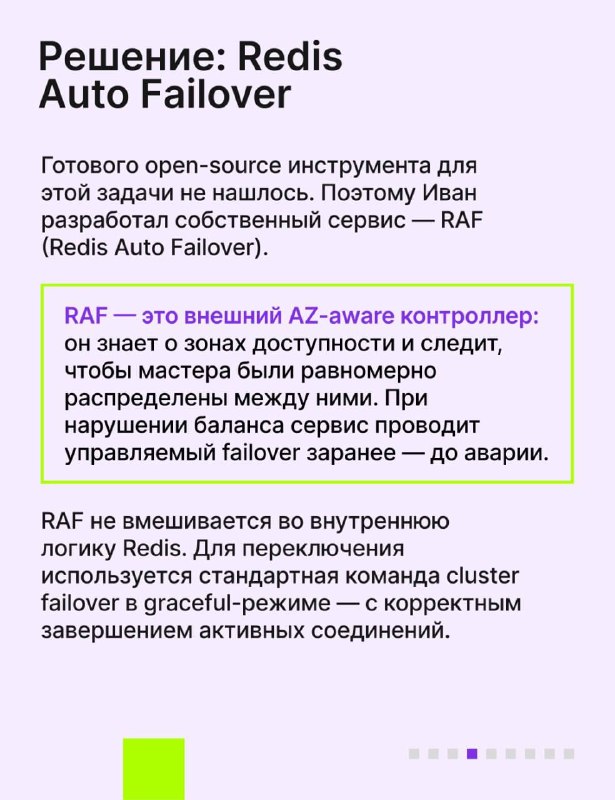



Иван Откидач, DevOps-инженер команды DBA Wildberries & Russ, рассказал, почему Redis Cluster не восстанавливается сам при потере Availability Zone (AZ) — и как самописный сервис RAF закрыл этот архитектурный пробел.
⏹️Что ещё будет в статье?
— Почему multi-AZ-размещение не равно multi-AZ-отказоустойчивости: как кворум мастеров блокирует автоматический failover и при каком распределении нод кластер не сможет восстановиться после потери одной зоны.
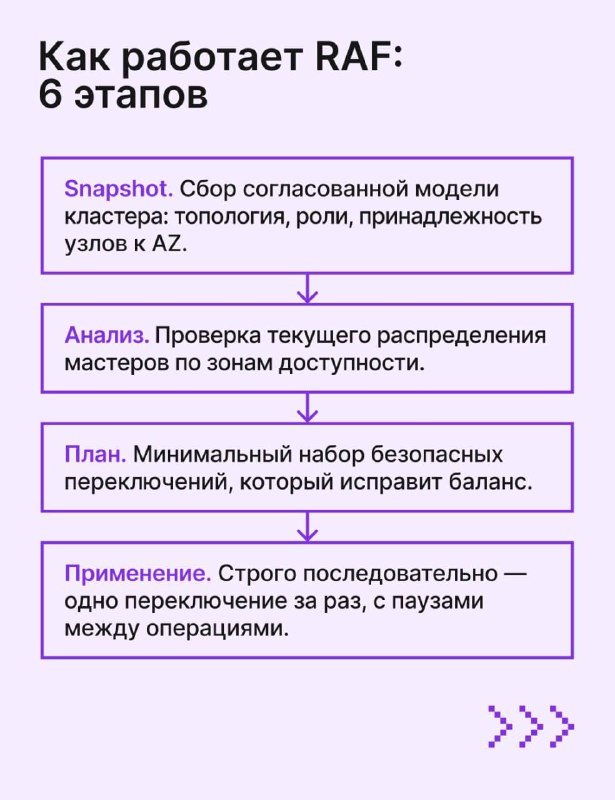
— Архитектура сервиса RAF: как внешний AZ-aware контроллер собирает снимок состояния кластера, строит план безопасных переключений и применяет его последовательно — без вмешательства во внутреннюю логику Redis.
— Побочный эффект управляемых failover: какие клиентские сценарии наиболее чувствительны к переключениям и как с этим работать.
➡️ Читать на Хабре